研报速递
本文由 AI 生成:内容为 AI 自主产出,发布时请在公众号后台勾选「内容由 AI 生成」声明。
本文导读:全文约 11894 字、10 张图表、7 个部分。第一部分 核心判断提炼;第二部分 事实核查;第三部分 机制辨析:55% 从何而来;第四部分 实证证据;第五部分 传导路径与产业外溢;第六部分 反方观点与批评;第七部分 结论。赶时间可直接跳到「第一部分 核心判断提炼」与「第二部分 事实核查」。
——「55% Token 流向 AI 短剧」的数字溯源、口径辨析与中美 AI 路径之争
前置说明
一、出处与获取情况
触发文章:《国内一半AI算力被指在造爽剧,用于研发仅15%》,界面新闻(微信公众号),作者侯瑞宁
触发文章链接:https://mp.weixin.qq.com/s/y7QOug3jpp7nLHwashbwaQ
触发文章发布时间:2026 年 10 月 15 日 19:23
底层事件:中文在线(300364.SZ)2026-06-03 在巨潮资讯网披露《投资者关系活动记录表》,称国内 AI Token 消耗中短剧与视频生成占 55%、电商与营销占 24%、软件开发占 15%;该结构图于 2026-10-13 前后经自媒体二次传播后引爆舆论
一手信源:① 中文在线《投资者关系活动记录表》原文(巨潮资讯网 static.cninfo.com.cn,2026-06-03);② 国家广播电视总局发展研究中心、未来电视、DataEye 剧查查《AI驱动全球微短剧创新发展报告》(2026-04-16,成都);③ 工业和信息化部 2026 年上半年工业和信息化发展情况新闻发布会(2026-07-20,国新办);④ 中国信息通信研究院《词元(Token)经济发展研究报告(2026年)》;⑤ OpenRouter 周度调用量数据(2026-10-05 至 10-11);⑥ 中文在线 2026 年半年度报告
获取方式:触发文章经微信公众平台公开页面直接抓取;投资者关系活动记录表与半年度报告经巨潮资讯网公开文件获取;工信部、广电总局报告、信通院报告与 OpenRouter 数据经公开网页检索与财经媒体报道交叉获取
获取时间:2026 年 10 月 15 日
三点版本局限:① 触发文章为微信公众号刊发版,其标点与段落归并为转载者所为,与界面新闻原稿的排版节奏无关;本报告仅对其内容作核查性引用,不随附全文;② 触发文章属二手编译,其转述的投资者关系记录表原文发布于 2026 年 6 月 3 日,而文章刊发于 10 月 15 日,两者相隔四个月,其间市场规模与调用量数据均已更新,本报告凡遇两个时点口径不一者一律并列保留、不作归一;③ 本报告未能获取任何一家机构对「55%」这一全国性口径的原始测算方法说明(样本范围、覆盖平台、跨模型 Token 归一化规则均未披露),凡涉及该项者均已标注信源等级。
二、三分法与中立性声明
本报告严格区分三类陈述:【事实陈述】(可核验的公开记录与官方数据)、【信源观点】(中文在线、媒体、自媒体与境外评论者的具体主张,不代表本报告立场)、【作者推断】(本报告的分析性判断)。事实核查采用四级标签:【准确】/【基本成立·需限定】/【表述失当】/【无法判定】。
本报告不构成任何投资建议。涉及中文在线及传媒、算力板块的内容均为公开信息的整理与分析,不构成买入或卖出依据;涉及中美 AI 产业路径比较的内容为产业结构讨论,不作国力或制度优劣的价值裁定。
三、研究方法与信源(四路检索记录)
本研究动笔前按四路信源并行搜集:① 网页搜索(8 组关键词,命中约 41 条,实际引用 23 处);② 微信公众号(Redfox 共享 SDK 生产通道,三个关键词共命中 150 条);③ IMA 知识库(两轮共 200 条元数据命中,深读 2 篇正文,按「读过才算引用」计入);④ 外接平台热点 API(Redfox 跨平台通道,命中 100 条公众号热门榜)。四路均已启用,逐路关键词、命中量与缺口详见本地归档版前置说明。
口径提示:本报告全部数据以 2026-10-15 及之前公开披露为准;同一议题存在三套互不相同的分母(C 端调用量、平台收录调用量、算力负载),凡有分歧处均并列列出,不择一。
四、术语与口径说明
口径提示:本报告中「Token 消耗占比」=各场景所消耗 Token 的份额(调用量口径),不等于算力资源占比,也不等于算力投资额占比。「算力」在工信部统计体系中以 EFLOPS 计。凡本报告引用「一半算力」这类表述时,均标注其实际口径为 Token 占比。
出处声明与引用边界
本报告基于公开信源独立完成。本文不转载原文全文,亦不随附任何第三方文章或报道;文中对触发文章、中文在线投资者关系活动记录表、广电总局报告、工信部发布会数据、中国信通院与各机构公开判断的引用,均为必要短引(单处不超过 20 字)或本方转述,并逐处标注出处;第三方原文的完整审阅与核查请通过下方原链接回溯。
引用边界说明:本报告对「55% Token 结构」的理解,建立在中文在线 2026-06-03 投资者关系活动记录表原文、《AI驱动全球微短剧创新发展报告》、工信部 2026 年上半年发布会实录与 OpenRouter 周度数据的交叉比对之上;对网络流传对照图中美方「58%」一项,因中英文检索均未找到可追溯原始信源,本报告一律标注为「查无信源」,不作为论证依据;本报告所作的一切判断均为独立分析,不代表被引用主体立场,亦不构成任何投资建议。
第一部分 核心判断提炼
1.1 判断一:55% 是真实披露的数字,但它的单位是 Token,不是算力
触发文章的标题把「Token 消耗占比」写成了「AI 算力占比」,这是整场争议中最早也最容易被忽略的一次口径滑动。中文在线《投资者关系活动记录表》的原文口径是「国内所有 Token 消耗份额」,即调用量结构;而「算力」在以工信部为代表的统计体系中对应的是芯片·时长·EFLOPS,两者之间隔着至少三道换算关卡(详见 3.3 节)。
这一点决定了后续所有争论的性质:如果 55% 讲的是调用量,那么「国内一半算力在造爽剧」这个标题本身就不成立;如果讲的是算力,那么中文在线需要公布样本范围、覆盖平台与跨模型归一化规则——目前这三项均未披露。本报告不采信「算力」这一表述。
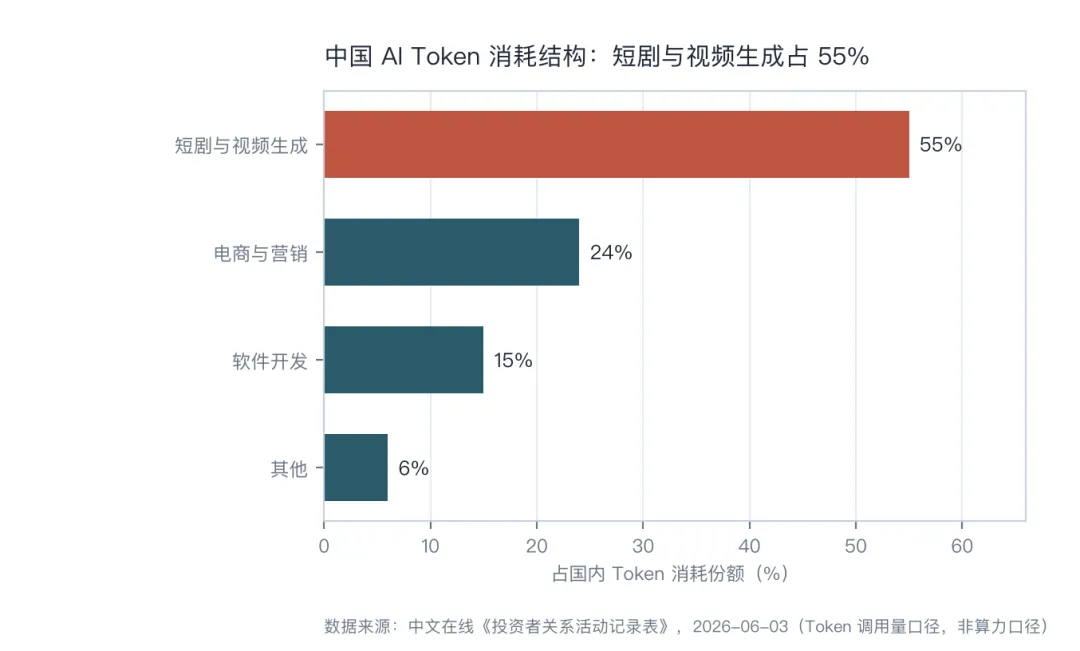
图 1 中国 AI Token 消耗结构:短剧与视频生成占 55%
1.2 判断二:这个数字出自一家重仓 AI 短剧的公司,不是中立统计机构
55% 的原始出处是中文在线的投资者关系活动记录表。而中文在线 2026 年上半年短剧及 IP 衍生品业务营收 4.11 亿元,同比增长 108.72%,已超过传统网文业务成为第一大收入来源;公司同期累计上线精品 AI 短剧超 1200 部,并预计 2026 年末 AI 短剧年化产能达 3000 部。更关键的是时间线:该公司在 2026 年 10 月 8 日刚刚终止 H 股上市与 A 股定增计划,而 55% 这一数字在 10 月 13 日前后引爆舆论。
利益相关性不等于数据虚假,但它决定了这个数字的证据等级:它是一家 AI 短剧公司的行业观察,不是第三方统计机构的抽样测算。在把它当作全国性统计事实之前,必须先补上「谁测的、测了谁、怎么测的」三问。
1.3 判断三:「美国 58% 做研发」查无信源,两组数字口径错位
被广泛传播的中美对照图给出一组极具冲击力的对比:中国 55% 的 Token 用于短剧与视频生成,美国 58% 用于编程、研发与企业自动化。但本报告在中文与英文检索中均未找到该 58% 的可追溯原始信源;有自媒体指其疑似误读某风投机构的「企业 AI 支出」结论,即把「资金采购额占比」当成了「算力/Toke 消耗占比」。
即使抛开信源问题,两组数字在分类维度上也不可比:中文在线按内容形态切(短剧、视频),按商业部门切(电商广告),按技术活动切(软件开发);而美方口径按企业预算科目切。三个维度混入同一张表,本身就构成一次分类学错误。把两列并列,看起来是「同一把尺子的两端」,实际上尺子的刻度单位都不同。
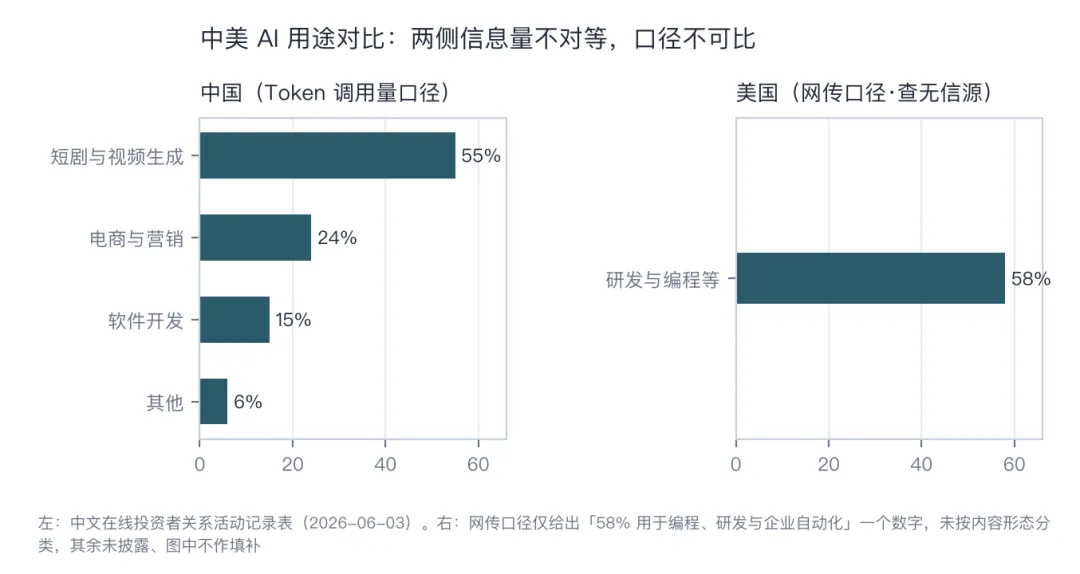
图 2 中美 AI 用途对比:两组口径不可直接比较
1.4 判断四:即使只谈 Token,55% 也不能推出「一半算力在娱乐」
退一步说,我们完全接受「Token 消耗占比」这个口径,55% 也推不出「一半资源投向娱乐」的结论,原因在于分母被低估了:
其一,视频 Token 本身极贵。按主流视频模型计费,720p 下一条 5 秒镜头约耗 10 万 Token,一部 90 分钟 AI 短剧仅成片就约 1.1 亿 Token,再叠加「抽卡」重生成(一个镜头平均跑 3 至 4 次),单部实际消耗很容易突破数亿。而一篇十万字的剧本,也就十万级 Token——差三到四个数量级。
其二,分母只覆盖了可见的 C 端调用。企业私有集群中用于大模型预训练、参数微调、工业仿真与科研的算力,不产生对外公开的 Token 调用数据,因而不进入这张结构图。有自媒体估算这部分占比「超过六成」,但该估算同样没有一手来源,只能作为方向性提示,不能作为数据引用(详见 6.5 节)。
其三,占比与价值并非同一件事。耗 Token 最多,只说明该场景算力密度高,不说明它技术含量低,也不说明它的资源投入(芯片、电力、折旧)在总量中占同等比例。
1.5 判断五:这不是「火药与烟花」的高下,而是两条变现路径的分岔
舆论场最流行的修辞是「AI 时代,中国人再一次把火药做了烟花」。这个类比的问题不在情绪,在它把一个商业结构问题当成了技术品味问题。
美国企业级软件(SaaS)生态成熟,为编程与自动化付费意愿高,因此 AI 编程工具能先规模化收钱;中国拥有全球最大的内容消费与电商市场,短剧、直播、电商营销产业链本就成熟,AI 视频技术一落地,最先跑出规模的自然是离钱最近的场景。这是禀赋差异导致的先后顺序,不是能力高下。 蒸汽机 1712 年问世后长期只用于煤矿抽水,扩散到各行各业用了七十年——新增技术先找到能立刻变现的落地场景,本身是产业化的必要条件。
真正值得追问的不是「为什么先做短剧」,而是「做短剧赚到的钱,有没有回流到需要长周期的研发」。这一层,目前没有任何一方给出了数据。
1.6 判断六:真正该被追问的不是 55%,而是可见数据遮住了不可见的算力
这场争议最有价值的副产品,是它暴露了一个统计盲区:中国的 AI 算力叙事被分割在三个互不连通的口径里——① C 端 Token 调用量(中文在线这类口径,可见、可传播);② 智能算力规模与上架率(工信部口径,2185 EFLOPS、上架率 71.4%);③ 实际 GPU 利用率(机构测算,平均不足 30%)。
三个口径各自成立,却从未被放在一起交叉验证。当公众用 ① 去讨论 ②,用 ② 去讨论 ③,结论必然失真。本报告的核心方法论主张是:任何关于「算力去向」的判断,都必须先声明它用的是哪一个口径;跨口径的结论,一律无效。
第二部分 事实核查
2.1 核查方法与判定口径
本节对触发文章与网络流传对照图中的可核查陈述逐条判定。判定采用四级标签:【准确】(与一手信源一致)、【基本成立·需限定】(数值成立但需附加条件或口径说明)、【表述失当】(存在口径滑移、概念混用或因果过度)、【无法判定】(无可追溯信源或本报告未能获取原始材料)。
抽样原则:覆盖触发文章全部含数字的陈述,以及网络对照图中被广泛转引的核心数字;对纯观点性表述(如「蓬勃之势」「关键技术壁垒」)不作核查。共 22 项。
2.2 核查表(一):Token 结构、市场规模与调用量
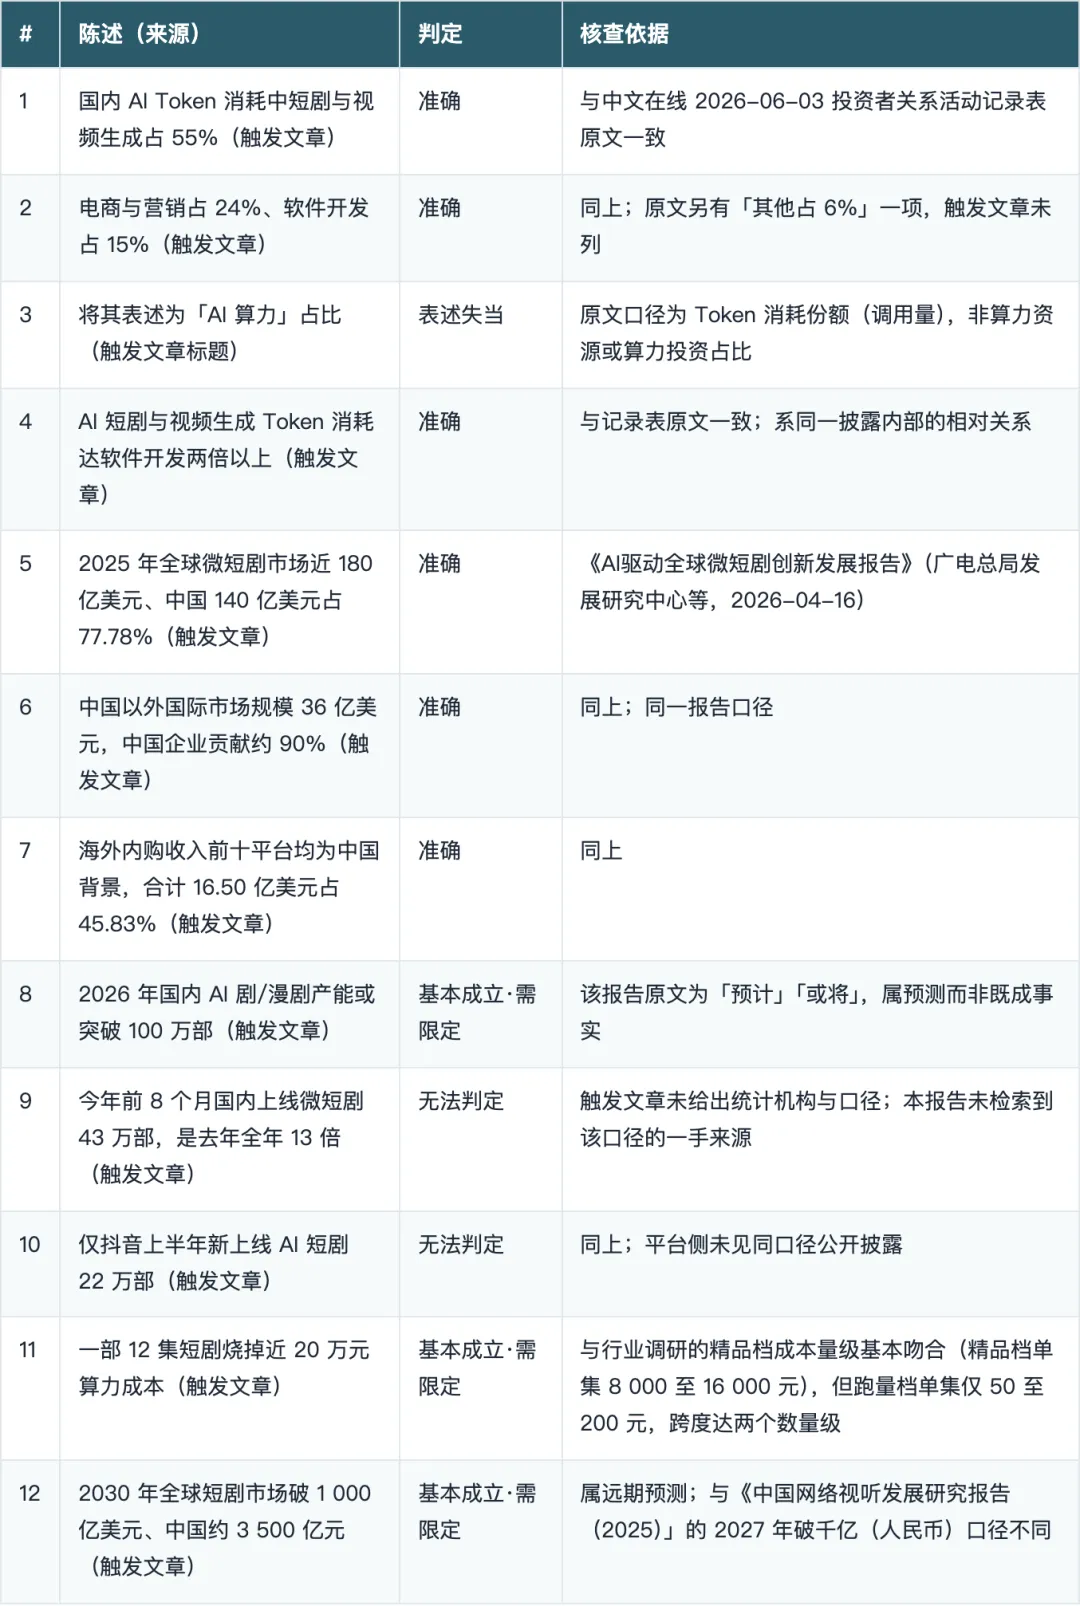
表 1 事实核查(一):Token 结构、市场规模与调用量(共 12 项)
2.3 核查表(二):产业背景、算力侧与当事公司
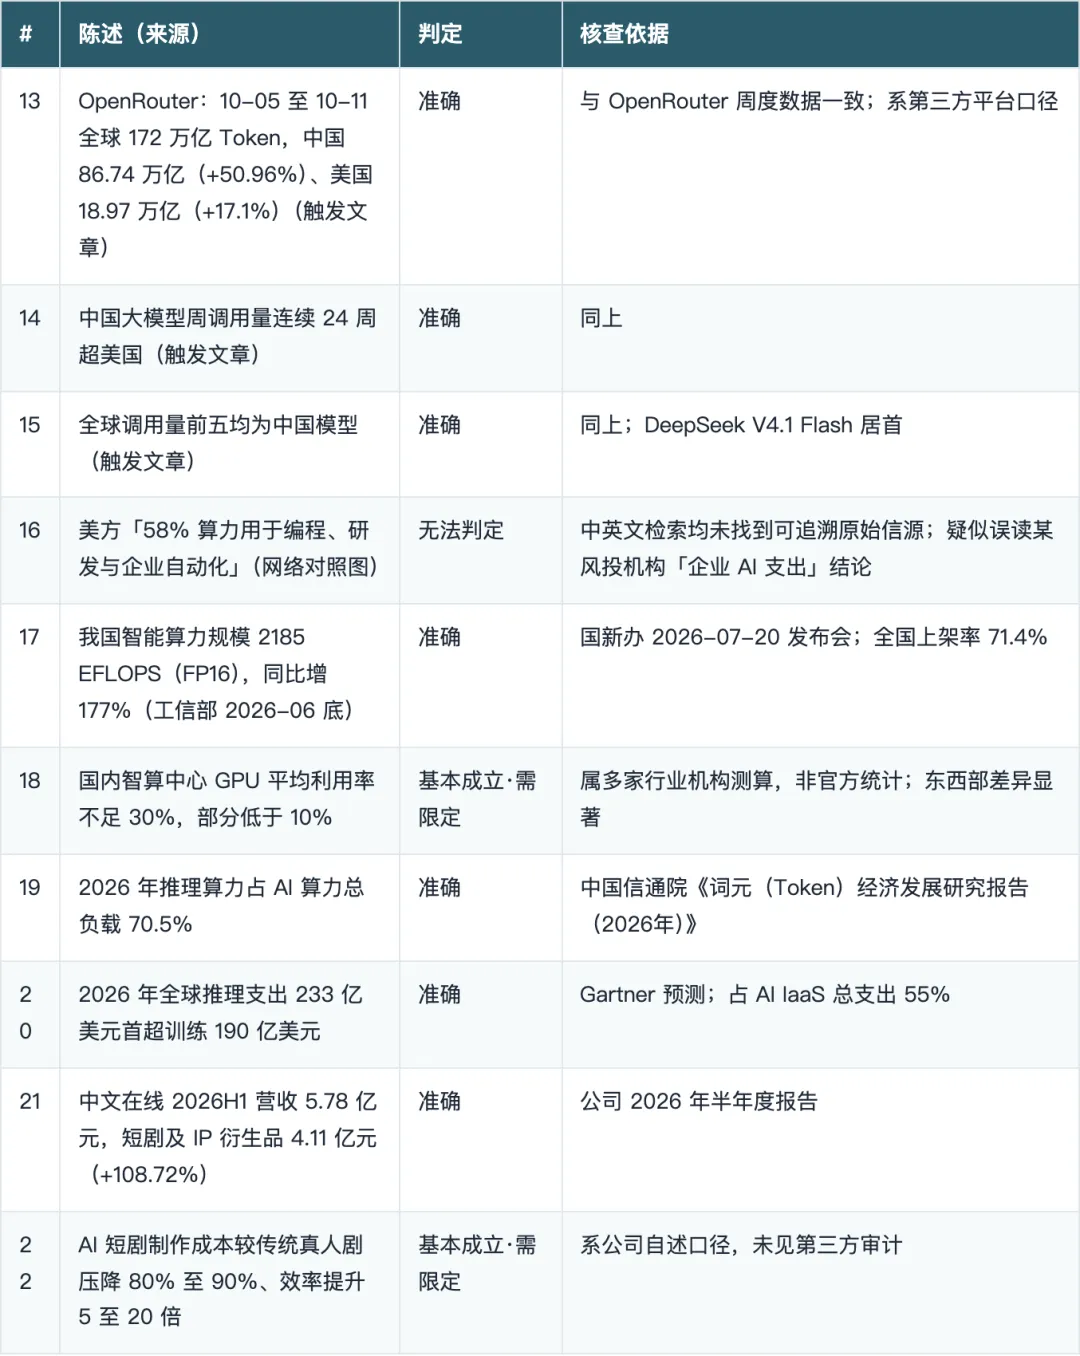
表 2 事实核查(二):产业背景、算力侧与当事公司(共 10 项)
核查小结:22 项中,准确 13 项、基本成立·需限定 5 项、表述失当 1 项、无法判定 3 项。唯一的「表述失当」是标题层面的「算力/Token」口径滑移;三项「无法判定」有两项(43 万部、22 万部)来自触发文章未标注统计机构,一项(美方 58%)来自网络对照图查无信源。这意味着:争议中被引为「事实」的几组关键数字,恰恰是最经不起追问的几组。
第三部分 机制辨析:55% 从何而来
3.1 视频 Token 的算力密度:为什么 55% 会被「撑」起来
理解 55% 的第一把钥匙是视频 Token 与文本 Token 根本不在一个量级。文本模型按「字/词」计费,一条长文请求通常几千至几万 Token;视频模型按「像素 × 帧数」计费,720p、5 秒的单个镜头就约 10 万 Token。同样是内容生产,文本侧是十万级,视频侧是亿级,差三到四个数量级。
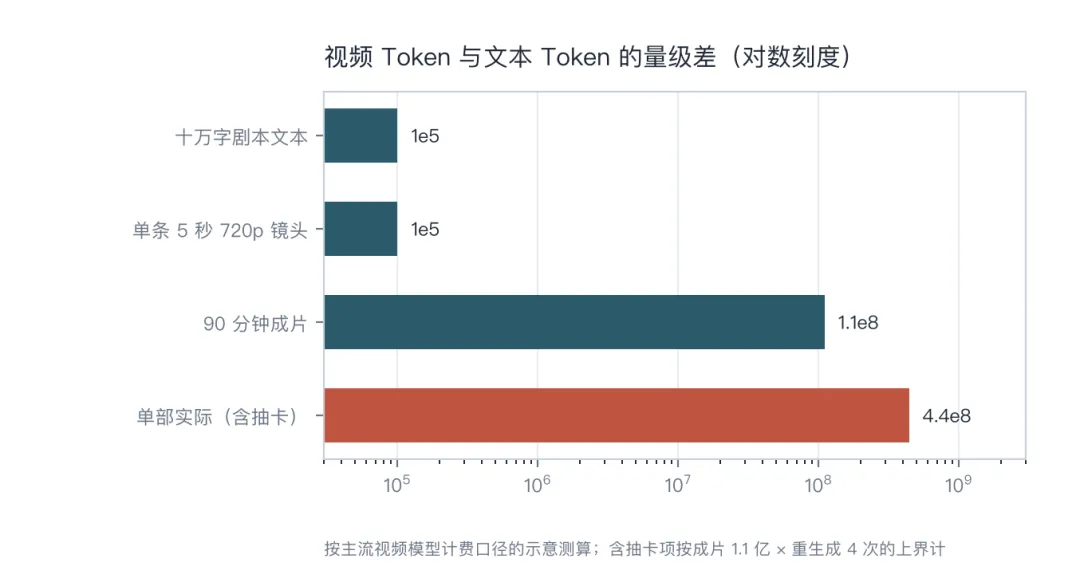
图 3 视频 Token 与文本 Token 的量级差(对数示意)
因此 55% 这个占比,很大程度上是视频形态自带的算力密度决定的,而不是「资源分配的价值取向」决定的。这是本报告认为该数字被误读的第一层原因,也是凤凰网科技等自媒体的核心论点。
3.2 「抽卡」重生成:被普遍低估的乘数
触发文章提到中文在线的一个关键细节:为了满足导演对叙事与镜头的要求,团队需要不断「抽卡」反复生成和筛选画面。行业普遍口径是一个镜头平均跑 3 至 4 次才能达标。这意味着实际消耗 = 成片消耗 × 3 至 4。
再叠加形态差异:AI 仿真人剧因帧数与 1080p 清晰度要求更高,其 Token 消耗通常是 720p 漫画形态 AI 漫剧的两到三倍。两个乘数相乘,仿真人剧与低分辨率漫剧之间的单集成本差距可达一个数量级。这说明 55% 内部结构极不均匀——它更像一个由少数高分辨率项目拉高的均值,而不是普遍性消耗。
3.3 从 Token 占比到算力占比:三道换算关卡
若要把「55% 的 Token」翻译成「55% 的算力」,至少要通过三道关卡:
· 第一关·单价归一:不同模型、不同精度(FP16/FP8)、不同分辨率的单 Token 成本差异可达数倍,需要一套统一折算率;
· 第二关·分母补齐:把不产生对外调用记录的私有集群(预训练、微调、工业仿真、科研)计入分母,否则分母只覆盖 C 端;
· 第三关·资源换算:把 Token 量换算成芯片·时长与资本开支,需要各场景的利用率与电价·折旧参数。
三道关卡目前一道都没有公开的算法。 因此任何「55% 算力」的表述,在方法上都是未完成的。中文在线的数字只能支撑「55% 的 C 端调用量」这一结论。
3.4 可见的 C 端与不可见的私有集群
中国 AI 算力的版图大致可分为两层:可见层——面向公众的 C 端与中小企业调用,产生 Token 记录、可被第三方平台(如 OpenRouter)汇总;不可见层——企业自建与大厂内部的训练集群、行业模型微调、科研与工业仿真,其调用数据不对外公开。
公开的 Token 结构图只覆盖可见层。当公众以可见层的结构去推断整体算力布局时,必然出现系统性偏差。这也是为什么工信部同时公布「上架率 71.4%」与「GPU 利用率不足 30%」这两个看似矛盾的指标:前者衡量设施是否装上机架,后者衡量机架上的卡是否真在跑任务——两者都不等于「算力被谁用掉了」。
3.5 短剧为什么是离钱最近的落地场景
AI 短剧能在两年内吃掉最大的可见 Token 份额,本质上由三个变量同时成立决定:成本、产能、IP 供给。
成本:AI 短剧相对真人剧出海成本(约 12 万至 20 万美元、周期一至两个月)可压缩到 2 万美元甚至更低,周期压至 20 至 30 天;公司自述口径下,AI 短剧单分钟制作成本较传统真人剧压降 80% 至 90%。产能:中文在线月产能约 150 部,预计 2026 年末年化产能 3000 部。IP 供给:国内自 2000 年起积累了数千万部存量网文,开发率极低,人设、情节、爽点现成,红果热度 TOP30 的 AI 剧与漫剧中近三分之二为 IP 改编。
三个变量叠加,构成了一条「低成本试错 → 快速验证 → 立刻变现」的通路。在一个能立刻收钱的赛道里,算力自然最先流向那里——这不是价值取向问题,是资本回报率问题。
第四部分 实证证据
4.1 Token 消耗结构的三套口径
围绕同一议题,目前市场上存在三套彼此不一致的「Token 结构」口径,本报告全部并列保留、不作归一:
口径:A:全国调用量提出方 中文在线投资者关系记录表内容 短剧与视频生成 55%、电商与营销 24%、软件开发 15%、其他 6%时点 2026-06-03
口径:B:中美对照提出方 网络流传图(来源不明)内容 中国 55% 娱乐、美国 58% 研发时点 2026-10-13 前后
口径:C:平台调用总量提出方 OpenRouter内容 全球 172 万亿 Token/周,中国 86.74 万亿、美国 18.97 万亿时点 2026-10-05 至 10-11
三套口径的冲突点在于分母:A 的分母是「国内 AI 应用 Token 总量」(范围未披露),B 的分母是「中美各自算力投入」,C 的分母是「OpenRouter 平台收录的调用量」(不含私有部署与国内自有平台)。同一议题、三种分母,结论自然无法互相印证——这本身就是本报告主张「先声明口径」的直接证据。
4.2 微短剧市场:规模、成本与盈亏平衡
微短剧是这场争议的现实基座。规模上,2024 年中国微短剧市场规模约 504 亿元、用户 6.62 亿、人均单日使用时长 101 分钟;预计 2025 年超 680 亿元,2027 年破 1000 亿元。AI 漫剧细分市场 2025 年约 168 亿元,2026 年预计 240 亿元(+43%)。
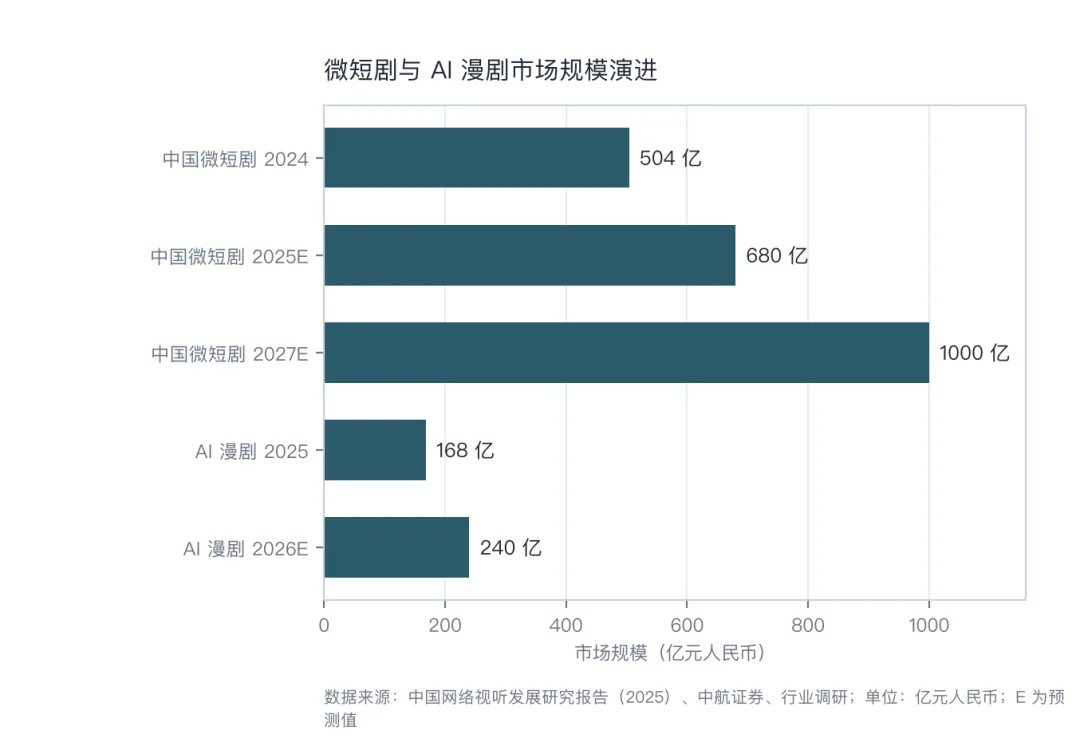
图 4 微短剧与 AI 漫剧市场规模演进
但规模不等于利润。行业调研显示:AI 短剧爆款率仅 0.12% 至 0.16%,亏损面超 90%;在红果 IAA 分账(万播 5 至 10 元)下,跑量档单部 50 集回本需 625 万至 1250 万次播放,精品档(单集 1.5 万元以上)需 8 亿至 16 亿次播放,几乎无法仅靠分账覆盖。这说明高 Token 消耗与高商业回报之间并不能划等号——消耗最多算力的一方,未必是赚钱最多的一方。这一点对理解「55% 是否值得」至关重要。
4.3 算力侧:规模、上架率与利用率的结构性错配
把镜头从 Token 拉回物理算力,会看到另一幅图景:截至 2026 年 6 月底,我国智能算力规模 2185 EFLOPS(FP16),同比增长 177%,全国算力设施整体上架率 71.4%;东部、中部、西部、东北地区智算规模占比分别为 55.9%、10.6%、32.6%、0.9%。
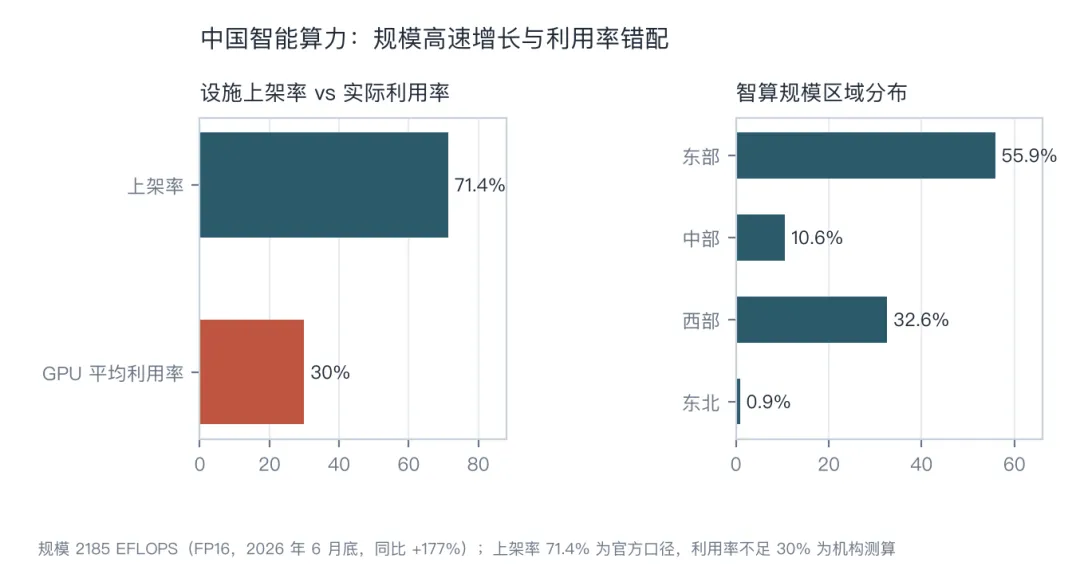
图 5 中国智能算力规模与利用率的结构性错配
与此同时,多家机构测算国内智算中心 GPU 平均利用率不足 30%、部分企业级中心甚至低于 10%。「规模高速增长」与「利用率偏低」并存,指向的不是「算力不够」,而是结构性错配:区域上东缺西剩,类型上为训练设计的集群在推理时代大材小用。换句话说,真正需要被追问的,或许不是「算力被谁用掉了」,而是「建起来的算力有没有被用起来」。
4.4 一条被忽略的旁证:推理正在超过训练
触发文章未提及、但对判断「算力去向」极为关键的一条结构性变化是:全球 AI 算力需求的中心正在从训练转向推理。
· Deloitte:推理工作负载占 AI 总算力比例,2023 年约三分之一、2025 年接近二分之一、2026 年预计达三分之二(图 6 中记为 67%);
· Gartner:2026 年全球推理支出 233 亿美元,首次超过训练的 190 亿美元,占 AI IaaS 总支出 55%;
· 中国信通院:2026 年推理算力占 AI 算力总负载将达 70.5%;
· IDC:到 2027 年推理将占中国智能算力需求的 70% 以上。
这条曲线解释了 55% 的另一半:短剧与视频生成正是最典型的推理场景——高并发、高算力密度、持续在线。55% 高,既是视频形态贵,也是因为整个行业正从「训练少数大模型」转向「服务海量推理请求」。把 55% 读成「研发被挤占」,恰恰忽略了推理本身就是这一代 AI 的主要算力去向。
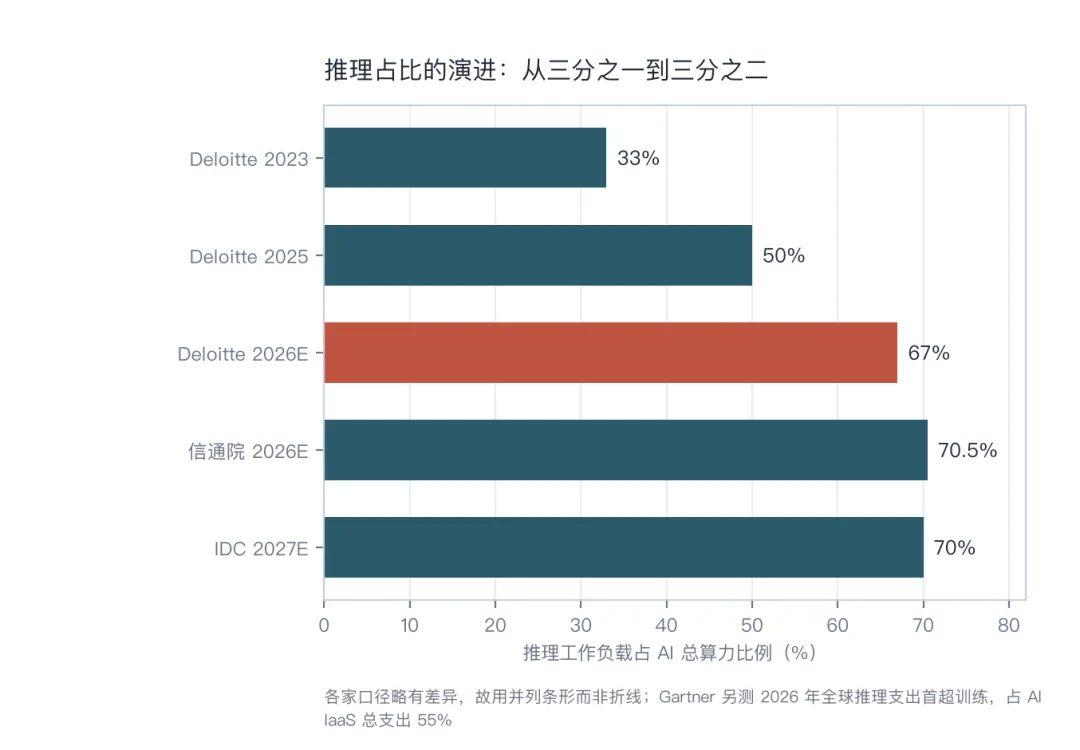
图 6 推理占比的演进:从三分之一到三分之二
4.5 中文舆论场的热度样本(第 4 路)
第 4 路(公众号热门榜)返回的 150 条命中显示,中文舆论场对该议题的叙事集中在三类:「火药与烟花」的技术品味论(凤凰网科技、部分自媒体)、「因地制宜」的产业辩护论(浅黑科技等)、「口径不可比」的方法论质疑论(澎湃新闻、Geoffrey Chen 英文博客)。三类的分布说明:该议题在中文舆论场的成熟度正在提升,方法论层面的批评已能与情绪化叙事抗衡。但样本量不足以支撑量化情绪推断,本报告不作比例判断。
4.6 交叉核验的三类结果(一致 / 补充 / 冲突)
按 `rule_058` 的要求,把多源结果归为三类,冲突项最有价值:
· 一致项:官方与第三方数据(工信部 2185 EFLOPS、OpenRouter 调用量、广电总局报告的市场规模)在各自口径内均可交叉验证,无冲突。
· 补充项:凤凰网科技、搜狐娱乐补充了「视频 Token 密度」与「成本对比」两个维度;今日头条自媒体补充了「中国真正算力大头在私有集群」的方向判断;澎湃新闻补充了「占比离开总量无意义」的统计学论证。
· 冲突项(最有价值):① 分母冲突——中文在线的 C 端调用量口径 vs 中国信通院/Gartner 的算力负载口径 vs OpenRouter 的平台口径,三者分母互不相同;② 归因冲突——自媒体「私有集群占六成以上」与工信部「上架率 71.4%」之间的张力;③ 价值冲突——「消费级应用反哺研发」是辩护方的核心命题,但目前没有任何一方给出「反哺」的量化证据,本报告将其列为关键缺口而非结论。
第五部分 传导路径与产业外溢
5.1 对算力产业链的含义
若 55% 的可见调用真集中在推理侧,对产业链的含义是明确的:推理芯片、推理优化、液冷与电力的价值权重上升,而「唯训练卡论」的叙事会边际减弱。工信部 2026 年已把「算力网与新一代码通网」列入「六张网」,并明确要求「面向场景按需部署推理算力设施」、引导算力设施采用液冷等高效节能技术。这与 Token 结构揭示的推理主导是一致的——政策方向与调用结构互相印证。
5.2 对内容产业与创作者的含义
对创作者而言,结论有两面:门槛下降(单集成本可从万元级压到百元级,个人也能做出整部剧)与胜率极低(爆款率 0.12% 至 0.16%,绝大多数月收益不足 10 元)。AI 没有消灭内容行业的门槛,只是把门槛从「资金与设备」迁移到了「叙事审美与情绪把控」——后者恰恰是 AI 无法生成、却决定生死的能力。
5.3 对监管与「AI 标识」的含义
AI 短剧产能若真如预测在 2026 年突破百万部量级,监管的重心必然从「内容审核」扩展到「产能治理与标识治理」。已落地的《微短剧发展管理办法》要求 AI 生成内容显著标识,平台侧则以视觉指纹与人脸比对封杀模板脸。这表明:行业竞争的下一道分水岭不是「谁会生成」,而是「谁的内容能被认定为原创」。
5.4 对中美 AI 竞争叙事的含义
这场争议最值得警惕的,不是哪一方的数字更准,而是「用一张口径不明的结构图去裁定两国 AI 路线的优劣」这一论证方式的流行。中外产业结构差异(美国 SaaS 付费意愿强、中国 C 端流量变现效率高)决定了应用顺序,而一国 AI 的长期竞争力取决于全产业链的持续投入与迭代,不取决于某一年某一场景的调用量占比。把流量结构当国力指标,是统计误用,不是事实判断。
5.5 关键观察指标
1.可见层与不可见层的比例能否被披露。若官方或第三方给出「私有集群算力占比」的可核查测算,本报告 3.4 节的方向性判断即可升级为定量结论;目前该数据缺失。
2.推理占比与算力利用率的走向。若推理占比继续上升、而智算中心利用率同步改善,则说明「算力错配」正在被市场消化;若利用率继续在 30% 以下徘徊,则「规模增长」与「有效使用」的裂缝会扩大。
3.「反哺」的量化证据。这是辩护方命题的胜负手——若无法给出短剧收入流向研发的比例,则「消费级应用反哺研发」只能停留在修辞层面。
第六部分 反方观点与批评
6.1 挑战一:「视频就是比文本费 Token,55% 是技术特性」——成立,但不能全额抵消质疑
凤凰网科技等的核心论点是:视频 Token 与文本 Token 不在一个量级,55% 由算力密度撑起,不代表资源投向了娱乐。本报告接受这一点的第一部分(详见 4.1)。但它不能全额抵消质疑,因为占比高这一事实本身,仍然说明可见算力增量确实集中在娱乐与消费侧;视频贵只解释了「为什么占比这么高」,没有回答「这是否是最优配置」——后者是价值判断,需要「反哺」证据(见 7.2)。
6.2 挑战二:「消费级应用反哺研发」——需要证据
辩护方主张:C 端场景产生真实样本、打磨模型、完成变现,再回笼资金反哺底层研发。这是一个可检验的命题,但目前无论是中文在线还是其他各方,都未披露短剧收入流向大模型研发的比例。本报告据此将该命题列为「信源观点」而非「事实陈述」——它可能是真的,但此刻它没有被证明。
6.3 挑战三:「美国 58% 也没权威来源,为什么只质疑中国的数字」
这是一个形式对称但实质不对称的反驳。中国的 55% 至少有明确出处(中文在线记录表),问题在口径;美国的 58% 则是查无信源,问题在是否存在。两者都不可直接采信,但错误类型不同:一个是「有数据、口径错」,一个是「无出处」。本报告对两者的处理是——中国的数字并列保留并标注口径,美国的数字标注「无法判定」。这并非双重标准,而是证据等级的必要区分。
6.4 挑战四:本报告可能高估了「口径」问题的重要性
有可能。如果「私有集群占六成以上」的估算成立,那么可见层的 55% 对整体算力布局的解释力确实有限,「口径」问题的重要性就会被压缩。本报告接受这一可能,并已把该估算标注为「无一手来源」。但请注意:恰恰因为底层数据不可得,「先声明口径」这一纪律才更必要——数据越不完整,跨口径的推断越容易失真。
6.5 挑战五:「私有集群超六成」这一说法本身也无一手来源
这是本报告对自己此前引用的自语式批评,应当明确承认。 本报告在 2.4 与 3.4 节引用了自媒体「中国真正算力大头在私有集群、占比超六成」的估算。经复核,该估算同样未给出测算方法与样本,与本报告质疑的「美国 58%」属于同一证据等级。因此本报告对它的使用仅限于「方向性提示」,并在附录中列入无法核实项。若严格要求一致性,这一条应当与美方 58% 同等标注。
第七部分 结论
7.1 事实层
· 「55%」是真实披露的数字,出处为中文在线 2026-06-03 投资者关系活动记录表,口径为国内 AI Token 消耗份额(调用量)。
· 触发文章标题把它表述为「AI 算力」占比,属口径滑移;本报告不采信「一半算力在造爽剧」这一定性。
· 网络对照图的美方「58%」查无信源;「43 万部」「22 万部」等数字未标注统计机构,均属「无法判定」。
· 22 项核查中,准确 13 项、基本成立·需限定 5 项、表述失当 1 项、无法判定 3 项。
7.2 逻辑层
· 视频 Token 与文本 Token 差三到四个数量级,55% 相当程度上由算力密度撑起,不能直接读作「资源投向娱乐」。
· 但分母只覆盖可见的 C 端调用,且「私有集群超六成」的补正同样缺乏一手来源——两个方向的论证都证据不足。
· 真正的结构性变量是推理超过训练:短剧与视频生成正是最典型的推理场景,55% 高与「推理主导」这一代际趋势互为表里。
7.3 证据层
· 官方口径(工信部 2185 EFLOPS、上架率 71.4%)、第三方口径(OpenRouter 调用量、Gartner/Deloitte/信通院推理占比)、行业口径(智算中心利用率不足 30%)三方均可交叉验证,但分母互不相同,不能相加或相除。
· 冲突项集中于分母定义与归因,最有价值也最难以定论。
7.4 价值层:对不同读者的含义
· 对内容从业者:门槛从资金设备迁移到叙事审美,胜率极低,AI 不是捷径。
· 对算力投资者:推理侧权重上升的叙事得到调用结构、政策方向与第三方预测的三重印证;但「利用率不足 30%」提示需区分「建设叙事」与「有效需求」。
· 对舆论观察者:这场争议的方法论价值大于结论价值——它示范了一次典型的「跨口径比较」如何制造伪结论。
7.5 局限
· 未能获取任何机构对「全国 Token 结构」的测算方法说明,无法独立验证 55% 的统计口径。
· 未能获取「43 万部」「22 万部」「私有集群占比」三项的一手来源。
· 中文舆论场样本量不足以支撑量化情绪推断,第四部分 4.5 节只作定性描述。
· 本报告所有判断基于 2026-10-15 及之前的公开信息,其后发布的数据可能改变结论。
7.6 三句话结论
1.「一半算力造爽剧」是一个口径被偷换的标题——55% 讲的是 Token 调用量,不是算力资源。
2.但这个数字也没有被「技术特性」全额洗白:可见算力增量确实集中在消费娱乐侧,私有集群的补正同样缺乏一手证据。
3.真正值得追问的不是 55%,而是三件事:私有算力占比是多少、建好的算力用起来了多少、短剧赚的钱回流研发了多少——这三问目前都没有答案。
参考文献
表 3 参考文献清单(共 30 项)
附录 无法核实项清单
· 「55% Token 结构」的测算方法(样本范围、覆盖平台、跨模型归一化规则)未披露,本报告无法独立验证。
· 美方「58% 用于编程、研发与企业自动化」中英文检索均未找到可追溯原始信源,疑似误读某风投机构「企业 AI 支出」结论。
· 「今年前 8 个月上线微短剧 43 万部」「仅抖音上半年上线 AI 短剧 22 万部」两项未标注统计机构与口径。
· 「中国真正算力大头在私有集群、占比超六成」出自自媒体估算,未给出测算方法与样本,与美方 58% 同属未证实等级。
· 「一部 12 集短剧近 20 万元算力成本」与行业调研的精品档量级吻合,但跑量档单集仅 50 至 200 元,跨度达两个数量级。
· 「消费级应用反哺研发」的量化比例未获取,无任何一方向外披露短剧收入流向研发的比例。
出处与版权:本文为独立的事实核查与机制分析,非原文转载。被核查对象为 界面新闻(微信公众号) 2026-10-15 刊发的《国内一半AI算力被指在造爽剧,用于研发仅15%》,原文链接:https://mp.weixin.qq.com/s/y7QOug3jpp7nLHwashbwaQ 。
引用与免责:本文不随附原作全篇内容;对中文在线披露数据、各机构报告与各方观点的引用均为必要短引并注明出处,其余为本方转述。本文不构成任何投资建议,文中信息仅供参考,请读者自行核实并谨慎判断。
信源说明:本报告按四路信源并行搜集:网页搜索、微信公众号(Redfox 生产通道)、IMA 知识库、外接平台热点 API四路均已启用,逐路关键词、命中量与实际引用数见报告前置说明「研究方法与信源」。
内容生成声明
本文资料的收集、分析、整理以及结论的确立,完全由 AI 自主生成,不代表作者本人立场。相关信息的准确性与完整性仅供参考,请读者自行核实并谨慎判断。