
 研报速递
报告解读 · 数据要素
数据智能体是什么?
一份权威报告讲透
本文系统解读《数据智能体研究报告(2026)》:定义辨析、四大类十二形态、L0—L5成熟度模型、真实落地案例与三大挑战。
📦 6 Parts + Conclusion
👉 滑动
PART 01
五个数字看大势
供给与需求
PART 02
它到底是什么
对比四种工具
PART 03
十二个"岗位"
全链路图谱
PART 04
L0到L5
能力成熟度
PART 05
真金白银
三个落地案例
PART 06
三个坑
挑战与红线
PART ///
政策窗口
已经打开
这一年,你大概听了上百场"智能体"分享。展会上、总裁群里、甲方汇报PPT里,人人都在说自己"落地了智能体"。
但你去看演示——十有八九是问答客服、写周报、生成海报。让它真正碰一碰企业的数据:取个数、修一批脏数据、审一遍合规——大多当场卡壳。
热闹是聊天的,干活是另一回事。
最近,中国互联网协会人工智能工作委员会和中国信通院联合发布了《数据智能体研究报告(2026)》(杭州数美科技参与编制)。这份报告点破了被多数热闹掩盖的一件事:智能体真正的产业落地主战场,不在对话框里,在数据里。
01
PART
五个数字,先看懂大势
DATA IN NUMBERS
报告开篇甩出一组数据,值得每个做数字政府和数据要素业务的人存下来:
• 我国数字经济核心产业增加值占GDP比重已突破10.5%;
• 2025年全国数据生产总量突破50个ZB(泽字节),数据资源规模全球第一;
• 累计建成高质量数据集超10万个,总规模达890PB;
• AI训练和推理所用数据总量达199.48EB,比上年增长42.86%;
• 其中推理数据量以101.34EB的规模,首次超过训练数据量。
最后一个数字最有意思:推理超过训练,意味着AI已经从"上学"进入"上班"——社会对AI的调用,第一次以干活的形态压过了学习的形态。
但矛盾也在这里。中国的数据规模全球第一,数据却大量躺在仓库里睡大觉。报告把病根总结为四条,条条扎心:
供给不足——多源异构数据的采集、加工、标注全靠人工,海量原始数据变不成标准化资产;流通不畅——数据碎片化、孤岛化,跨部门对接靠人肉,供需匹配靠运气;应用不深——分析依赖预设规则,响应慢、挖得浅,业务等不起;安全不力——质量管控和合规审核靠事后人工核查,风险发现永远慢一步。
一句话:传统的数据利用体系是"人工规则驱动"的,而数据规模和实时性要求早就把它压垮了。
02
PART
数据智能体到底是什么?一个词:数字员工
WHAT IS A DATA AGENT
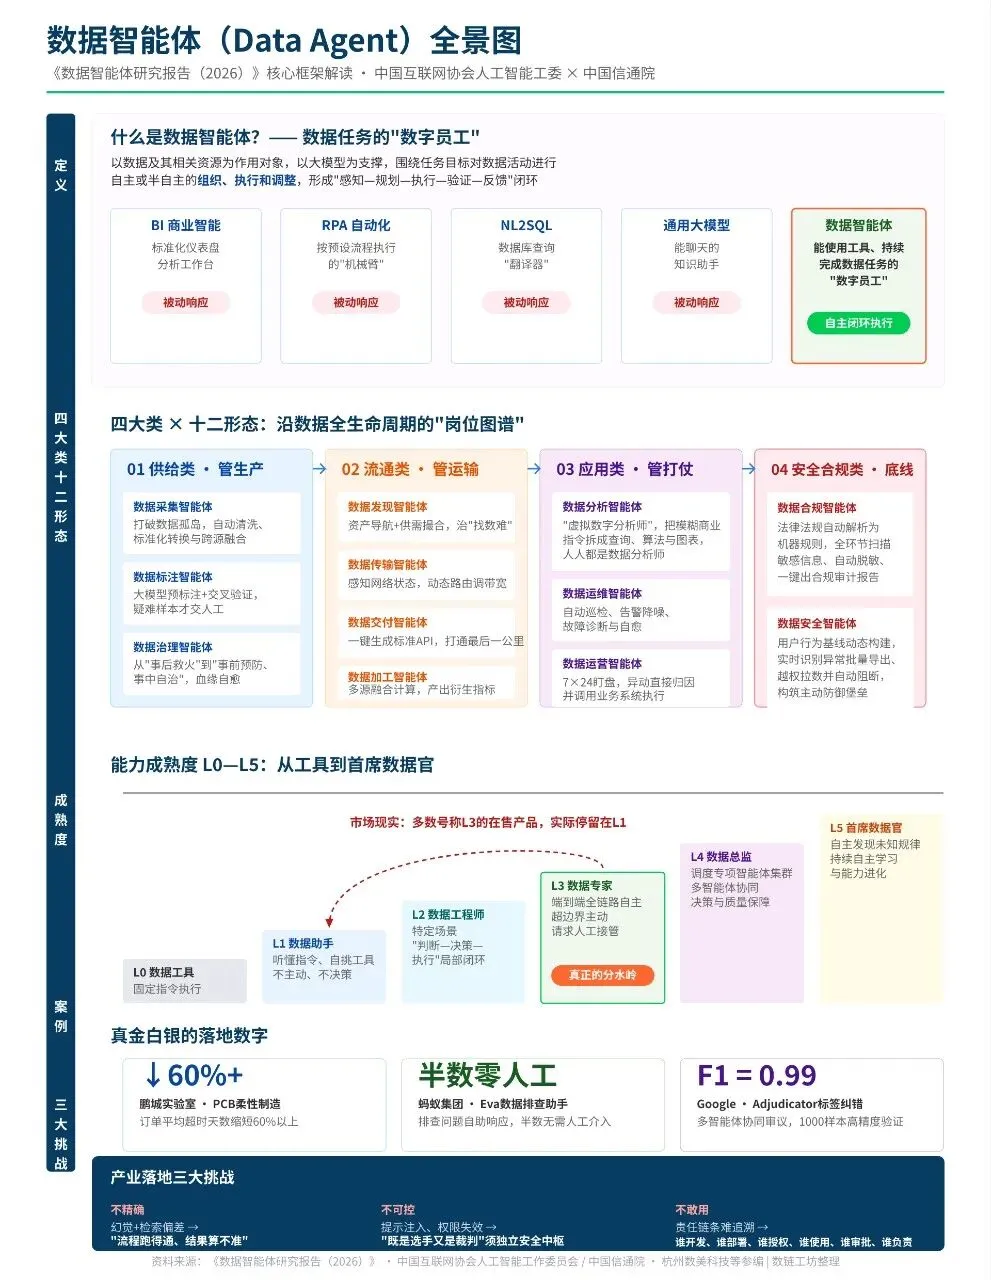
报告给了官方定义——数据智能体(Data Agent):以数据及其相关资源为作用对象,面向数据生命周期中的一个或多个具体任务,以大语言模型等基础模型为技术支撑,能够围绕任务目标对数据活动进行自主或半自主的组织、执行和调整。
定义太长记不住没关系,报告里那张对比表才是精华。它把市面上所有"沾数据的工具"摆在一起比:
差别在哪?前四种都是被动响应:BI等你选维度,RPA等你配流程,翻译器等你问对问题,大模型等你写好提示词。只有数据智能体形成了「感知—规划—执行—验证—反馈」的完整闭环:它自己扫描全域数据资产、自己把业务黑话翻译成表结构和计算口径、自己把大目标拆成任务图(DAG)、自己写SQL和代码调用工具、结果不对自己重试和修复、超出权限自己喊人接管。
报告归纳了六项核心能力:数据环境感知、业务指令理解、任务拆解编排、工具调用处理、分析推理、经验驱动的自主进化。翻译成大白话:它像一个真的入职了的员工——认得家里的账,听得懂人话,会拆活儿,会用工具,算得清账,还会积累经验。
03
PART
十二个"岗位",一条数据链全包了
FOUR CATEGORIES, TWELVE FORMS
报告把数据智能体按数据要素全生命周期分成四大类、十二个细分形态。这张清单几乎就是一部"数据打工地图鉴":
供给类(管生产)——采集智能体打破数据孤岛、自动清洗;标注智能体用大模型预标注,只把高价值疑难样本留给人工;治理智能体把数据治理从"事后救火"变成"事前预防、事中自治",自动盘点黑盒资产、逆向解析血缘、自动修复脏数据。
流通类(管运输)——发现智能体解决"找数难、认数难",做数据资产的导航员和撮合者;传输智能体感知全网状态、动态路由调带宽;交付智能体一键生成标准化数据API,打通"最后一公里";加工智能体听懂业务需求,自主规划多源融合计算,产出衍生指标和特征数据集。
应用类(管打仗)——分析智能体是"虚拟数字分析师",把模糊的商业指令拆成查询、算法和图表,号称"人人都是数据分析师";运维智能体自动巡检、告警降噪、故障自愈;运营智能体7×24盯盘,发现异动直接归因并调用业务系统执行。
安全合规类(管底线)——合规智能体把法律法规自动解析成机器规则,全环节扫描敏感信息、自动脱敏、一键出合规审计报告;安全智能体给用户建行为基线,实时识别异常批量导出、越权拉数并自动阻断。
四类十二种,沿数据"生产—流通—应用—保障"的链路各司其职。这份图谱的价值在于:它说明数据智能体不是又一个单点工具,而是对整个数据要素利用链路的岗位级重构。
04
PART
L0到L5:从工具到首席数据官的进阶路
L0-L5 MATURITY MODEL
报告最有讨论价值的,是这套能力成熟度模型——给每个等级配了一个职衔:
• L0 数据工具:固定指令执行,静态ETL脚本、固定报表,干啥都要人定好;
• L1 数据助手:听得懂明确指令,会自己挑工具干活,但不主动、不决策;
• L2 数据工程师:在特定场景里能"判断—决策—执行"闭环,比如质检出问题自己选修复方案;
• L3 数据专家:端到端全链路自主,超边界主动请求人工接管;
• L4 数据总监:调度一群专项智能体协同作战,多智能体集群的老大;
• L5 首席数据官:自主发现未知规律,自己进化打法。
对照这个尺子量一量市场上在售的"智能体产品",你会发现一个尴尬的事实:绝大多数号称L3的产品,实际停留在L1——能对话、能查数,但离"自主闭环干活"还差两级。
L3是真正的分水岭:到这一步,智能体才开始替代"岗位"而不是辅助"人手"。而L4往上的多智能体协同,报告点明是未来架构主流——这也是为什么通信协议(MCP、A2A这些)突然成了行业显学。
05
PART
不是科幻,是真金白银的数字
REAL CASES, REAL NUMBERS
科普到这儿,你可能觉得概念漂亮。那看报告里三个落地案例,数字都是实打实的:
鹏城实验室把数据智能体用在PCB柔性制造上——多品种小批量生产,工艺数据分散、设备数据异构、老师傅经验难传承。上系统之后:订单平均超时天数缩短60%以上,瓶颈工序滞留时间缩短5%以上。
蚂蚁集团的Eva数据问题排查助手,专治大数据平台的老疑难:任一加工环节出问题,人工要逆向穿透3到5层血缘去查。落地后大部分排查类问题由智能体自助响应,其中半数不经任何人工介入直接处理完毕。同期蚂蚁的数据标注智能体助手,让人工标注工时明显缩减。
Google团队的Adjudicator系统,用"大模型+动态知识图谱+多智能体投票"来纠正标签噪声,在1000条平衡测试样本上拿到0.99的F1值——多智能体交叉验证在精度上的上限,被探出来了一次。
三个案例对应三种场景:工业、平台运维、数据生产。共同点是:智能体都没有"取代人",而是接管了重复劳动,把人的判断力留给规则制定、疑难审核和最终把关。
06
PART
三个坑:不精确、不可控、不敢用
THREE CORE CHALLENGES
报告没有报喜不报忧,反而把落地挑战总结得相当狠辣——三个"不":
不精确。大模型内生幻觉加上RAG检索精度不足,复杂场景因果推理断层,最后变成"流程跑得通、结果算不准"——这八个字,估计扎了不少POC项目的心。跑通demo容易,算准账难。
不可控。自然语言交互把攻击面撑大了:提示词注入可以绕过安全防御,诱导智能体删库、篡改数据、窃取机密;多智能体集群一上规模,传统静态权限管控直接失效。报告一句话点破传统设计的老底:"决策与安全同体、既是选手又是裁判"——所以这份报告的参考架构里,安全控制模块被刻意设计成独立于主决策逻辑之外的一条中枢。
不敢用。出了错——错误分析、越权调用、数据泄露、业务损失——责任算谁的?模型方、建设方、数据方、使用人还是审批人?目前没有统一认定规则。报告开出的药方是先把十六个字立起来:"谁开发、谁部署、谁授权、谁使用、谁审批、谁负责",重大事项保留人工确认与接管,全过程留痕可追溯。
这三个坑解释了为什么"数据智能体"比"聊天智能体"难得多:聊天错了重说一句,数据错了是生产事故。也是为什么政务、金融这些对数据敏感的领域,报告明确指向独立部署、数据不出域的模式。
///
LAST
政策窗口已经打开
POLICY WINDOW
最后看时间线。2026年,政策层面已经密集落子:国务院《关于推进服务业扩能提质的意见》明确支持采购大模型与智能体服务;工信部、国家数据局启动"模数共振"行动,点名打造"特色智能体";网信办等三部门印发《智能体规范应用与创新发展实施意见》;国家数据局的高质量数据集建设方案,要打造"数据赋能智能体解决实际问题"的典型案例。
从"允许采购"到"点名打造"再到"典型案例",政策的台阶一级级铺好了。报告的原话是:数据智能体已进入产业落地关键窗口期。
回到开头那个场景。下一波智能体的胜负手,不在谁的发布会演示聊得更流畅,而在谁敢把它放进真实的数据链路里:让它取数、治理、加工、交付、盯安全,让它算准每一笔账,并且在它出错之前,责任链条已经画清楚。
AI的下一站不是聊天。是上班。
问题是——当数据智能体真的开始上班那天,你的企业接得住吗?

发表评论
发表评论: