
 研报速递
AI科普馆部分垂类内容转移至👆
【长三角人工智能联盟】公众号,快点进去瞧瞧!
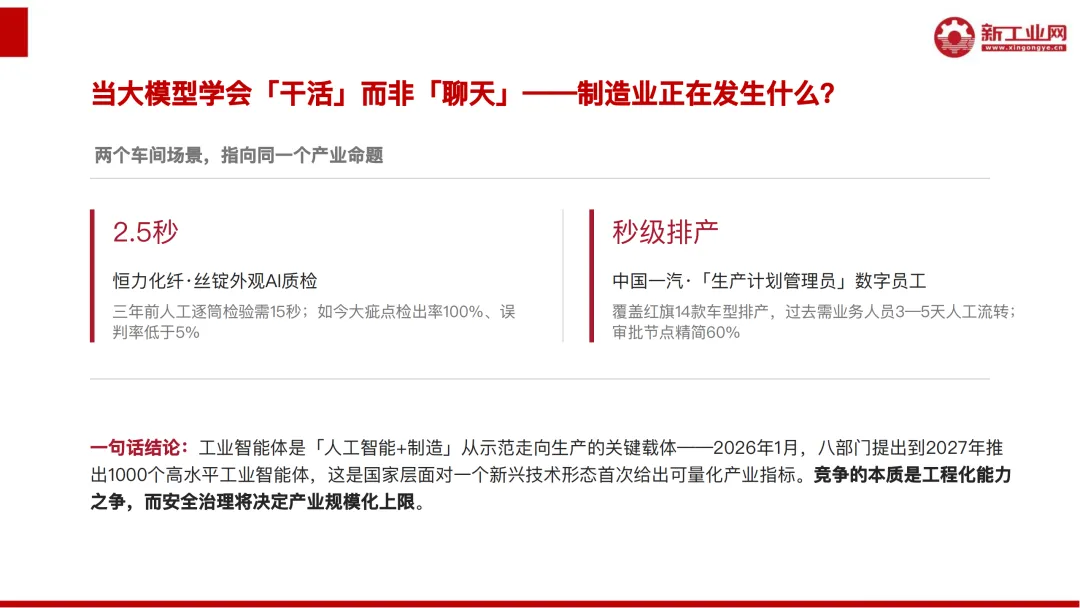
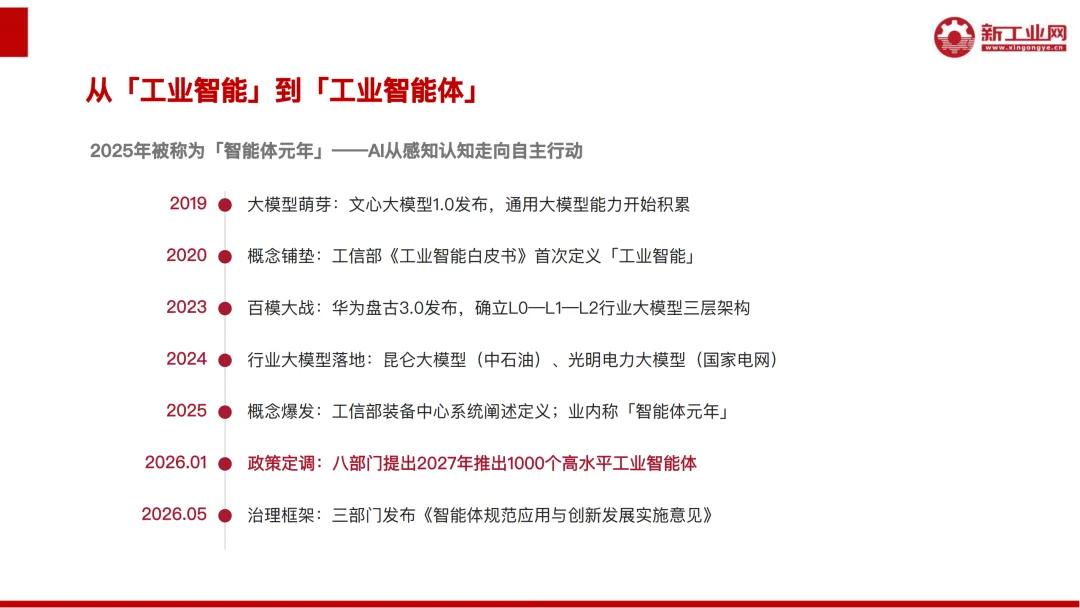
2026年1月,八部门提出到2027年推出1000个高水平工业智能体,这是国家层面对这一技术形态首次给出可量化指标。同一份报告里还有另一组数字:只有8%的企业实现了多场景部署,43%尚未进入实践。
1000和8%之间的这道沟,就是2026年工业智能体产业的全部现实。它不卡在模型上——模型能力正在趋同,卡住产业的是工程化:能不能把智能体稳定嵌进产线、闭环到设备、算清一笔可验证的ROI。
大模型"会想",智能体得"会干活"
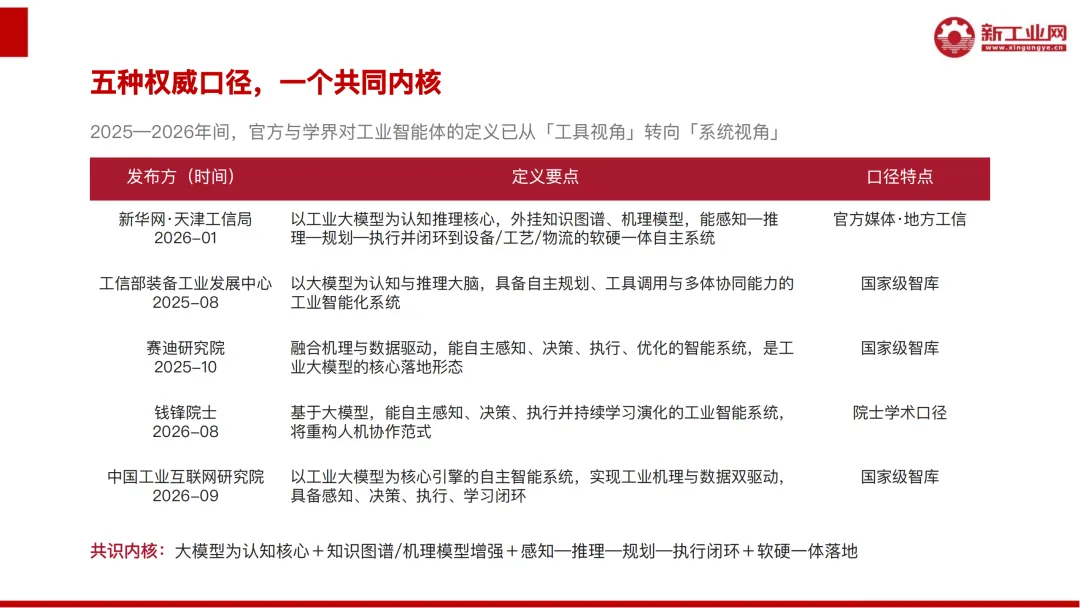
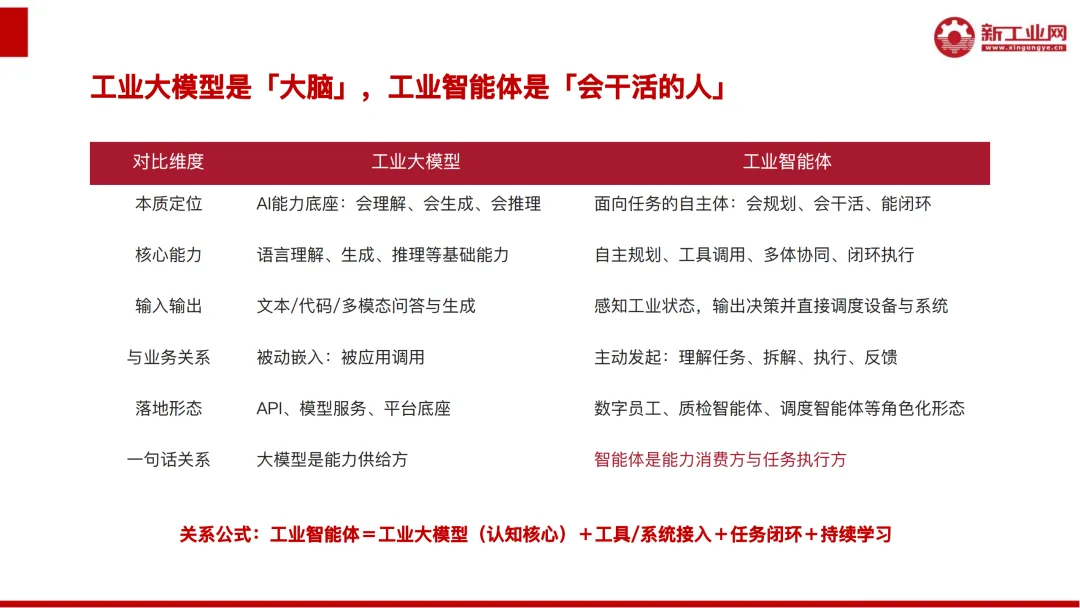
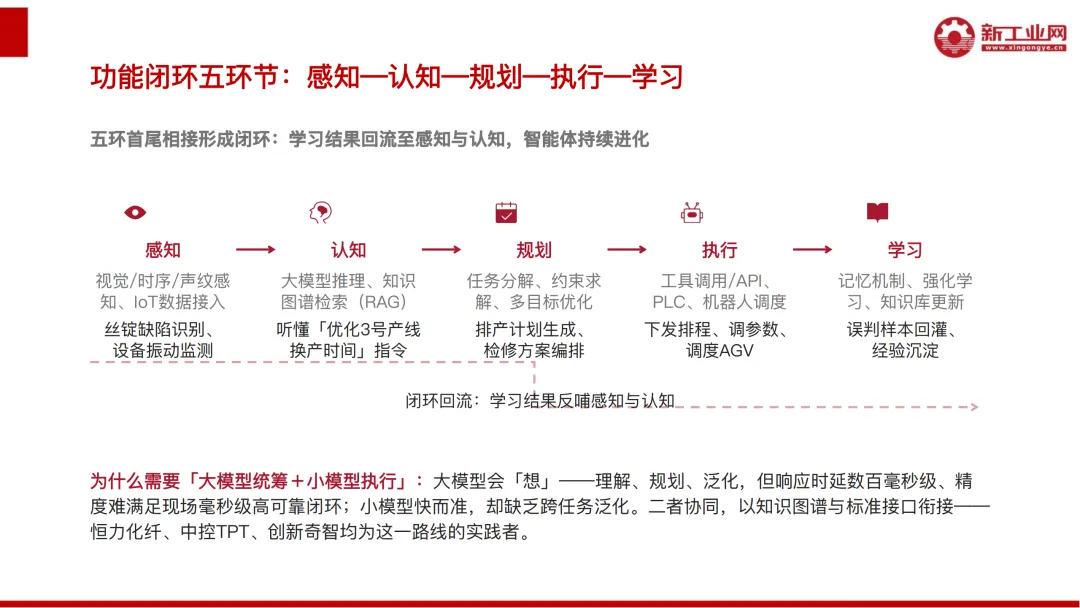
两者的关系,报告讲得很直白:大模型是能力供给方,被动嵌入、被应用调用;智能体是任务执行方,主动理解、拆解任务、调度设备、闭环反馈。工业智能体等于工业大模型这个认知核心,加上工具与系统接入,加上任务闭环,加上持续学习。
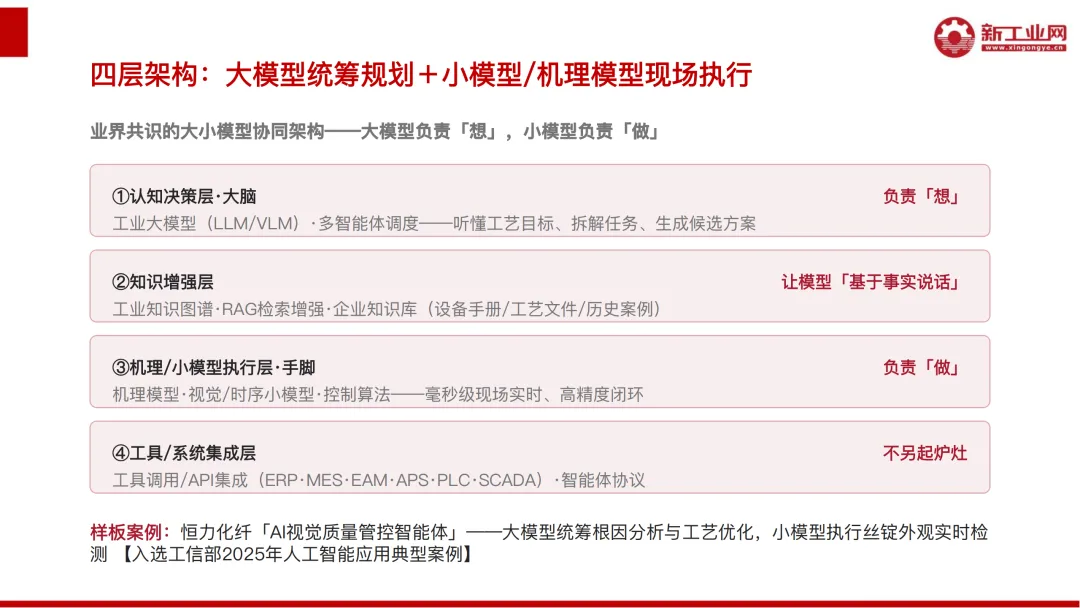
落到车间,架构已经收敛为"大模型统筹、小模型执行":大模型负责根因分析与任务规划,小模型和机理模型负责毫秒级现场闭环。恒力化纤的丝锭质检就是这个路子,单锭检测从15秒压到2.5秒,大疵点检出率100%。
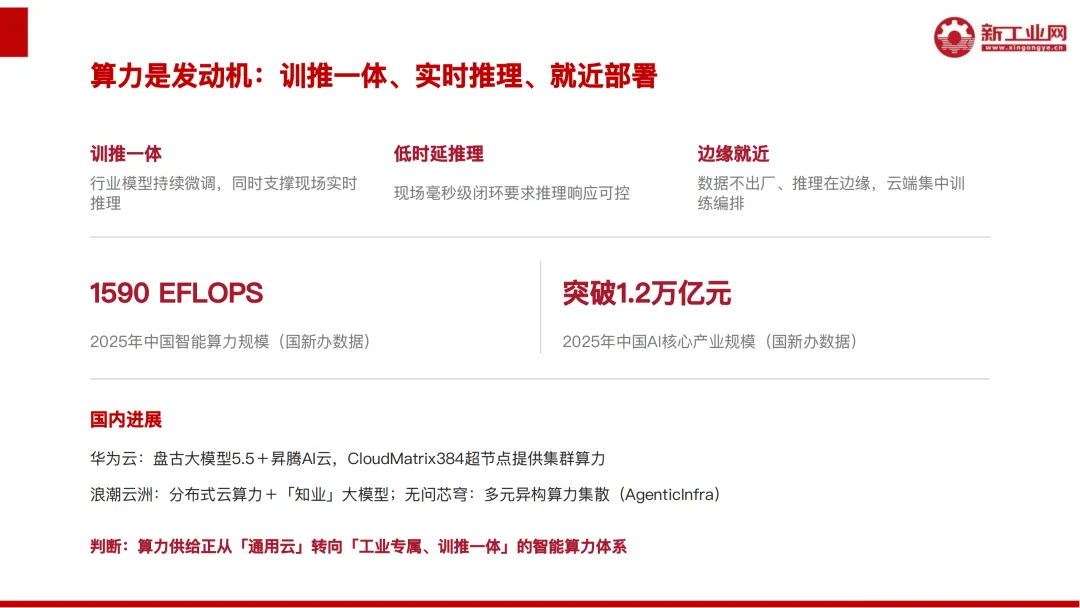
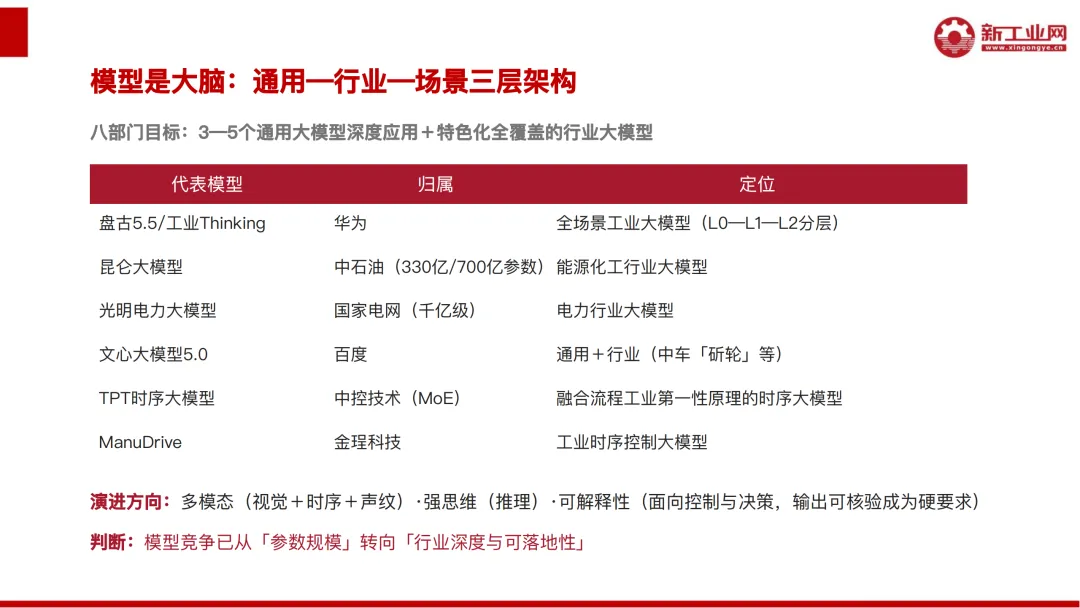
模型之间的竞争,已经从拼参数转向拼行业深度。
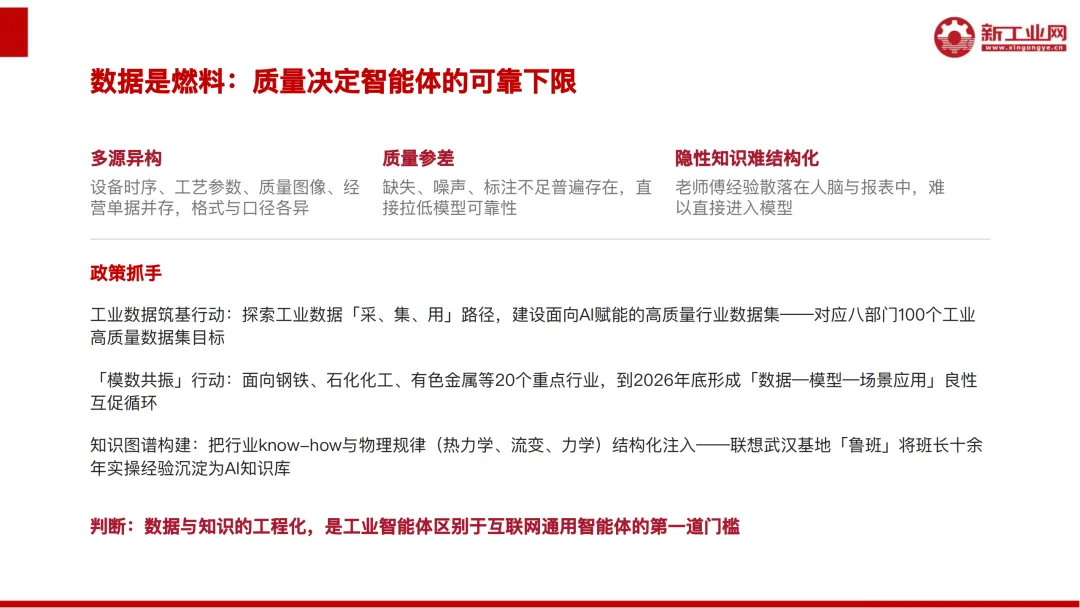
真正的门槛在第零步:数据没工程化
报告把"数据与知识的工程化"称为工业智能体区别于互联网通用智能体的第一道门槛。
设备时序、工艺参数、质量图像、经营单据并存,格式口径各异;缺失、噪声、标注不足普遍存在;最难的是老师傅的经验散在人脑和报表里,进不了模型。联想武汉基地"鲁班"做的事,就是把班长十几年的实操经验沉淀成AI知识库,基地制造成本降低17.32%。
政策抓手同样具体:工业数据筑基行动对应100个高质量数据集目标,"模数共振"行动面向钢铁、石化、有色等20个重点行业。
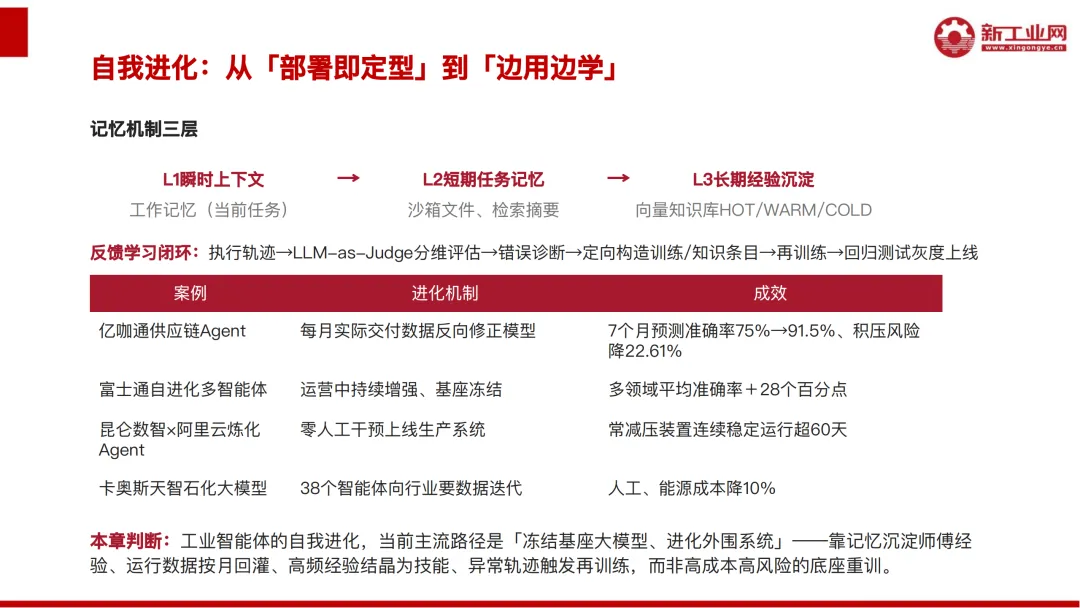
自我进化:冻结基座,7个月提16.5个百分点
自我进化听着玄,报告给的做法很朴素——冻结基座大模型,进化外围系统:记忆沉淀经验、运行数据按月回灌、异常轨迹触发再训练。
亿咖通用每月实际交付数据反向修正模型,7个月把预测准确率从75%提到91.5%,积压风险降22.61%;富士通基座冻结、运营中持续增强,多领域平均准确率提升28个百分点;昆仑数智与阿里云合作的炼化Agent零人工干预上线,常减压装置连续稳定运行超60天。
这比推倒重训底座成本低得多,也现实得多。
先切质检和排产,卡在钱和人
32个案例的成熟度分层很清楚:质检、仓储与简单排产跑在前面,宝钢的炼钢计划命中率做到98%以上、产能计划编制从6天压到3天;越往研发设计和全厂运维走,案例越少。
堵点也算得很细:63%的企业认为部署成本过高,46%缺兼具行业理解与智能体开发的复合型人才。已部署的环节里,生产制造占44%、研发设计32%、运维25%。
谁在跑:四条主线,一场量化竞赛
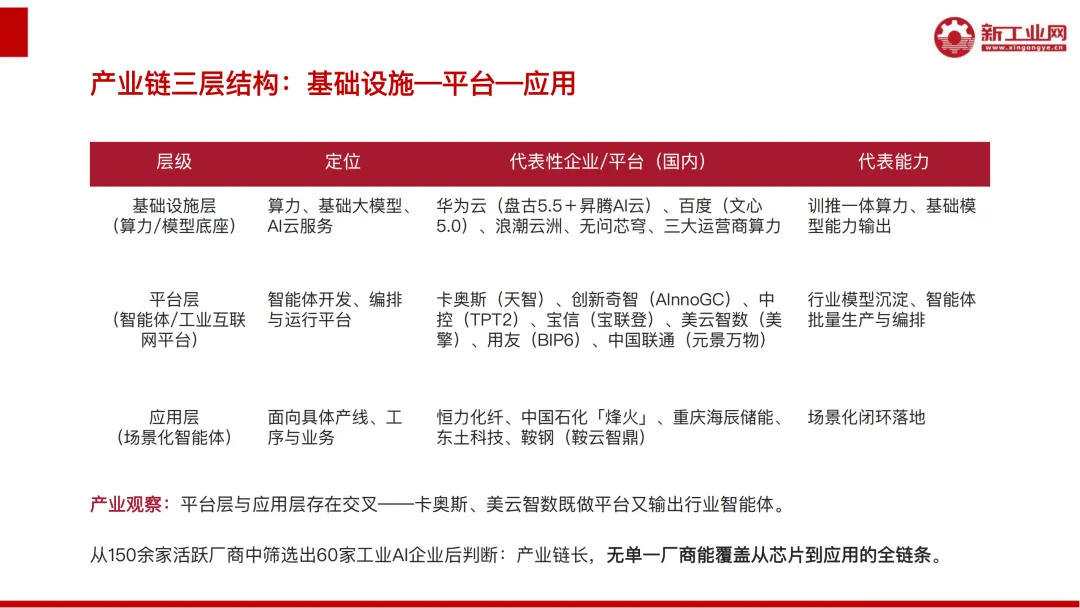
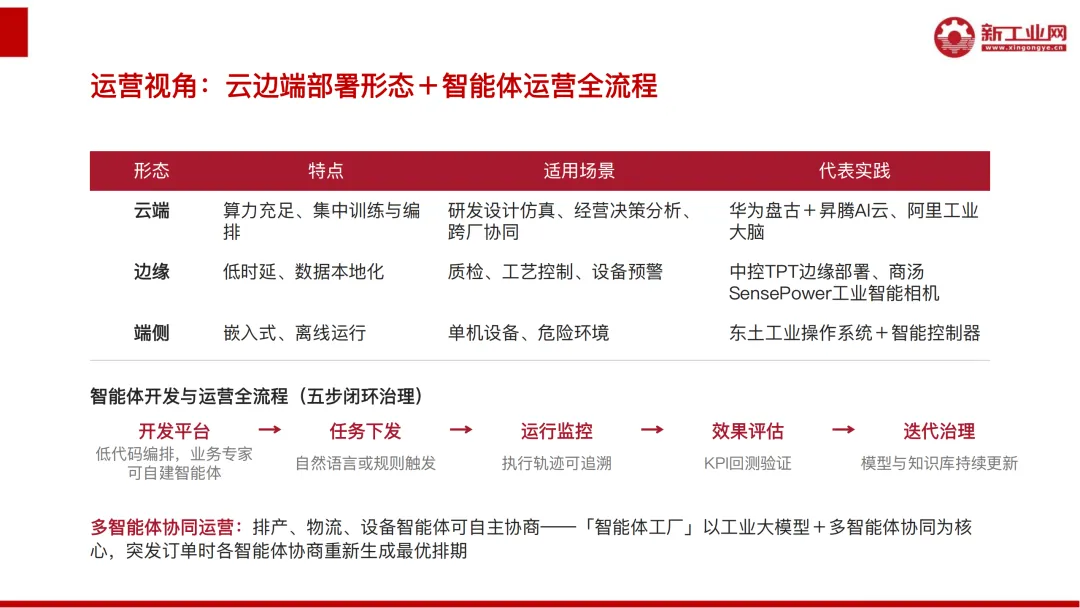
报告从150余家活跃厂商中筛出60家,判断是没有一家能覆盖从芯片到应用的全链条。竞争分成四条主线:大模型厂商向下卷落地,工业软件厂商向上卷智能,工控厂商向内卷自主运行,AI初创向纵深卷单点极致。
地方政策已经进入量化阶段。上海2028年要300个重点行业智能体,北京100个标杆应用,广东约200家智能体工厂,浙江5县市试点已落地103个案例。
市场口径却没统一:2025年窄口径148亿元(灼识咨询),宽口径约3080亿元(沙利文),相差近20倍,差别只在"智能体"算不算上软件平台和具身设备。
治理决定规模上限
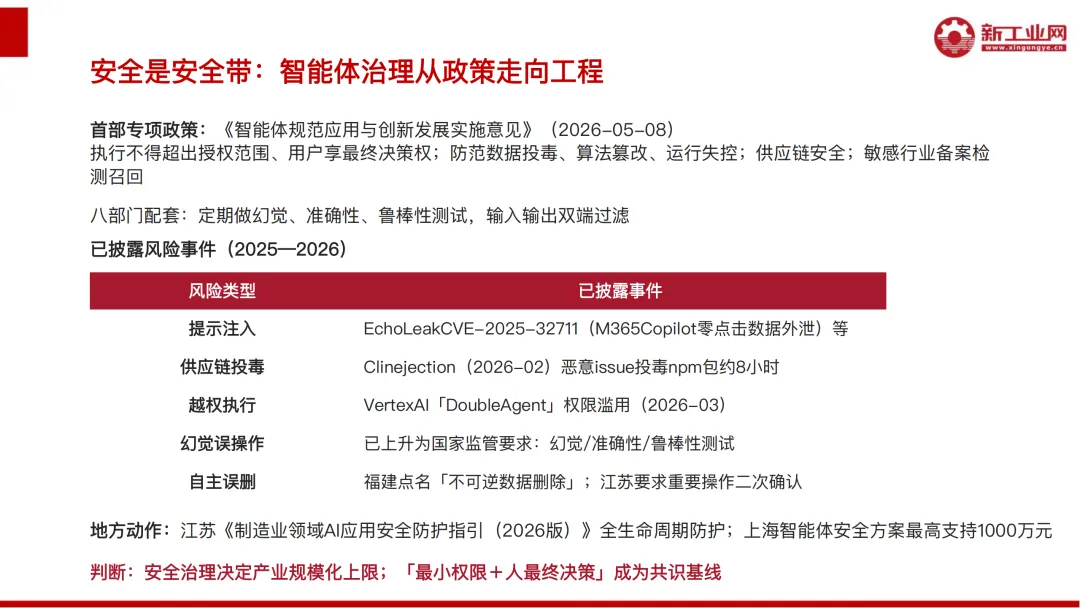
智能体一旦拿到执行权,风险敞口就打开了。报告列的风险都真实发生过:提示注入、供应链投毒、越权执行、幻觉误操作、自主误删。福建点名"不可逆数据删除",江苏要求重要操作二次确认。
我国已形成"规范意见、国家标准、地方指引"三层治理框架,"最小权限加人最终决策"成为共识基线。报告的判断是:安全治理决定产业规模化上限。
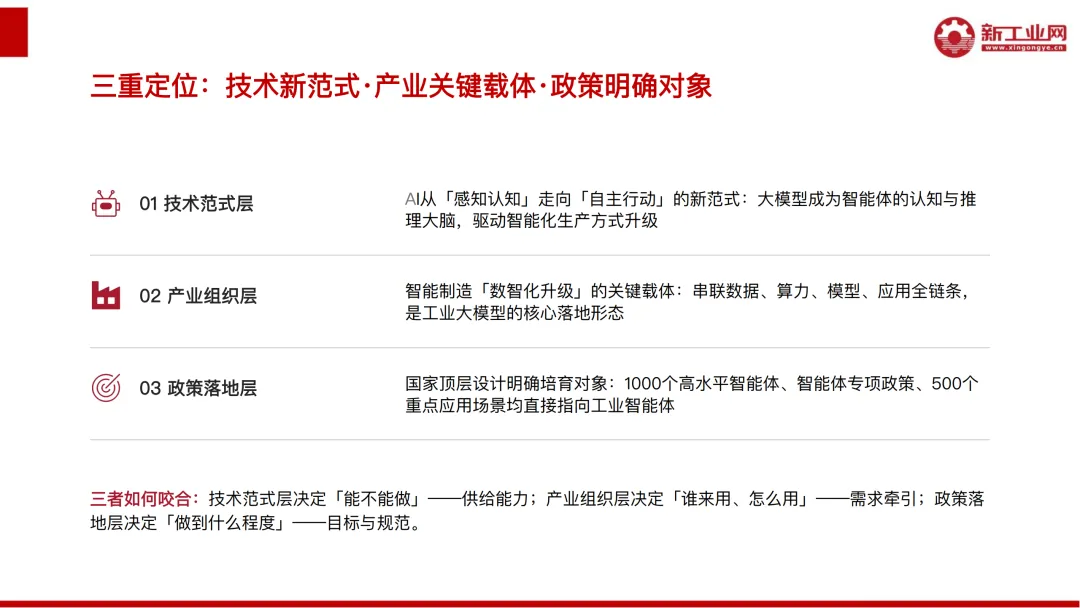
模型定能力上限,工程化定竞争位次,治理定规模上限。这三句话是这份报告的骨架,也是制造企业做技术选型时的三把尺子。
本文基于新工业网《2026年中国工业智能体产业研究报告》撰写,详细内容请查阅原文。
以下是内容节选↓↓↓ 文末点击链接免费下载pdf,扫二维码加入交流群
AI科普馆:打开AI世界之窗

发表评论
发表评论: