
 研报速递
科学阅读笔记 · 40个知识条目
为什么同样一份研究报告,不同的人能读出不同结论?
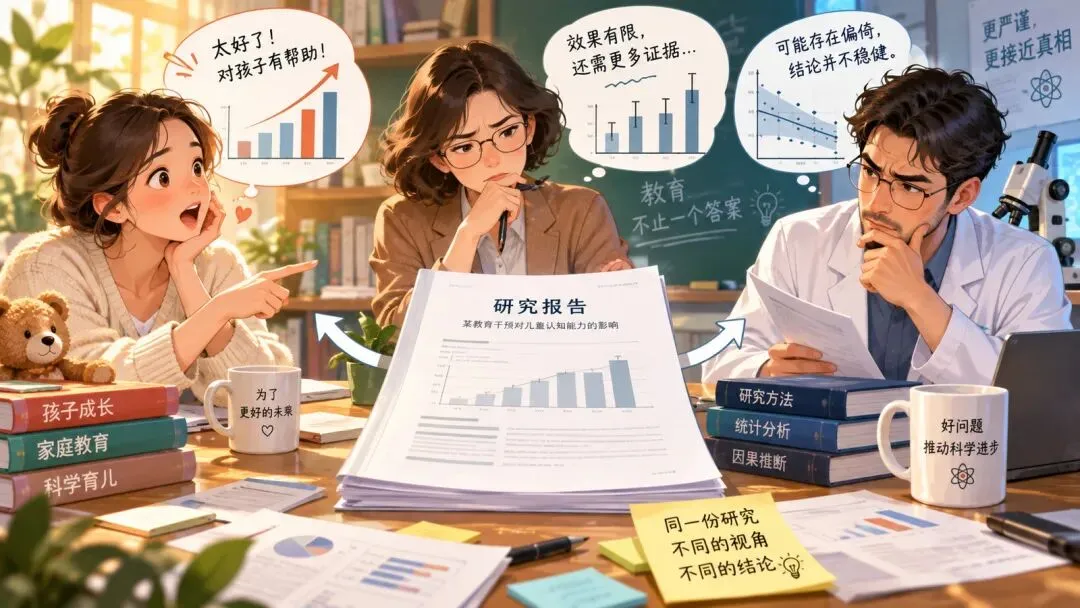 “成绩好的孩子近视更多”,就能说成绩好导致近视吗?“患病风险降低50%”,又是在说谁、哪一种风险、多久之内?
同样的数据,有人看到效果,有人看到疑问。分歧常常在于:我们有没有看懂数字背后的条件。
本文用考试、购物、开餐厅等生活例子,讲清40个研究阅读条目,帮助你区分:研究发现了什么,又没有证明什么。
阅读地图
按主题读,也可以按词查
第一部分|相关不等于因果:如何判断事情之间的关系?
01—07相关性 · 因果性 · 混杂因素 · 中介因素 · 反向因果 · 相关系数 · 统计调整
第二部分|数据也会误导人:研究中容易忽略的偏差
08—15幸存者偏差 · 选择偏差 · 失访偏差 · 发表偏差 · 回忆偏差 · 确认偏差 · 均值回归 · 辛普森悖论
第三部分|研究结果可信吗?读懂常见统计指标
16—26零假设 · P值 · 统计学显著性 · 95%置信区间 · 效应量 · 样本量 · 标准差 · 标准误 · 统计功效 · 多重比较 · 假阳性与假阴性
第四部分|“风险降低50%”究竟意味着什么?
27—32绝对风险降低 · 相对风险降低 · 相对风险 · 比值比 · 需要治疗人数 · 危险比
第五部分|什么样的科研方法更值得相信?
33—38随机对照试验 · 盲法 · 安慰剂与对照组 · 队列、病例对照与横断面研究 · 敏感性分析 · 亚组分析与事后分析
第六部分|统计结果漂亮,就代表现实中真的有用吗?
39—40临床意义与替代终点 · 系统综述、Meta分析与证据确定性
第七部分|实战:同一篇论文,三种不同解读
把前面学到的概念,用在一项真实的LED红光研究中。
结语|我们有没有对不同结论,换了尺子?
说明:除第七部分标明来源的真实试验外,文中的生活故事与数字均为教学示例。可先读感兴趣的章节,不必一次记住所有名词。
第一部分 · 01—07
相关不等于因果:如何判断事情之间的关系?
先弄清楚:我们看见的是一起变化,还是一件事真的改变了另一件事。
01. 相关性
Correlation|两件事经常一起变化
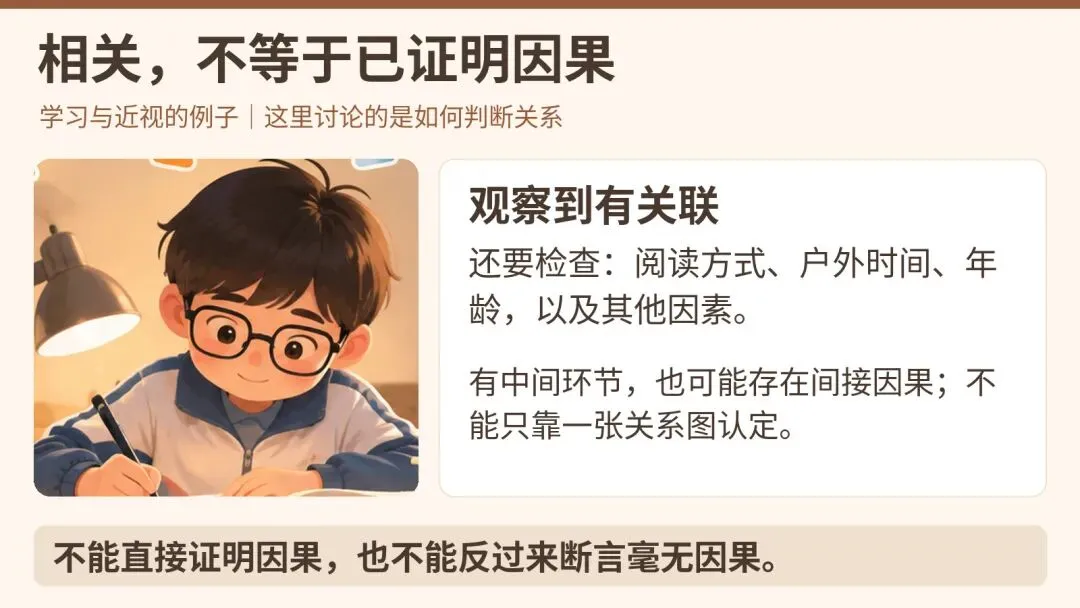
假设你观察一群孩子,发现:个子越高,鞋码往往也越大。 这就是一种相关性——两件事的变化有联系。
但它没有告诉你,这种联系究竟从何而来。不能因为鞋码与身高有关,就认为给孩子买大两号的鞋,孩子便会长得更高。
同样,假设某次调查发现学习努力的孩子近视更多,首先得到的是关联线索。阅读方式、户外活动、年龄等都需要继续分析。不能只凭这个观察认定整条因果链,也不能反过来宣称二者绝无因果关系。IMI的证据总结分别讨论了教育、近距离活动和户外时间等因素。[10]
相关,是发现联系;因果,是进一步弄清这种联系从何而来。
02. 因果性
Causation|改变一件事,会真正影响另一件事
水管正常供水时,你打开水龙头,水流出来;关上,水停止流出。这里,转动开关确实改变了水流。
因果性问的就是:如果我们主动改变A,而其他重要条件尽量不变,B会不会因此发生变化?
健康和教育中的作用,往往不是“做了就一定发生”,而是“做了会改变发生的机会”。一种方法平均有益,也不意味着每个人都能得到相同的改善。
尤其要分清:“单凭相关性不能证明因果”,不等于“已经证明没有因果”。[2]
在真实研究中,还需要明确改变的究竟是什么、与什么情况比较。观察性研究并非永远不能提供因果证据,但需要适当设计和可辩护的假设,不能只凭“相关显著”就完成因果判断。[2]
看见A和B一起出现,只是起点;要判断A是否真的影响B,还要看研究怎样排除其他解释。
03. 混杂因素
Confounding|背后还有一个共同原因
假设调查发现:买雨伞的人,鞋子更容易湿。
难道买雨伞让鞋子湿了?更自然的解释是:下雨既让人买雨伞,也让人的鞋子更容易湿。
这里,下雨就是藏在背后的共同原因。漏掉它,我们就可能把“雨的影响”误算到“买伞”头上。
研究中,这类能够干扰我们判断A与B关系的因素,叫混杂因素。它不是A作用之后才出现的中间步骤。[2]
看到A和B有关,先找一找:是否还有一个C,同时影响了两者?
04. 中介因素
Mediator|作用经过了哪一个中间环节
你安装自动浇水器,花长得更好了。可能的过程是:
安装浇水器 → 土壤水分更合适 → 花长得更好。
土壤水分就是中间环节。它不是用来否定浇水器的作用,而是解释作用怎样发生。
这点很容易与混杂混淆:下雨同时影响买伞与湿鞋,是“共同原因”;浇水器改变水分,再影响花的生长,是“作用路径”。
因此,假如研究最终证实“学习安排改变用眼行为,进而影响近视”,这仍可能是一种间接因果关系,不能因为中间隔着用眼行为,就断定学习安排与近视毫无因果联系。
不过,画出“浇水器→水分→长势”的箭头,只是提出一种解释,不等于已经验证了机制。是否真经过这个环节,仍需要数据和额外假设支持。[2]
有中间环节,不等于没有因果;它可能恰好解释了因果怎样发生。
05. 反向因果
Reverse causation|可能把原因和结果弄反了
假设有人说:“去医院越多的人,身体越差,所以医院让人变得不健康。”
你很容易发现另一种解释:身体不好的人,才更需要去医院。
看到A与B有关时,原因和结果可能被倒过来了。有些关系还可能双向影响,不能只凭同一时间点的调查确定方向。
同一时期的关联通常不能单独辨认方向;先后顺序清楚,也还需要考虑共同原因。[2]
不仅要问“是不是A导致B”,还要问“会不会是B影响了A”。
06. 相关系数
Pearson’s r|一起变化的关系有多紧密
还是身高与鞋码。若每次看到更高的孩子,通常也会看到更大的鞋码,两者的正向关系就比较紧密。
常见的皮尔逊相关系数r,用−1到+1描述线性关系:靠近+1,通常一起增减;靠近−1,一个增加时另一个减少;靠近0,没有明显的直线式关系。
r=0.85,不是“身高有85%的概率导致鞋码增大”。 它描述关系,不计算因果概率。
还有一个直观例子:屋里太冷不舒服,太热也不舒服,中间温度最舒服。这种“弯着走”的关系,未必能被一个接近0的线性相关系数反映出来。
这里讲的是皮尔逊相关系数。其他相关指标可能关注排序关系,不能把所有“相关”都只理解成同一种算法。[16]
r看的是线性关系的方向与紧密程度,不是因果,也不是全部关系。
07. 统计调整
Adjusted analysis|把已知的不公平条件考虑进去
A班期末平均90分,B班80分。能马上说A班老师教得更好吗?
如果A班入学时已经85分,B班只有65分,单比期末分数显然不够。研究人员需要把学生原来的基础等因素考虑进去,再估计教学方式与结果的关系。
这就是统计调整的直观想法。但调整不是把两组变成完全相同的人。 没测到的因素、测不准的因素、选错的模型,都可能留下问题。
也不是调整越多越好:如果你想知道浇水器的总作用,却把它带来的水分变化也“扣掉”,回答的就可能是另一个问题。[2]
在随机试验里,恰当地调整治疗前的变量,也可以提高估计精度;不是只有分组出问题才需要调整。判断调整是否合理,要看原先的研究问题和分析方案,而不是看哪个P值更小。[5][14]
看“调整后”三个字,还要看:调整了什么,为什么调整?
第二部分 · 08—15
数据也会误导人:研究中容易忽略的偏差
有时没有人算错,问题却出在看到了谁、漏掉了谁,以及怎样选择信息。
08. 幸存者偏差
Survivorship bias|只看留下来的,忘了消失的
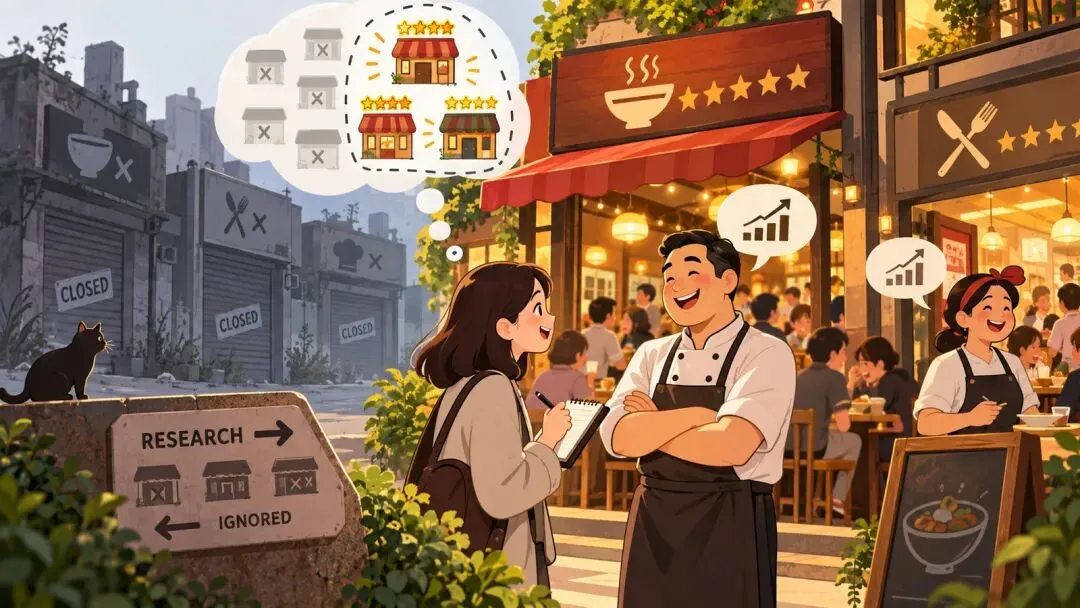
你采访10家经营超过10年的餐厅,发现老板都早起、勤奋、亲自管理。于是总结:“照着做,就能成功开店。”
可是,那些已经倒闭的餐厅呢?假设100家倒闭餐厅里,90位老板也同样早起、勤奋,这些特点就未必能很好地区分成功与失败。
你只看见了留在市场上的餐厅,没看见退出的餐厅。这就是幸存者偏差,是选择偏差的一种表现。
同样,只采访长寿老人,再总结他们共同的饮食习惯,不能直接证明这些习惯帮助人长寿。还要了解具有同样习惯、却没有活到那么大年纪的人。[2]
问成功者做对了什么之前,先问:失败者是不是也这样做?
09. 选择偏差
Selection bias|一开始找的人就不合适
你想知道广州居民每周运动几次,却只到健身房采访,得到“平均每周4次”的结果。
计算可能完全正确,但健身房顾客不能直接代表全体居民。很少运动的人,从一开始就不容易进入你的调查。
如果选人的方式已经偏了,多调查几万人也不能自动补救。在比较两种治疗时,不恰当的入选方式还可能扭曲两组之间的关系。[2]
还要区分两个问题:样本能不能代表全城,和研究中两组比较是否公平,不是同一回事。一项只在某家医院招募的随机试验,可能不适合直接推广给所有人,却不因此自动失去内部比较的价值。[5][9]
先看人是怎么找来的,再看人数有多少。
10. 失访偏差
Attrition bias|中途退出的人被遗漏了
一家减肥机构招收100人,三个月后只有40人留下。这40人平均瘦了5公斤,机构便宣传:“参加课程,平均减重5公斤。”
另外60个人呢?他们是忙得没时间,还是没有效果,或者觉得不舒服才退出?
只看留下来的40人,可能高估,也可能低估原来100人的结果。 关键是退出与治疗、结果之间有没有关系,并不是只要有人退出,研究就一定无效。[5]
看最终成绩单时,别忘了点名:最初参加的人,后来都去哪了?
11. 发表偏差
Publication bias|做过的研究,不一定都能被看见
假设100个团队研究同一种产品,90个没有发现明确作用,10个得到了积极结果。
如果只有这10个团队发表论文,读者搜到的就可能全是好消息:“这么多论文都说有效!”
问题不是这10篇一定造假,而是没有发表的90篇可能改变全貌。是否发表、何时发表,与结果有关,就可能让公开证据偏向一边。[7]
如果研究已经发表,却只突出测过的许多结果中最好看的几个,属于选择性报告。它与“整项研究没有发表”不同,但都会让读者看不到全貌。[5][7]
搜到的研究,不一定等于做过的全部研究。
12. 回忆偏差
Recall bias|今天记得的,不一定等于当年发生的
一家人聚餐后,两个人肚子不舒服。问大家昨天吃了什么,不舒服的人可能会仔细回想每一道菜,没事的人却随口说:“记不清了。”
不是谁故意撒谎,而是两组人回忆过去的认真程度、准确程度可能不同。
研究要求人们回忆多年前的饮食、用药、工作环境时,也可能遇到这种问题。它属于信息偏差的一种。[2]
人的记忆不是监控录像,尤其不能默认两组人记得一样准确。
13. 确认偏差
Confirmation bias|只注意支持自己想法的信息
家长相信某套课程能提高成绩。孩子考得好,他说课程有效;孩子考得差,他说孩子粗心。
这样一来,不管结果怎样,原来的判断似乎都不会错。
确认偏差就是:我们容易注意、相信支持自己观点的信息,却对相反证据要求格外苛刻。盲法、预先规定分析方案、完整报告结果,能帮助减少这种空间。[5]
面对自己喜欢的结论,也要使用和面对不喜欢的结论一样的尺子。
14. 均值回归
Regression to the mean|一次特别差,下一次可能自然没那么差
孩子平时考85分,某次状态不好只考60分。家长马上报班,下一次考84分,就说:“课程让他提高了24分!”
但即使不报班,下一次也可能恢复到平常水平。因为这次入选的起点,恰好是一次异常偏低的表现。
当真实水平没有相应改变、测量存在波动,而且我们专挑一次极端结果开始观察时,后续测量平均而言往往没那么极端。这是均值回归的典型情形。它不是每个人下一次必然恢复正常,也不表示所有改善都是假的。[6]
别把“从异常低谷恢复”,全部算成新方法的功劳。
15. 辛普森悖论
Simpson’s paradox|分开看更好,合起来却更差
两个班各做100道题,但A班主要做难题,B班主要做简单题。假设答题情况如下:
在简单题和难题里,A班都更好;合起来,反而是B班更高。
不是算错了,而是两班题目难度的构成不同。这类合并前后关系发生反转的现象,叫辛普森悖论。
也不能因此认定“分层的结果一定正确、总结果一定错误”。应该按研究问题判断分组依据的作用,不能只挑自己喜欢的那一种数字。[2]
总平均值可能藏着结构差异;分开看和合起来看为什么不同,要追问背景。
第三部分 · 16—26
研究结果可信吗?读懂常见统计指标
这一部分不要求会算公式,只要分清每个数字究竟在回答什么问题。
16. 零假设
Null hypothesis|先设一个需要接受检验的假设
你怀疑一枚硬币不公平,可以先假设:它正反面机会一样,每次都是50%。 然后用事先约定的抛掷方式收集结果,看数据与这个假设是否相容。
这个先拿来检验的假设,叫零假设。治疗研究中,常见的零假设是两组的真实平均效果没有差别。
这是检验的起点,不是研究者必须相信的结论。[1]
没有足够证据推翻一个假设,不等于已经证明它正确。
17. P值
P-value|假如没有区别,这个结果有多不寻常
继续看硬币。你事先决定抛10次,每次独立抛掷,结果是:8次正面、2次反面。
你会怀疑硬币偏向正面,但公平硬币也可能碰巧这样。于是先假设硬币公平,再计算:像8比2这么偏、甚至更偏的结果,有多常见?
在这个例子的双侧精确检验中,P约为0.109,也就是10.9%。意思是:如果真是公平硬币,反复做很多组“每组抛10次”的实验,约每1000组中会有109组出现“至少8次正面”或“至多2次正面”。这里两个方向都算。
它不是“硬币有10.9%的概率公平”,也不是“硬币有89.1%的概率被做过手脚”。 它先假设公平,再讨论结果有多不寻常;不是拿结果倒过来直接计算假设是真是假。[1]
P值不是“结论正确的概率”,也不是“产品有效的概率”。
18. 统计学显著性
Statistical significance|有没有越过预先约定的判断线
考试规定60分及格,59分不及格。两个人虽然拿到不同标签,水平却不一定差很多。
统计研究也常设一条线,例如P<0.05。低于它,叫达到统计学显著性;没有低于它,就没有达到这条标准。
因此,P=0.049与P=0.051,不是“一个绝对有效、一个完全无效”。标签跨了线,证据不会突然发生质变。 P=0.03也不等于效果很大或结论有97%的正确概率。[1]
还有一个常见词叫“名义显著”:某次检验的原始P值越过了常用门槛,但不表示它已经通过对多次检验的整体控制。报告中的“显著”要连同预设方案一起看。[1][8]
显著不等于重要;不显著也不等于证明没有作用。
19. 95%置信区间
95% confidence interval|别只看一个估计,还要看有多不确定
你想知道一个小区成年人的平均身高,随机量了一部分居民,估计为170厘米,95%置信区间为168—172厘米。170是单个估计,区间表示这个估计的抽样不确定性。
这不是说95%的居民都在168—172厘米,也不是预测下一个人的身高。这里研究的是总体平均值,不是每个人的范围。
“95%”说的是方法:在相应条件成立时,反复抽样、每次按同一规则计算区间,长期约95%的区间会覆盖真实平均值。不是说这一次固定的真实值,有95%的概率落在已经算出的区间内。[3]
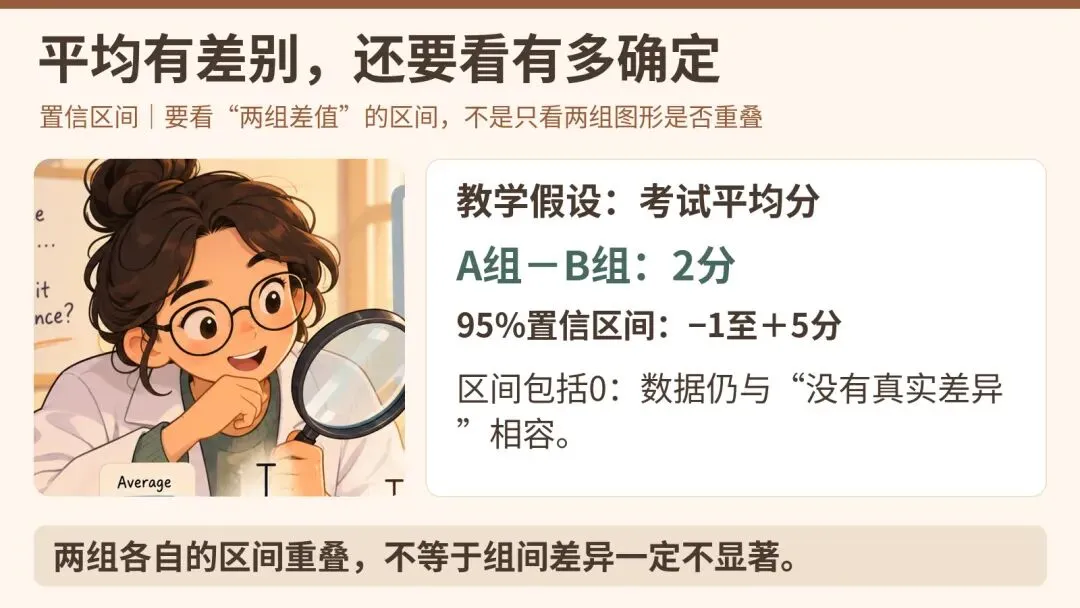
比较两组时,要看两组差值或比值的区间。平均差的“没差别”是0;RR、OR、HR这类比值的“没差别”是1。对相匹配的常规双侧检验,95%区间是否包含无差异值,通常与P是否低于0.05相对应。
不要只看A组自己的区间和B组自己的区间有没有重叠。两组区间即使重叠,组间差异仍可能显著。应该直接分析两组的差异。[13]
区间很窄表示估计较精细,不保证没有系统性偏差。就像一把刻度很细、但零点偏了的尺子:读数再细,也可能量偏。
看置信区间:先看估计的是谁、什么量,再看区间宽度和无差异值。
20. 效应量
Effect size|实际改善了多少
两种训练都宣称“成绩显著提高”。一种平均多0.5分,另一种平均多10分,意义显然不能只看同一个“显著”标签。
效应量就是效果大小。它可以是多考几分、少花几分钟、眼轴少增长多少毫米,或某种事件的风险相差多少。[4]
还要看比较对象和时间:与完全不训练比,还是与另一种训练比?一个月的变化,还是一年的变化?不同研究的数字不能脱离条件直接排队。
在观察性研究里,“效应量”这个名称也可能只是关联大小的统计表达,不因为用了“效应”二字,就已经确认了因果。[2]
看见“有作用”,下一句就问:作用有多大,和谁比,持续多久?
21. 样本量
Sample size|研究了多少独立对象
问3个邻居小区食堂好不好,恰好全说好,很难代表整个小区。随机问300个家庭,在其他条件相似时,平均评价通常更稳定。
但问同一个人300遍,不等于问了300个人;只在食堂排队人群中调查300人,也可能漏掉不喜欢这家食堂的人。
所以,人数多能减少部分随机波动,却不能自动解决选人不公平的问题。同一个孩子的左右眼,也不能不加处理就当成两个完全独立的人。[3][8]
既看有多少数据,也看这些数据来自多少独立对象。
22. 标准差
Standard deviation,SD|大家之间有多不一样
两组学生平均分都是80分。
A组:78、79、80、81、82分。
B组:40、80、90、90、100分。
不用算公式也看得出:B组有人很低、有人很高,成绩更分散。标准差就是描述这种分散程度的指标。[16]
标准差看的是人和人之间的差别,不是平均值准不准。
23. 标准误
Standard error,SE|这次估计换一批人会波动多少
你想估计全校平均身高。每次随机抽10名学生,算出的平均值可能忽高忽低;每次抽100名,在其他条件相似时,平均值通常没那么跳。
标准误描述的就是这种估计值的抽样波动。平均数、两组平均差、回归系数等估计,都可以有自己的标准误。[16]
因此,“孩子之间差得很大”和“平均值估得不准”有关,却不是同一件事。人数增加,平均值可能估得更准,但孩子们之间的真实差异不会因此消失。
论文中的“平均值±某个数字”,可能写的是SD,也可能是SE。先看表下注释,不能只凭“±”就猜它表示什么。
SD看个体差多远;SE看估计会有多晃。
24. 统计功效
Statistical power|真有一点作用,研究能不能看出来
假如有一枚特殊处理过的硬币正面概率不是50%,而是52%。只抛10次,很难发现这一点点偏向;按合适方案抛很多次,通常更容易看出来。
统计功效问的是:假如某个指定大小的真实效果确实存在,研究有多大机会按预定规则检出它?
例如,对某个指定效果有80%的功效,意思是在设计和模型条件成立时,反复做同类研究,约80%能越过预定检验门槛。它不是“这次研究有80%概率正确”。[3]
不能把一切不显著结果都归咎于样本小。还要看估计效果及其区间:到底仍可能有重要获益,还是已经排除了很大的作用?
对于很少发生的结局,还要看实际发生了多少例事件,不能只看报名人数。1000人里只有一两例事件,仍可能让效果估计很不稳定。[3]
没发现,不一定不存在;但也不能因此认定只是暂时没发现。
25. 多重比较
Multiple comparisons|找得越多,越容易碰巧挑中一个
你试穿一件衣服,不一定合身;试穿100件,挑出一件合身就不奇怪了。
研究也可能测很多指标、很多时间点、很多小群体。如果只展示其中最漂亮的一个结果,就像把精挑细选的那件衣服说成“随手拿来都合身”。
假设20个检验彼此独立,而且实际都没有差异,每个都用5%的误报门槛,那么至少误报一次的概率约为64%,不是5%。实际研究的指标常常相关,具体数字会不同,是否与怎样校正还要看分析计划。[8]
不只看“找到了什么”,还要看“总共找了多少次”。
26. 假阳性与假阴性
False positive / False negative|误报与漏报
没有起火,烟雾报警器却响了,是误报;真的起火,报警器却没响,是漏报。
在检验“有没有效果”时,也可能出现两类错误:没真实效果却误判出差异,或有真实效果却没能检出。
把误报门槛设得很低,通常不等于两种错误一起消失。 如果其他条件不变,要求更苛刻,往往也更容易漏掉较小效果。[1][3]
这个例子是在类比统计检验;医学检测中的“阳性结果是否真的患病”,还涉及患病率等其他问题,不能把它与P值直接画等号。
科研既要防止“没火乱报警”,也要留心“有火没听见”。
第四部分 · 27—32
“风险降低50%”究竟意味着什么?
先问清楚:针对谁,减少什么事件,在多长时间内,和谁比较?
先分清“预防发生”和“治疗已有疾病”。
以下计算采用教学假设:研究对象在开始时都没有患目标疾病;一组接受预防措施,另一组不接受这项措施,分别观察接下来1年内新发生的病例。比较的是两组人,不是同一批已经患病的人治疗前后还剩几人。
如果研究对象开始时已经患病,就应具体说明考察的是并发症、复发、死亡、康复,还是症状改善;不能把治疗已有疾病,写成降低同一种疾病的首次发生风险。[4]
27. 绝对风险降低
Absolute risk reduction,ARR|同样人数中,实际少了多少人
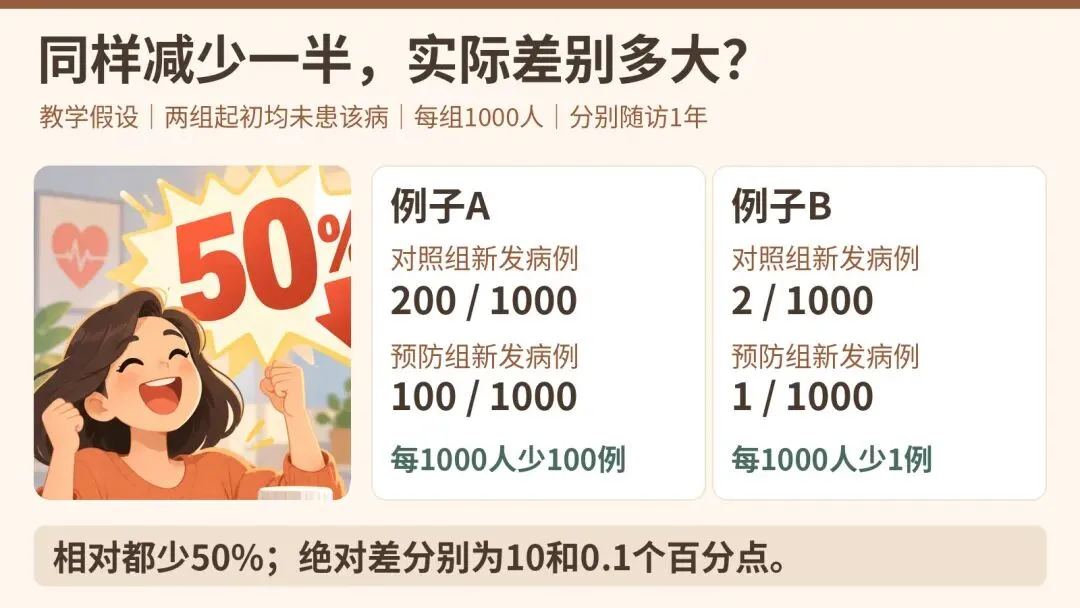
假设两组各1000人,起初均未患该病、完整随访1年,教学记录如下:
两组观察到的风险相差20%-10%=10个百分点。换成相同规模的人群,就是每1000人少100例。这叫绝对风险降低;从观察数据得到的是它的估计值。[4]
这不是“把已经患病的200人治好了100人”,也不能指出具体哪100人被预防了发病。是否真由措施带来,还要看分组是否公平、估计是否精确等证据。
绝对风险降低:在同样时间、同样人数的比较中,少发生了多少目标事件。
28. 相对风险降低
Relative risk reduction,RRR|和原来的水平相比,少了几成
在例子A中,对照组1年风险20%,预防组10%。相对于对照组原来的风险,减少了50%,但绝对差是10个百分点。
再看例子B:仍是两组各1000人、起初都未患该病、随访1年。对照组新发2例,预防组新发1例;观察到的风险分别为0.2%与0.1%,相对也少了50%,绝对却只差0.1个百分点,即每1000人少1例。[4]
就像两件商品都打五折:原价20元省10元,原价2000元省1000元。折扣一样,不代表省下的钱一样。
但只有2例对1例,不能单凭“算出来少一半”就确认预防有效。事件很少时,结果可能非常不稳定,仍须查看置信区间和研究设计。这里的数字只是教你分清算法。[3]
绝对获益小也不自动等于不值得:还要看预防的疾病多严重,以及措施的代价和风险。
听见“风险少一半”,接着问:原来多少、绝对少多少、这个估计有多稳?
29. 相对风险
Risk ratio,RR|一组的风险是另一组的几倍
仍看例子A:预防组1年风险10%,对照组20%。10%除以20%,得到RR=0.5,即预防组观察到的风险为对照组的一半。[4]
RR=1对应两组风险相同这个比较值;RR=2对应前一组风险为后一组两倍。先看清“谁除以谁”,以及比较的是什么事件。
较低并不总是好事:若事件是患病,较低通常有利;若事件是康复,较低反而可能不利。论文中的RR通常是估计,仍须连同置信区间理解,不能把一个点估计当成已经确定的真实效果。
RR说的是几倍;它不是“有效率”,也不告诉你哪些人一定受益。
30. 比值比
Odds ratio,OR|换了分母,就不是同一个东西
一袋糖有20颗红糖、80颗白糖。红糖占全部的比例是20/100=20%;红糖与白糖之比却是20/80=0.25。
前者用“全部”当分母,后者用“没发生的那部分”当分母。后者叫odds;OR就是比较两组odds。
在例子A里,预防组“患病:没患病”是100:900,对照组是200:800。两组相除,OR约为0.44,而RR是0.5。事件越常见,两种表达往往越不能互换。[4]
特别是病例对照研究,研究者本来就按有无疾病来选人,样本里病例占多少,不等于普通人群的患病风险;不要直接拿这个比例算总体RR。[2]
OR不是RR;不能把OR=2直接翻译成“患病概率翻倍”。
31. 需要治疗人数
Number needed to treat,NNT|平均治疗多少人,才能额外避免一例
沿用例子A:1年内估计每1000人少100例,即每100人少10例。假如这一差异可归因于该措施,换算起来就是平均让10人接受预防措施,1年内相对对照多避免1例发病,NNT=10。[3]
中文常译“需要治疗人数”,但预防性干预也可以使用NNT,不要求研究对象原本已经患病。它是表达额外获益的方式。
这不是每凑齐10人,就保证恰好有1人受益;也不是说其余9人肯定白做了。NNT本身也是估计,需要考虑不确定性。
必须一起看人群、比较对象、目标事件和期限。1年内预防一种严重疾病,与10年内少一次轻微不适,不能只比较NNT。
读NNT,要补全一句话:多少人,在多久内,相对什么措施,多避免哪一种事件?
32. 危险比
Hazard ratio,HR|不仅看坏了多少,还看什么时候坏
假设两组各100台新冰箱,观察5年,都有10台坏了;一组多数第一年就坏,另一组多数第五年才坏。你显然还会关心:它们是什么时候坏的?
这说明只看最终坏了多少台还不够。HR是时间事件分析中的指标,比较某个时点上,各组仍未发生目标事件、仍处于风险中的对象,其瞬时事件发生率的比值。刚才的总人数本身并不足以计算HR。[4]
如果常用的比例风险假设合适,HR=0.70可以理解为前一组的瞬时发生率约为后一组的70%。这不是“寿命延长30%”,也不是“5年累计患病概率必定降低30%”。
如果两组的这种比值随时间明显改变,就不能把单一HR当成每个时点都成立的规律,还需要看随时间的结果。
HR讨论发生时间与瞬时事件率,不直接回答“多活几年”或“少多少人患病”。
第五部分 · 33—38
什么样的科研方法更值得相信?
结果能说明多少,取决于研究最初怎样设计,以及后来有没有认真执行。
33. 随机对照试验
Randomized controlled trial,RCT|尽量公平地抽签分组
学校想比较两种教学法。如果新方法组全是原本成绩好的学生,旧方法组全是基础弱的学生,期末谁更高就很难解释。
随机分组相当于按公平规则抽签,减少老师挑人的影响。它能在平均意义上平衡已知和未知因素,但不保证某一次,尤其是小样本时,两组恰好完全一样。[5]
还要看随机结果能否提前被知道、是否按规则入组、两组后来是否受到不同照顾、是否大量失访。RCT是好的设计起点,不是免检证书。
顺带留意“意向性分析(ITT)”:原则上按最初分组比较,不因后来没坚持就随便剔除。但数据缺失仍需妥善处理。
还要分清随机抽样和随机分组:前者关系到抽来的人能代表谁;后者关系到这些人如何接受不同处理。两者不是一回事。[5][16]
抽签让起跑更公平;研究能否跑得公平,还要看全过程。
34. 盲法
Blinding|别让预期偷偷影响结果
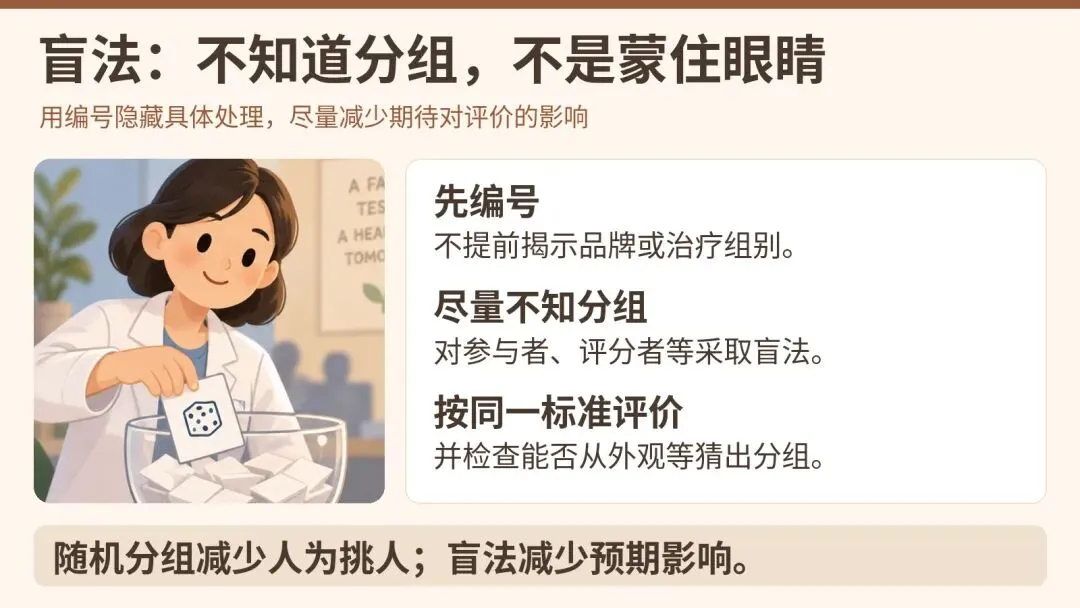
比较两杯饮料,提前告诉你一杯很贵、一杯很便宜,可能影响你的评价。把杯子编号,不告诉品牌和价格,再让你品尝,就减少了这种影响。
研究中的盲法也是类似思路:尽量不让参与者、治疗人员或评估者知道分组,减少期待和人为操作对结果的影响。[5]
“双盲”这个标签不够具体。要问究竟谁不知道,以及是否能从味道、外观、副作用等猜出来。教学等干预无法对所有人设盲,也不等于毫无价值,仍可对评分者等设盲。
盲法不是要求人戴眼罩,也不是故意不告知研究风险。这里隐藏的是可能影响行为和评价的分组信息;参与者仍应获得必要的知情同意说明。[14]
重点不是名字叫几盲,而是谁可能受预期影响、又怎样减少这种影响。
35. 安慰剂与对照组
Placebo / Control|没有新治疗,人也可能变好
孩子考试考差,你一边报新课程,一边让他早睡、减少其他活动,下一次成绩提高了。到底是哪一项帮助了他?还是他本来就会恢复?
对照组让我们多看一条“没有采用这项新方法”的路径,帮助估计干预额外带来的变化。
安慰剂是某类对照:外观和使用情境尽量相似,但不包含研究要检验的特定活性成分。期待和治疗情境可能影响症状感受,但安慰剂组全部改善不能都算作安慰剂效应,还可能有自然波动、均值回归等。[5]
对照组也可以接受已有的常规有效治疗,不一定是不治疗。新方法比“什么都不做”好,不等于比现有标准方法更好。[5][14]
前后变好了,不等于新方法起作用;要比较“不用它,本来可能怎样”。
36. 队列、病例对照与横断面研究
Observational studies|拍快照、拍纪录片,还是回头查记录
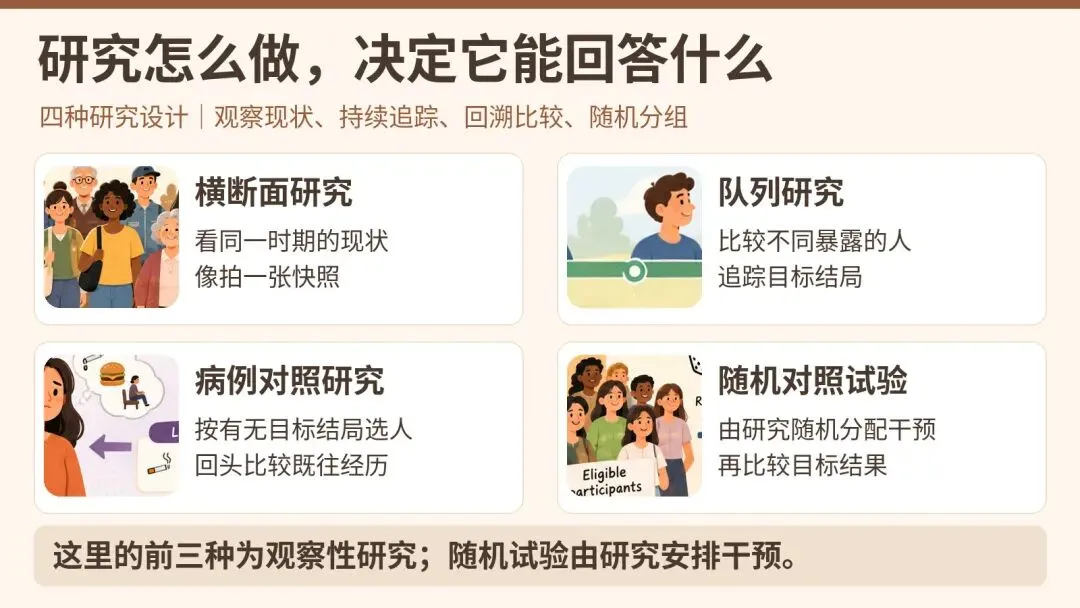
横断面研究像拍快照。 今天调查全校学生的阅读习惯和近视情况,看到的是同一时期的状态,常常难以判断先后。
队列研究像连续跟拍。 从一批尚未发生目标结局的学生开始,观察几年,比较不同习惯与后来结果的关系。也可以利用已经积累的历史记录来建队列,不一定都从今天向未来收集。
病例对照研究像先找结果再查经历。 先找有某种疾病的人,再从合适的同一来源人群中找对照,比较过去的暴露。它不一定靠回忆,也可以用原始档案。[2]
这里的“尚未发生”针对研究要追踪的那个结局。例如观察已患糖尿病的人以后是否发生某种并发症,仍可以是队列研究,并不要求所有参与者一开始都完全健康。[2]
研究看清了时间顺序,仍不等于自动排除了所有其他原因。
37. 敏感性分析
Sensitivity analysis|换一套合理假设,判断还稳不稳
你估算家庭下个月开支,其中一张账单还没到。先按过去均值估计,再按偏高和偏低的合理情况各算一遍,看家庭预算是否都够用。
如果换几种合理假设,判断仍差不多,就较稳健;如果一换假设,结论就翻转,就需要更加小心。
研究会更换合理的模型、缺失数据假设或其他分析设定,检查主要判断是否依赖某一种处理方法。不是随便换算到“显著”为止。[8]
P值从0.049变0.051,不代表效果被推翻。 要一起看效应量和区间;不同分析若回答的根本不是同一问题,也不能只按显著与否选胜者。
敏感性分析是在试着推敲结论,不是在寻找最好看的答案。
38. 亚组分析与事后分析
Subgroup / Post-hoc analysis|一个小组表现好,可能只是挑出来的
某课程对全班成绩没有明确帮助。再分男生女生、高低年级、原来成绩好坏,最后找到10个学生的提升特别明显。
这可能是值得追踪的线索,也可能是在很多分组中碰巧挑到了一个好结果。
“男生显著、女生不显著”,不能直接证明男生受益更多。 要直接检验两组效果之间的差异,也就是常说的交互作用检验。[8]
看过结果以后才想到的分析,叫事后分析。亚组也可以事先规定,二者不是同义词。阅读时还应找“主要终点”:研究原本最想检验什么,不能只突出后来挑中的漂亮结果。
主要终点、主要分析和关键时间点,最好在看见结果前规定,并可在注册或方案中核对。主分析不理想,不能事后换一个“最漂亮的结果”充当最初目标。报告规范帮助看清研究做了什么,本身不等于给研究质量盖章。[14]
先问这一组是不是事先约好的,再问是否真正比较了组与组的效果。
第六部分 · 39—40
统计结果漂亮,就代表现实中真的有用吗?
最后回到现实:证据够不够可靠,对目标人群有没有值得付出的实际获益?
39. 临床意义与替代终点
Clinical significance / Surrogate endpoint|数字变好了,真正关心的事变好了吗
一套课程每月收费几千元,研究发现能让考试平均多0.1分,而且统计显著。你还会问:这么小的提高,值不值得付出时间和钱?
临床意义或实际意义,关注的是改善是否重要,还要权衡风险、费用和负担。不是P值越小越值得用。[3]
再换一个角度:打字训练让练习软件得分大涨,但写作业速度有没有变快?软件得分是一个中间指标,真正关心的结果可能是实际学习表现。医学中也有类似的替代终点。
并非所有中间指标都不能用,而是需要验证它是否可靠地预测目标获益。不能看见某个生物指标改善,就自动宣布长期健康获益已经证实。
在医学里,替代终点是用来替代患者感受、功能或生存等直接临床结局的指标。并不是所有生物标志物都已经是合格的替代终点。它能否预测特定临床获益,需要在相应疾病和干预背景下验证。[15]
问两次:变好了多少?变好的,是不是我们真正关心的事?
40. 系统综述、Meta分析与证据确定性
Systematic review / Meta-analysis / GRADE|把研究放在一起,也要检查原料好不好
想评价一家餐厅,不能只挑好评看。先规定寻找与筛选方法,尽量收集相关评价,再检查哪些评价可靠——这有点像系统综述。
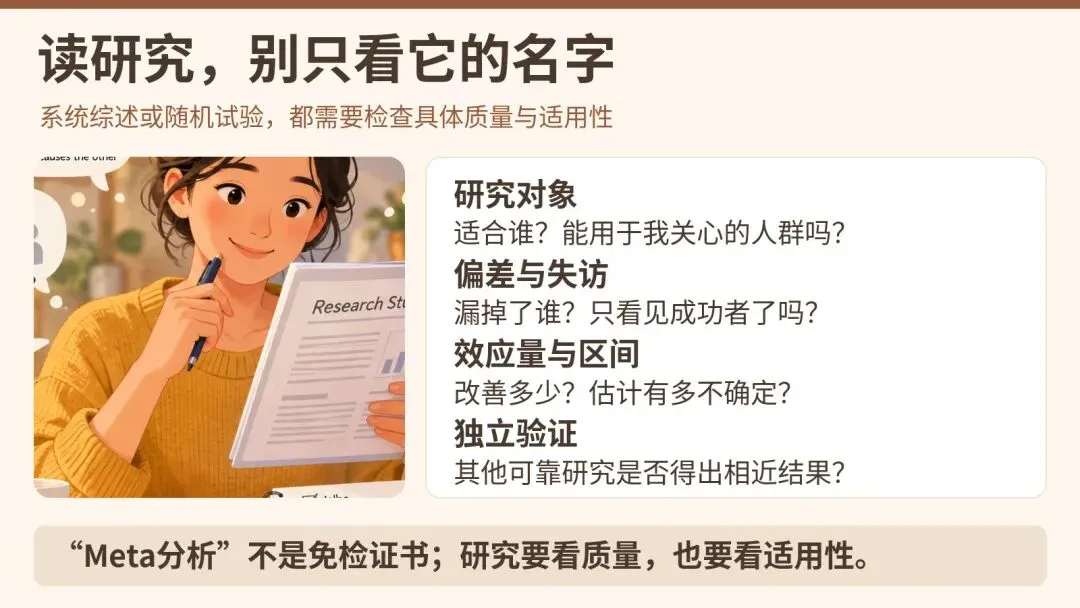
Meta分析进一步用统计方法综合适合合并的研究结果,不是简单数“几篇赞成、几篇反对”。研究差异太大或偏差明显,合并也不会自动变可靠。[8]
GRADE则评价针对某个具体结局的整组证据确定性,常分高、中、低、极低,考虑偏倚、结果一致性、与目标问题是否直接相关、估计精度和缺失研究等。它不是只给论文期刊或研究名称打分。[9]
还要问能否用到自己关心的人群:成年人研究不自动适用儿童,已经近视者的治疗研究不自动证明能预防尚未近视者。这就是适用性或外部有效性的问题。
因此不要把“系统综述一定比RCT可靠”画成无条件的排名。不同结局的证据确定性可能不同;同一干预的短期获益较确定,不代表长期安全性也同样确定。[9]
多篇研究能提供更多信息,但“多”不能替代“好”和“适用”。
第七部分 · 实战阅读
同一篇论文,为什么会读出三种结论?
现在用一篇真实研究练习。2026年9月7日发表的探索性试验纳入40名8—12岁、已经近视的儿童,随机分为LED红光组与假治疗组,各20人,全部完成3个月随访。研究关注眼轴增长等变化,不是统计这40名孩子中有多少人首次近视。[11]
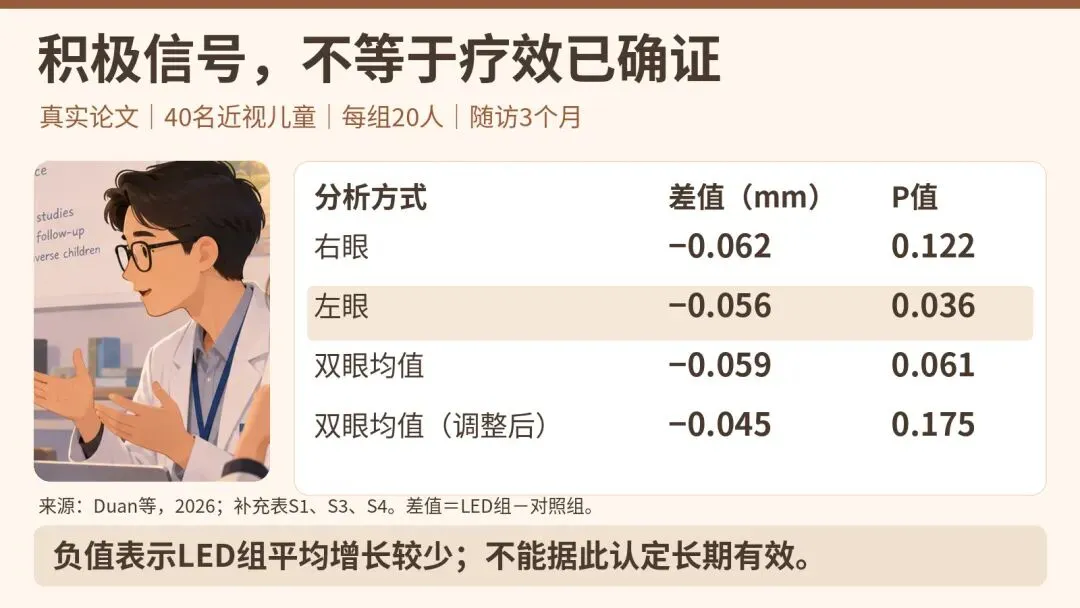
先看数据,再看解释
下表中的差值为“LED组减去对照组”,负值表示LED组平均眼轴增长更少。[12]
调整因素为基线双眼均值、年龄和性别。未经调整的双眼均值差异95%置信区间为−0.121至+0.003 mm;调整后为−0.111至+0.021 mm。右眼单独分析的区间为−0.140至+0.017 mm,左眼为−0.109至−0.004 mm。[12]
同一张表,可能被读成三种故事
只看平均差:“两只眼都长得少,已经证明有效。”这忽略了不确定性。
只看右眼P值:“没有显著,所以完全无效。”这把没有充分检出,读成了已经排除作用。
一起看研究设计、效应量和区间:“方向值得继续研究,但证据还不够稳健。”这更符合研究本身能够支持的范围。[11]
左眼达到名义统计显著,不能改说两眼都不显著;但“左眼显著、右眼不显著”,不能证明左右眼疗效不同。论文明确说明双眼均值分析是在同行评议阶段增加的敏感性分析,它不是事先设定的另一个独立确证试验,也不能仅凭调整后P值更大就认定该算法天然更正确。[11][13]
左右眼分别比较,本身不等于把80只眼混当成80个独立孩子;参与者双眼均值是另一种分析单位。此处综合报告各项结果,而不是只挑最有利或最不利的一个。[8]
研究期间没有报告严重不良事件,但记录到两组合计5只眼裸眼视力下降至少2行,最佳矫正视力并未出现至少2行下降。“没有发现严重事件”不等于“已证实长期安全”。3个月的眼轴差异也不能直接乘4当作一年疗效,更不能推广成对尚未近视儿童的预防效果。[11]
这项研究有初步积极信号,但小样本、短随访和整体分析的不确定性,仍不足以确认疗效或长期安全性。[11]
看完这个案例,可以回到最初的问题:分歧有时不是谁多知道一个数字,而是谁少看了一个数字背后的条件。
结语
别换数据,也别换尺子
以后看到“风险降低一半”,先问针对谁、什么事件、多久以及原来的风险;看到“成功者都这样做”,先问失败者呢;看到“孩子一下进步20分”,先问他平时考多少。
不必一口气记住所有术语。先把三个问题留在脑子里:
研究看见了什么? 是一组人的表现,还是两组之间的差异?
还有什么解释? 是新方法起作用,还是原本不同、自然波动、只看见留下来的人?
证据能支持到哪一步? 是值得研究的线索,还是已经有较稳健的证据?对目标人群是否适用?
更难的一关,是面对自己喜欢的答案。
如果支持你观点的研究有100人,你觉得“很有说服力”;反对你观点的研究同样有100人,你却觉得“样本太小”——问题可能不在两篇论文,而在于我们换了尺子。
下次遇到一项恰好支持自己观点的研究,试着问:如果结果相反,我还会接受同样的研究方法吗?
同一份证据,也可能因为两个人对费用、不便和风险的接受程度不同,导向不同选择。科学判断尽量用同一把尺子;个人选择则需要诚实说明自己的取舍。不能把“我觉得不值得用”改写成“科学已经证明没效果”。
读懂研究,不是学会替每个结论挑毛病,而是学会对喜欢和不喜欢的结论,使用同一把尺子。
参考资料
重要概念与实战数据的出处
文中编号对应下列来源。生活类比用于帮助理解,不能替代对具体研究的完整评价。
[1] 美国统计协会(ASA)P值与统计显著性声明,2016。核心原则及官方说明。查看原始来源DOI:10.1080/00031305.2016.1154108
[2] 美国疾病控制与预防中心(CDC)Field Epidemiology Manual:Analyzing and Interpreting Data。研究设计、混杂与偏差。查看原始来源
[3] Cochrane Handbook,第15章Interpreting results and drawing conclusions。置信区间、显著性、临床解读与NNT。查看原始来源
[4] Cochrane Handbook,第6章Choosing effect measures and computing estimates of effect。效应量、RR、OR、风险差与HR。查看原始来源
[5] Cochrane Handbook,第8章Assessing risk of bias in a randomized trial。随机、盲法、缺失数据及选择性报告。查看原始来源
[6] Bland JM、Altman DG,BMJ,1994Some examples of regression towards the mean。均值回归的教学说明。查看原始来源DOI:10.1136/bmj.309.6957.780
[7] Cochrane Handbook,第13章Assessing risk of bias due to missing evidence in a meta-analysis。发表偏差与缺失证据。查看原始来源
[8] Cochrane Handbook,第10章Analysing data and undertaking meta-analyses。分析单位、亚组、敏感性分析与研究合并。查看原始来源
[9] Cochrane Handbook,第14章Completing Summary of findings tables and grading the certainty of the evidence。GRADE评价。查看原始来源
[10] 国际近视研究院(IMI),2025IMI—2025 Digest:教育、近距离活动、户外时间等因素的更新。查看原始来源DOI:10.1167/iovs.66.12.27
[11] Duan Y、Qi Z、Yu F等,Ophthalmology and Therapy,2026Effect of Photobiomodulation-Based LED on Myopia Control in Children: An Exploratory Randomized Clinical Trial。2026年9月7日在线发表。查看原始来源DOI:10.1007/s40123-026-01498-8
[12] LED试验补充材料Supplementary Tables S1、S3、S4:单眼、双眼均值及调整后分析。查看原始来源
[13] Altman DG、Bland JM,BMJ,2003Interaction revisited: the difference between two estimates。直接比较效应,而非比较两组P值或区间是否重叠。查看原始来源DOI:10.1136/bmj.326.7382.219
[14] Hopewell S等,CONSORT 2025Updated guideline for reporting randomised trials。预设结局、分析人群、盲法、失访与透明报告;报告规范不是质量评分工具。查看原始来源DOI:10.1136/bmj-2024-081123
[15] 美国食品药品监督管理局(FDA)Surrogate Endpoint Resources for Drug and Biologic Development。临床结局、候选及经验证替代终点。查看原始来源
[16] NIST/SEMATECH统计手册词汇表本文仅用于核对Pearson相关系数、标准差、标准误与抽样相关词条。查看原始来源

发表评论
发表评论: