
 研报速递
AI科普馆部分垂类内容转移至👆
【长三角人工智能联盟】公众号,快点进去瞧瞧!
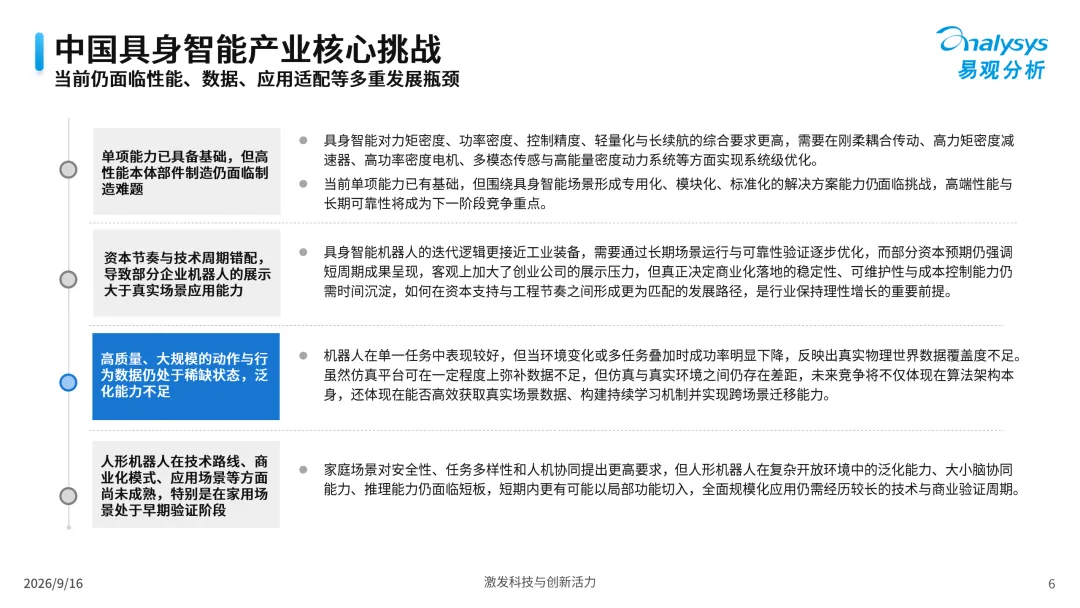
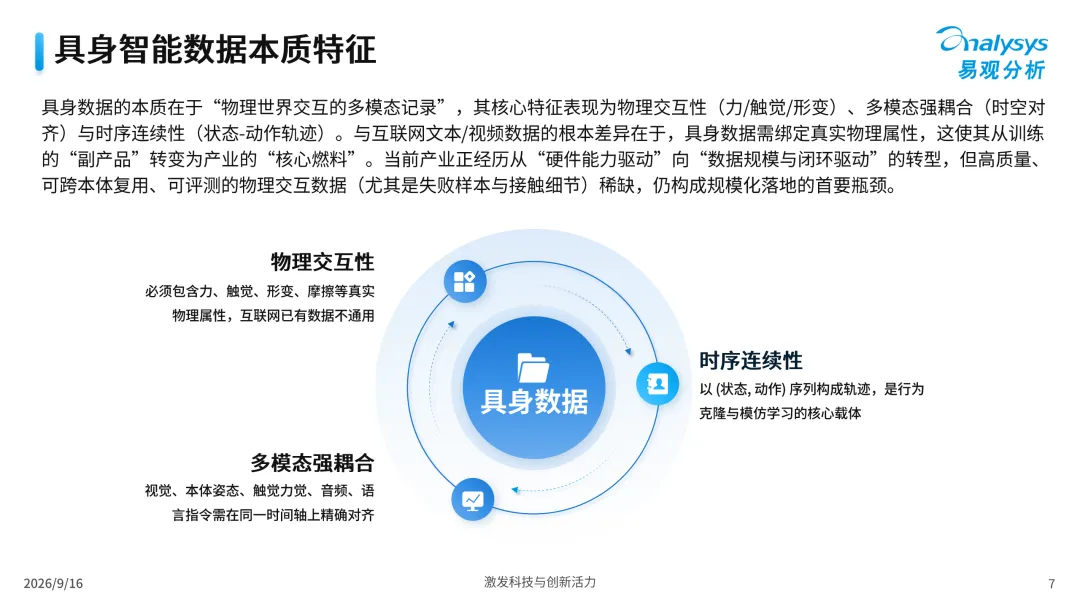
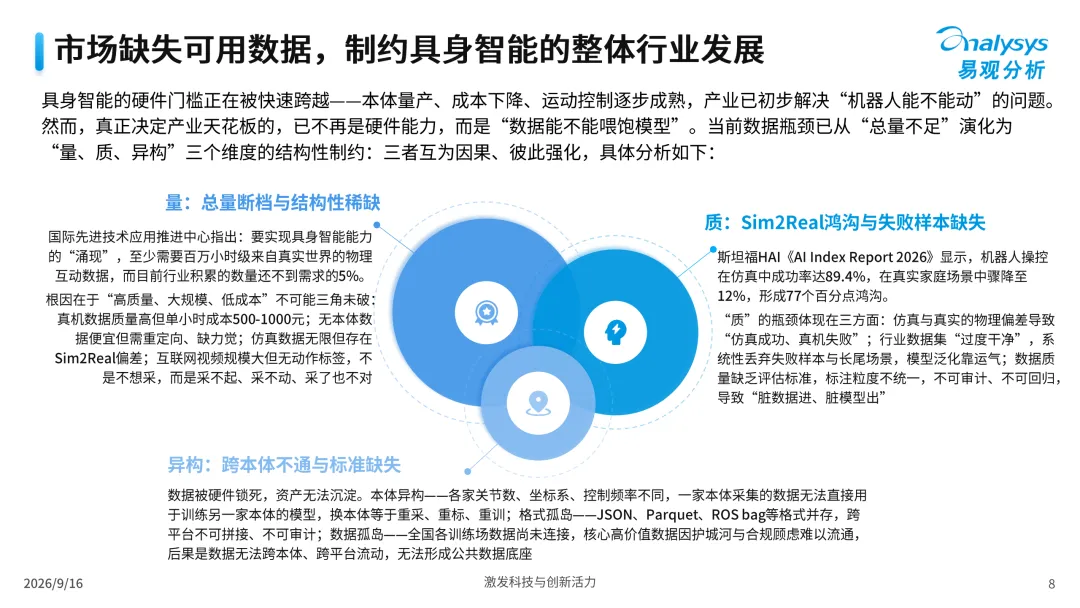
机器人操控在仿真环境中的成功率是89.4%,换到真实家庭场景骤降到12%。斯坦福HAI《AI Index Report 2026》测出的这77个百分点落差,指向具身智能当下真正的瓶颈:已经不是硬件,是数据。
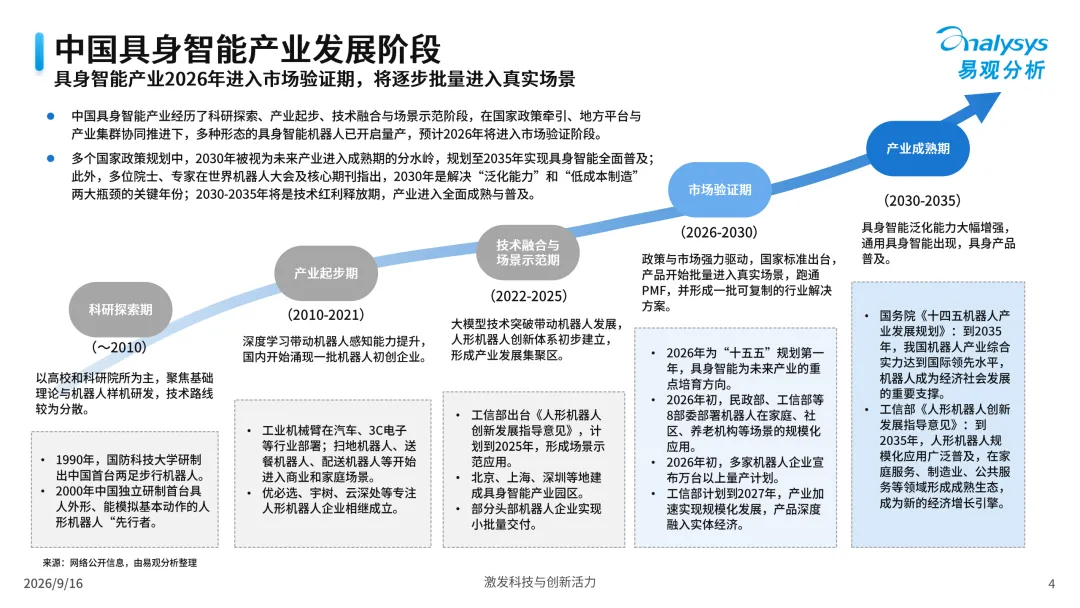
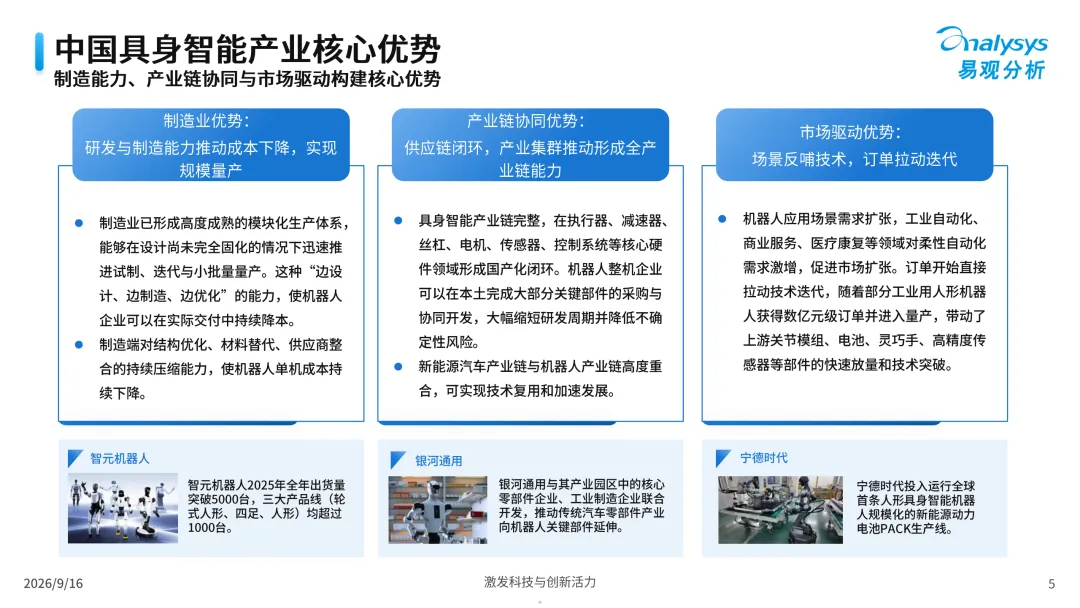
机器人"能不能动"的问题,产业基本解决了——本体在量产、成本在下降、运动控制在成熟。但易观分析这份报告给出的判断是,决定产业天花板的不再是硬件能力,而是"数据能不能喂饱模型"。
缺口不在"不够",是三个维度同时卡住
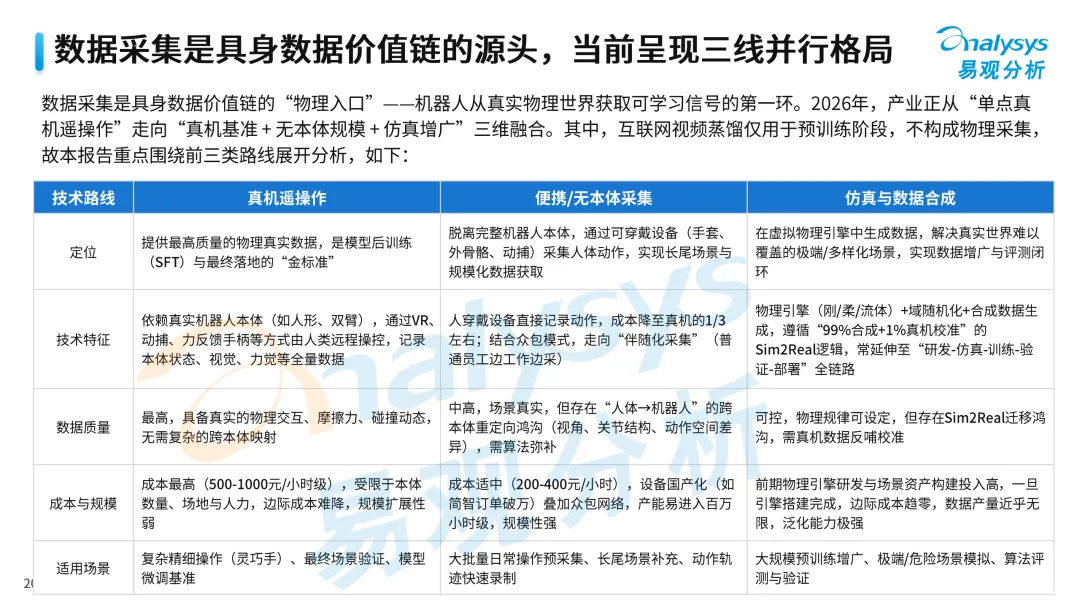
一是量。要实现具身能力的"涌现",至少需要百万小时级的真实物理互动数据,目前行业积累还不到需求的5%。卡点在于"高质量、大规模、低成本"不可能三角:真机数据每小时500至1000元;无本体数据便宜,但要重定向、缺力觉;仿真数据近乎免费,却有Sim2Real偏差;互联网视频规模最大,但没有动作标签。
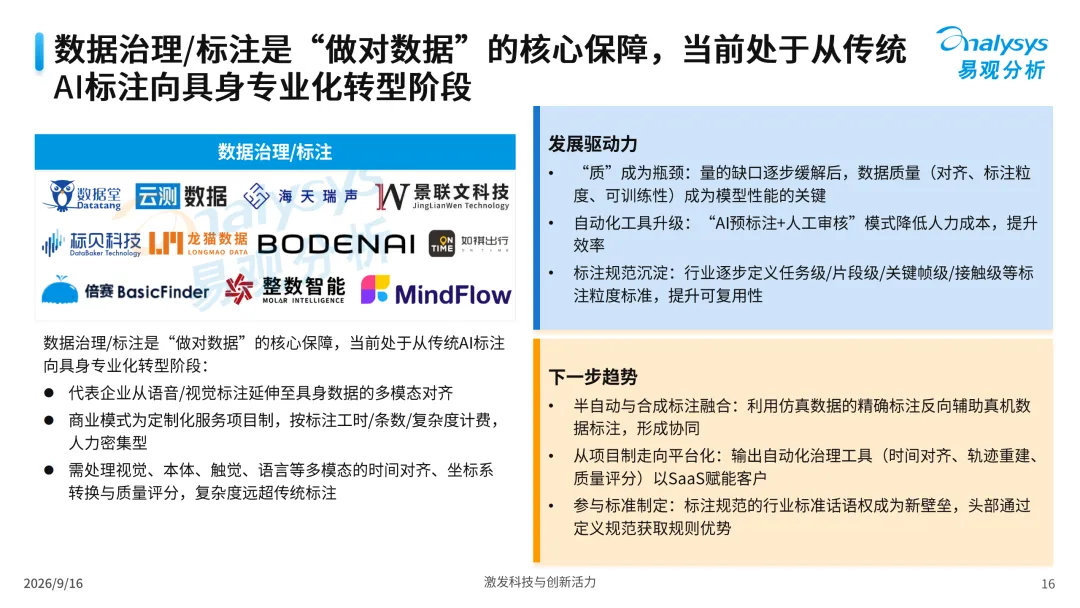
二是质。行业数据集"过度干净",系统性丢弃失败样本与长尾场景,模型泛化靠运气;标注粒度不统一,数据不可审计、不可回归——脏数据进,脏模型出。
三是异构。各家本体的关节数、坐标系、控制频率都不同,一家采集的数据喂不了另一家的模型,换本体等于重采、重标、重训;JSON、Parquet、ROS bag等格式并存,跨平台不可拼接。结果是数据被硬件锁死,资产无法沉淀。
三条采集路线不是竞争,是分工
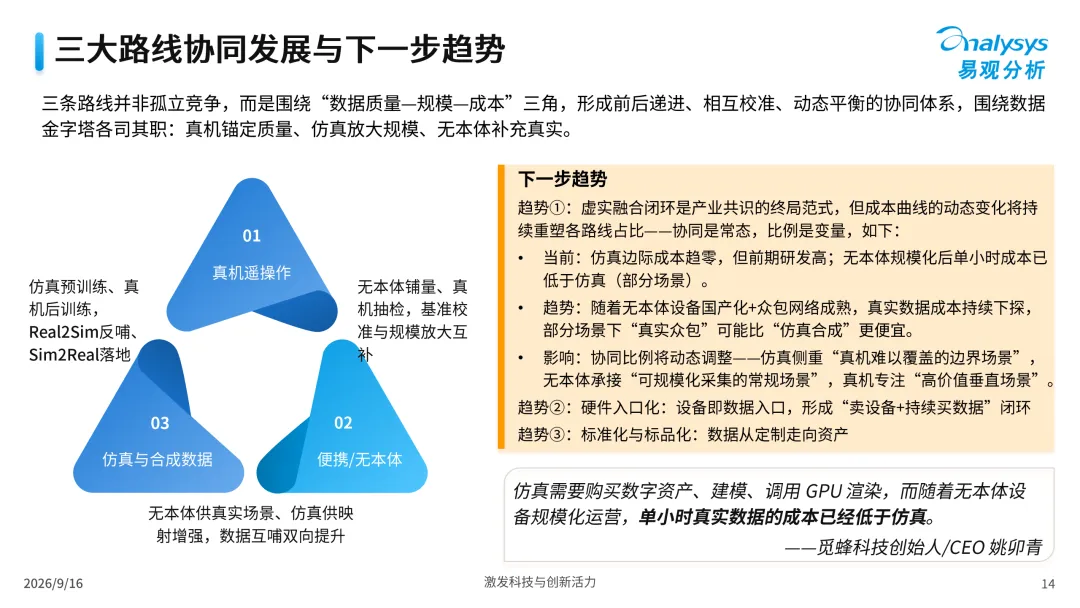
真机遥操作质量最高,是模型后训练与最终落地的金标准,也最贵;无本体采集让人穿上设备干活,成本降到真机的三分之一,还能靠众包走向"边工作边采";仿真合成负责长尾与极端场景,遵循"99%合成加1%真机校准"的逻辑。
报告对此的定性很清楚:单一路线破不了不可能三角。真机锚定质量,无本体补充真实,仿真放大规模——协同是常态,比例是变量。
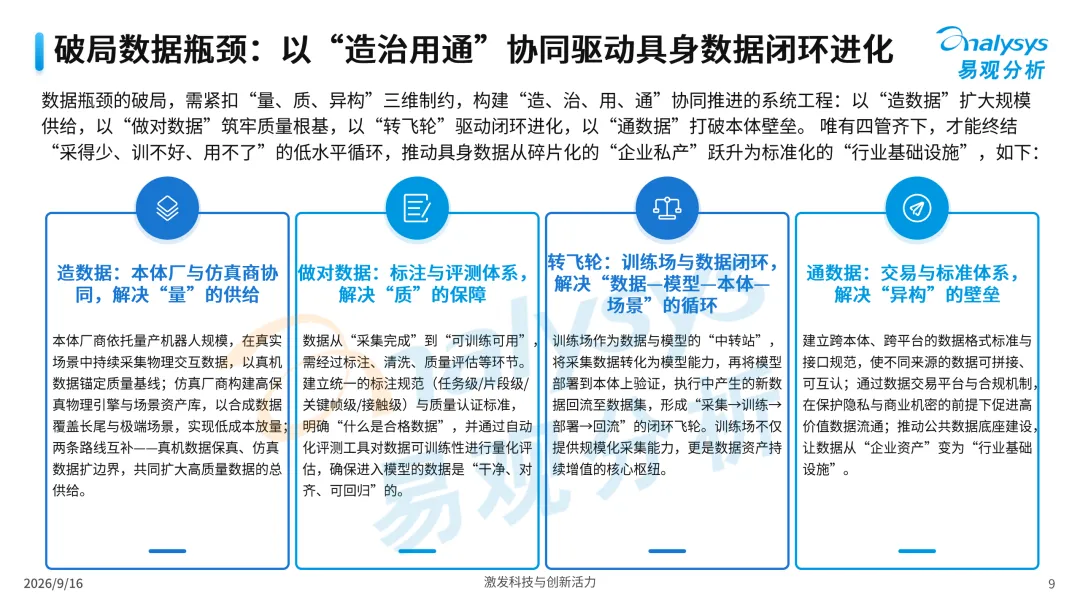
破局的四件事
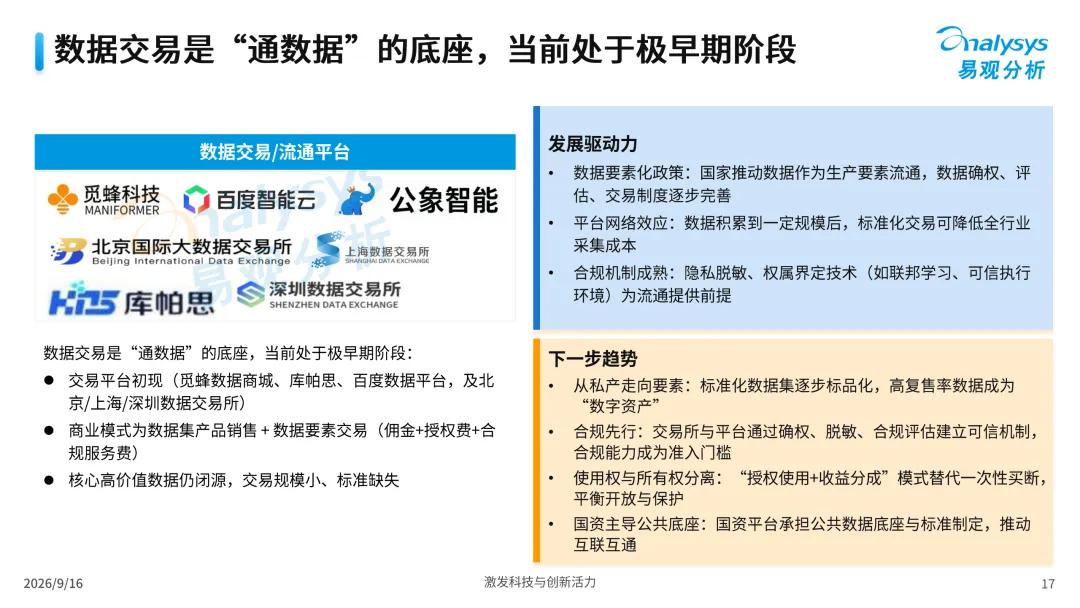
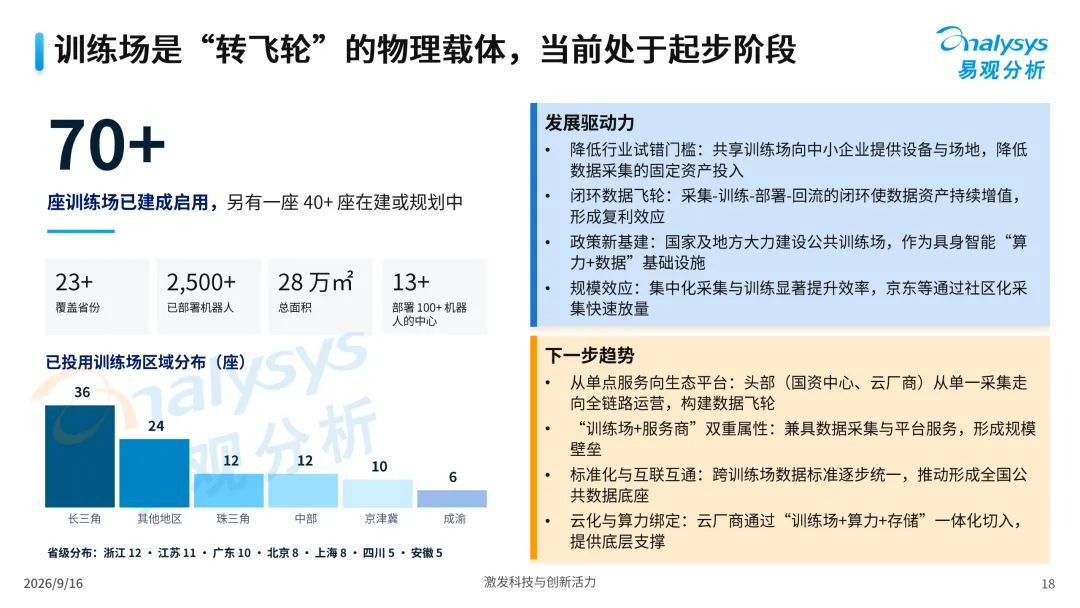
报告把解法归成四个字:造、治、用、通。造数据靠本体厂与仿真商协同扩规模;做对数据靠标注规范与质量认证,回答什么是合格数据;转飞轮靠训练场把采集、训练、部署、回流连成闭环;通数据靠跨本体的格式标准与交易机制。
四件事里最难的是"通"。前三件各家企业自己就能推进,唯独它要动利益——数据从企业私产变成行业基础设施,等于要求掌握高价值数据的公司让出护城河。
刚起步的行业,已经在预警过剩
报告里最反直觉的是趋势研判:行业正在经历产能军备竞赛,但结构性过剩已经显现——原始数据贬值与高难数据稀缺同时存在。
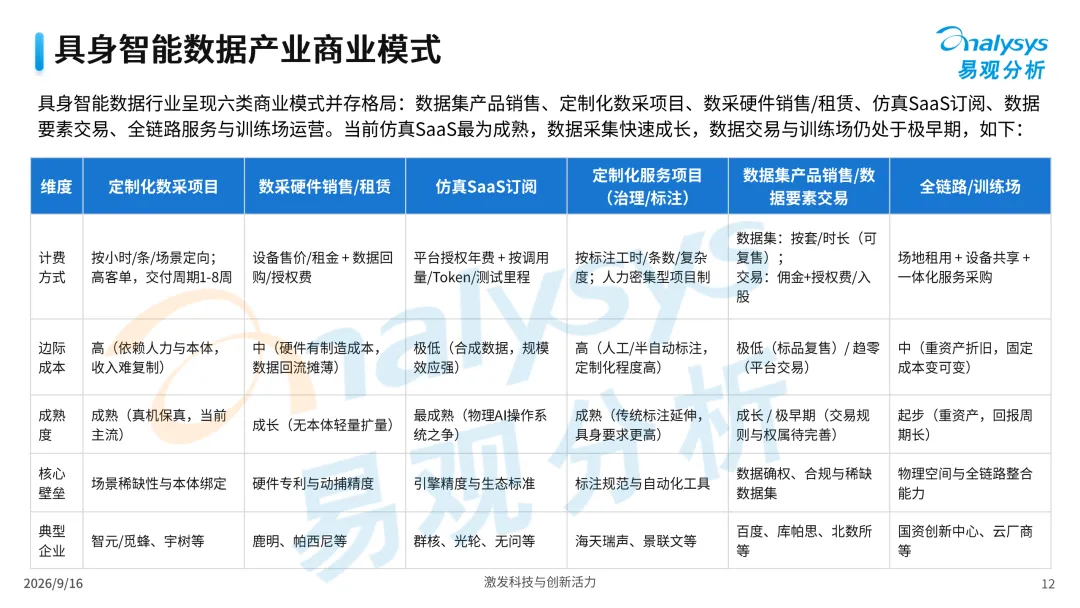
原因有三。数据生产权正向有本体、有场景的下游迁移,头部本体厂商和基座模型公司把数据生产内化,外购需求随之收缩;模型训练范式从"海量外购数据依赖"转向少样本学习加强化学习自进化,进一步压缩外购空间;定价方式也在变,从按小时、按条数计费转向按任务难度定价——长时序、强泛化、复杂操作的高难任务溢价凸显,低难任务价格趋零。
数据不再按小时卖。新的价值标尺是"有效信息密度×闭环增益",静态数据集的价值窗口正在收窄。
最能说明问题的是收入表
群核科技手上有5亿多个结构化3D场景、4.8亿个带物理参数的3D模型,获取成本在过去十余年里已摊销完毕。但它的具身业务收入是:2024年340万元,2025年520万元,占总营收不到1%。报告的评价是故事与收入落差大——它的家居场景很强,工业与物流很弱,恰好错开了付费主战场。
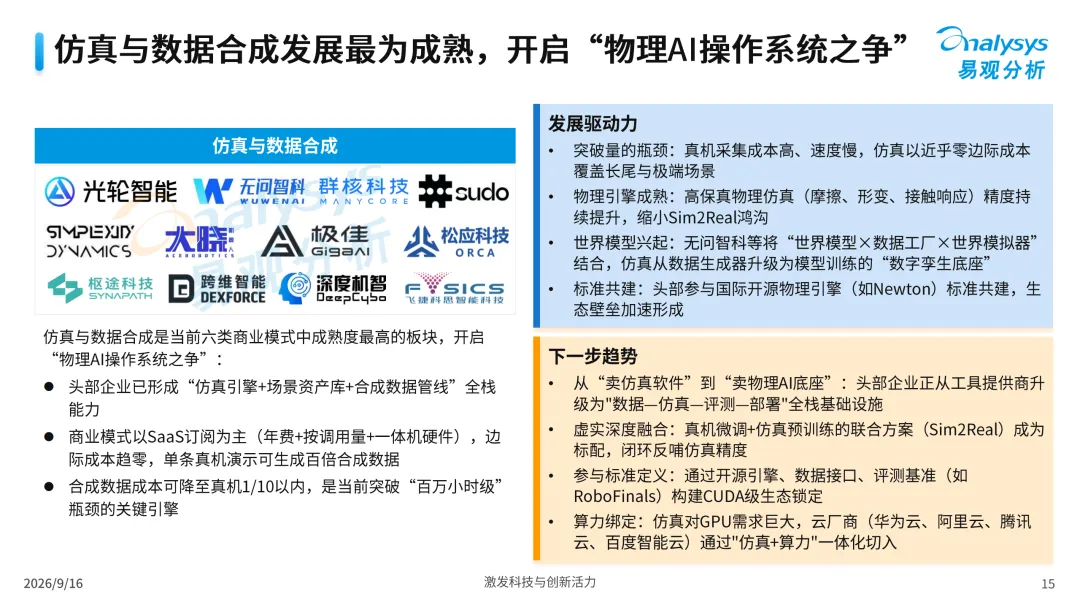
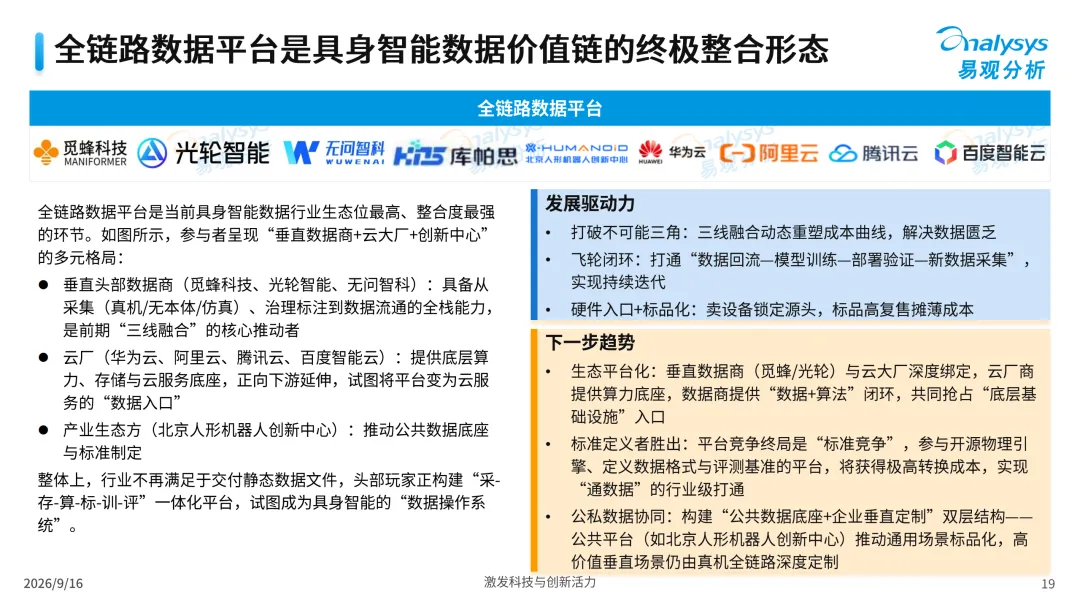
同一赛道上的另一种活法:光轮智能2026年一季度新增订单5.5亿元,单季收入超过2025年全年,靠的是把仿真路线边际成本压到真机的1%左右;无问智科订单同比增长超3000%,客户复购率超80%。
报告因此写下一句可以直接当尺子用的话:资产绝对量没有意义,场景匹配度才是兑现开关。
下一轮竞争是标准
训练场正在成为公共底座:70多座已建成启用,覆盖23个以上省份,部署机器人2500多台,其中长三角36座最密集。数据要素化也在推进——确权、评估、入表、交易。
报告点出一个明显的空白:现有评测机构大多既卖数据又办考场,中立性代价明显。谁能做出"不卖数据、只办评测"的独立第三方,谁就能直接吃掉这部分中立性溢价。
竞争的终点也随之换了:从卖数据,转向定义数据价值的标准。
本文基于易观分析《中国具身智能数据产业分析报告2026》撰写,详细内容请查阅原文。
以下是内容节选↓↓↓ 文末点击链接免费下载pdf,扫二维码加入交流群
AI科普馆:打开AI世界之窗

发表评论
发表评论: