
 研报速递
-点击蓝字丨关注我们
智物发展|简介
AIOT Development
Introduction
////
上海洲铂智能科技发展有限公司(智物发展|AIOT Development)是基于大数据的产业服务平台。平台围绕区域经济发展需求提供一站式服务,拥有全球合作资源优势,聚焦“创新创业、产城融合”,通过开展区域产业研究与规划、高层次人才引进、产业导入、科创中心建设运营、总部经济和企业服务等业务,致力于打造“人、产业、城市”三位一体、高度融合的全新生态体系。
中信证券-AI存算一体化深度研究报告
1 AI时代需要什么样的存储?
1.1 AI时代,存储中显存(DRAM)容量及带宽升级是重点
AI产品中存储架构分三级,二级存储XPU旁边新增显存DRAM。以AI服务器为例,主要变化在于传统存储DRAM和 NAND容量需求大幅升级,同时显存高带宽需求下,HBM配合GPU而生。显存DRAM为核心增量,对容量/带宽要求高。
不同场景的显存升级侧重:训练侧容量带宽需求全面提升,推理侧带宽需求突出。
训练端:计算密集型,算力升级为核心诉求;显存容量是基础要求,需要匹配升级;显存带宽是重要辅助,有助于提升算力利用率,共同提升性能表现。显存容量需求高于16倍参数量(理论值),带宽需求TB级。产品选择上,新型存储HBM为主流。
终端推理:访存密集型,显存带宽升级是重点。终端推理容量需求较低,约为模型参数容量的1.2倍;同时功耗要求可控。产品选择上,目前行业的新产品正处探索阶段,趋势为先进封装赋能产品走向小型化与定制化;中长期存储大厂或推出带宽优化的标准品。
云端推理:访存密集型,多用户并发下访存瓶颈加剧,显存为核心升级需求。m个用户并发,适当采用批处理,则云端推理带宽需求是端侧推理的m倍,容量提升倍数低于带宽,功耗要求较端侧宽松。产品选择上,HBM为主, GDDR/CUBE 2.0等为补充。
大模型优化影响:
有效降低单个模型推理的存储需求:显存容量和带宽需求,通过算法和架构的分布式优化;
急剧增加AI应用的推理需求:应用场景变多,用户并发变多,更多存储容量和带宽需求
1.2 AI服务器:整体价值量中包含显存的GPU为核心增量
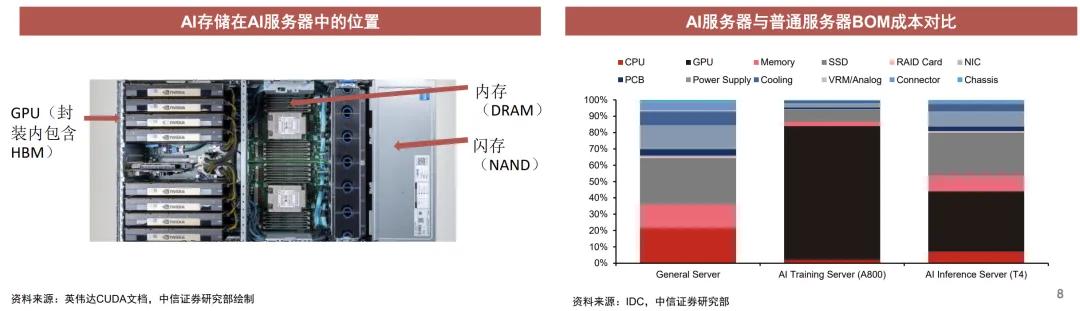
普通服务器(CPU+存储):主要由CPU、内存、SSD存储构成,配合PCB、电源、散热、机箱等基础部件。总价值量约6.5万元,其中CPU接近1.9万元,占比22%,存储(内存+SSD+RAID)合计约3.7万元,占比超过一半。
AI服务器(GPU+高性能配套):在CPU基础上增加GPU/AI加速卡(含HBM),配备更大容量的内存与SSD,并升级电源与散热。总价值量:训练型(8×A800)约90万元,推理型(4×T4)约23万元。分项价值量:训练型GPU约76万元 (占比80%以上),推理型GPU约9.6万元(占比42%)。CPU保持约1.9万元,内存与SSD合计约9万元。
对比而言:GPU是AI服务器的主要增量部分,占比由0提升至42%–80%以上,同时GPU中封装显存(GPU中占比近半)。CPU占比由近30%下降到不足10%。存储绝对值增加,但占比下降(由>50%降至约10%)。PCB、电源、散热显著升级, 带动配套成本提升。
1.3 AI服务器存储的价值量分布:三级存储,量价齐增,新增显存DRAM
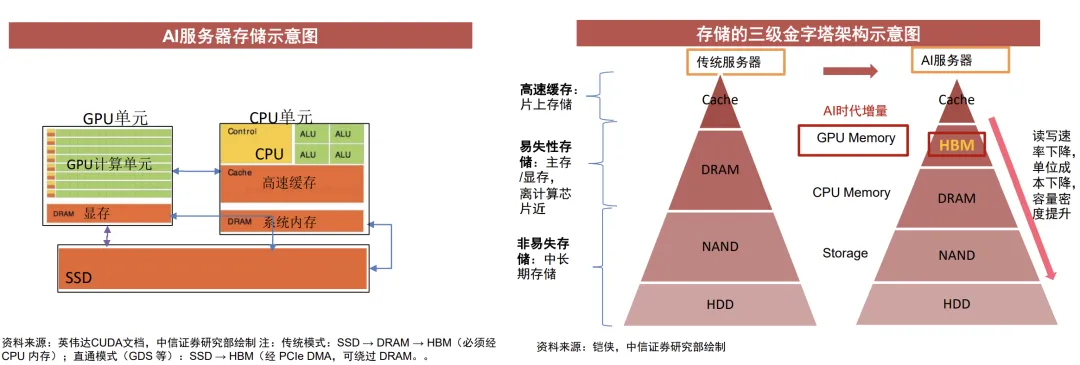
典型的存储系统采用金字塔型三级架构,通过速度-容量-成本的梯度平衡实现效能最大化。按照同容量下速率、成本由高到低分别为:
一级存储:高速缓存Cache(价值量在AI芯片占比或超40%) :CPU/GPU等的芯片实现,用SRAM单元实现,和逻辑单元通讯带宽最高, 价值量是算力芯片一部分,CPU上面积/价值量占比超过20%,AI芯片上占比或超过40%,难拓展,否则芯片面积过大
二级存储:易失性存储(AI服务器中占比25~35%):系统内存DRAM是存量,面向CPU需求存储操作系统、应用程序及通用数据,可被 CPU/XPU通过PCIe总线共享;显存DRAM是增量,是专门用于GPU/TPU等的高速随机存取存储器,独立于系统内存,直接与GPU等通信, 配合算力采用更高带宽减少数据延迟,为AI时代核心增量需求,当前主要采用高带宽的DRAM(如HBM);
三级存储:非易失存储(占比5-10%):中长期数据则存储与SSD与HDD中,这两类存储具备非易失性,断电后数据仍能保留。
1.4 AI服务器存储变化1:三级存储容量均增加,相对传统2~4倍
AI服务器中的传统产品升级:单机SRAM容量随计算芯片数量提升;NAND和DRAM容量随存算需求大幅提升,带动价值量数倍提升。
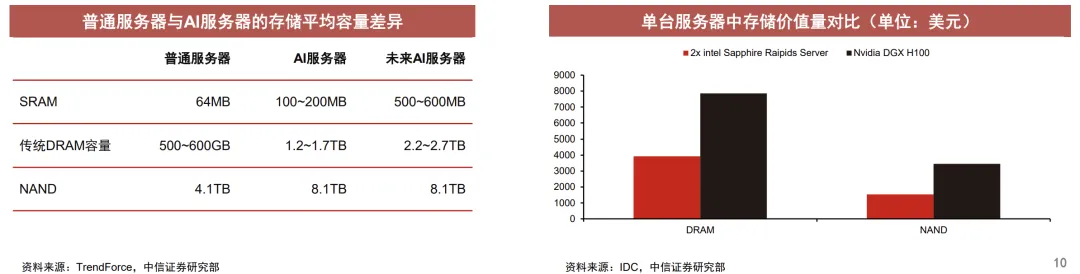
SRAM:GPU/CPU上均有搭载片上存储,单位面积成本高,先进工艺下微缩困难,单片容量扩展有限;AI服务器较普通服务器的SRAM 容量提升,主要随算力卡数量线性增长,据Trendforce数据, AI服务器SRAM配置在100~200MB,约为传统服务器的2~3倍。
传统DRAM(非显存DRAM):大模型海量训练和推理需求需要CPU进行大量任务处理和资源调度工作,期间产生大量的暂存运算数据需求,需要更高的内存容量。根据TrendForce,目前服务器DRAM配置普遍约为500-600GB左右,而AI服务器单条模组容量为64-128GB, 平均单台容量可达1.2-1.7TB,约为传统服务器的2-3倍;AI推理服务器的推理卡搭载GDDR/LPDDR也将贡献一定传统DRAM增量需求, 以DGX A100 8卡AI服务器为例(下同,整机价值量约20万美金),单台AI服务器中价值量约17000美金(BOM占比10%)。
NAND:负责存储海量数据,由模型数量、模型参数量、数据集体量等共同决定。在AI服务器中,NAND主要存储训练数据集、模型参数和中间结果,其需求在训练端远高于推理端:训练阶段需大容量、高耐用性NAND以支持海量数据处理,而推理阶段需求较低,但需实时 更新数据以优化模型输出。根据英伟达官网,以DGX A100 、DGX H100 SXM5为例,硬盘容量为15-30TB,是传统服务器的约2-4倍, DGX A100 8卡服务器中SSD单机价值量约19000美金(BOM占比9%),是普通服务器的2倍。
1.5 AI服务器存储变化2:二级新增显存DRAM(HBM是典型),配合GPU高带宽需求
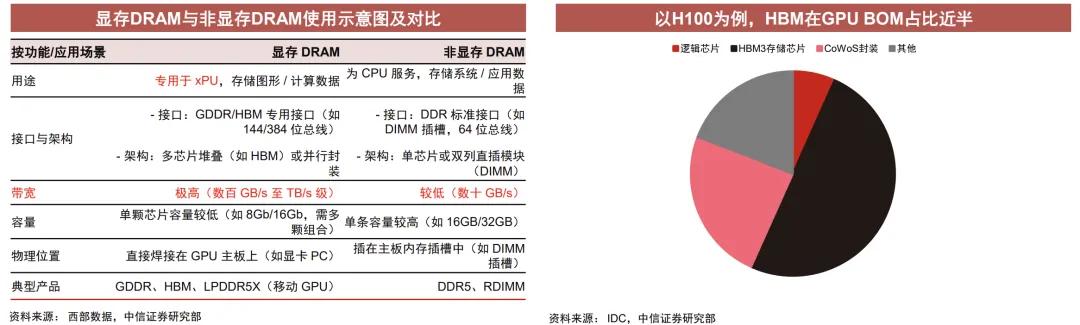
AI时代新增显存需求,性能核心要求在于高带宽。AI时代新增专门用于xPU的高速随机存取存储器,我们将之称为显存DRAM,独立于系统内存,直接与xPU通信,配合算力采用更高带宽减少数据延迟,为AI时代核心增量需求。带宽而言,显存带宽在训练端有助于提升算力利用率及性能,推理端则是性能表现的核心决定因素,云端带宽需求可达几TB/s~几十TB/s。容量而言,一般训练端显存容量理论需求为模型参数量的16倍,推理侧为2~4倍。
为满足高带宽及容量需求,HBM等新型存储应运而生。HBM(High Bandwidth Memory,高带宽存储) 采用 3D 堆栈工艺的内存架构,通过将多个 DRAM 芯片垂直堆叠并采用硅穿孔(Through Silicon Via,TSV)和微凸块(micro-bump)连接实现垂直方向的通信,形成内存堆栈, 再通过2.5D/3D封装和AI芯片(如GPU)进行集成,HBM具有高带宽的特性,更适用于配合处理高并发工作任务。当前主流HBM3E单颗带宽接近1TB/s,约为DDR5的20倍,单颗GDDR6X的10倍。
HBM成为GPU及AI服务器重要成本项。HBM配合GPU而生,当前单台AI服务器中HBM合计容量有320~640GB,未来AI服务器中有望升级至 512~1024GB;价值量来看,单台AI服务器的HBM价值量超过18000美金,BOM占比10%;以H100为例,HBM在GPU BOM中占比近半。
【完整研报免费获取】:关注公众号,发送关键词100802,即可获取!
东吴证券-AI影视深度研究报告
【AI Report】可控核聚变 深度研究报告
智物发展「2026年大数据招商」|1693 AI影视内容研发与制作基地项目
智物发展「2026年大数据招商」|1692 AI数字能源基础设施项目
长
按
关
注
「区域产业发展智库,基于大数据的产业服务平台」

发表评论
发表评论: