
 研报速递
让大模型帮忙写技术调研的同学,多半收过这种稿子:正文流畅得像模像样,引用却时不时张冠李戴——同一篇文献被安到不相干的论断上,有的句子干脆无据可依。想稳一点,就得换多步流水线:先检索、再聚类、再逐节生成,一份报告等两三分钟,账单也跟着涨;数据敏感的团队还多一层顾虑,问题根本不能发到外部 API。
10 月 2 日,Ai2 开源了 AstaBrief 8B。这个基于 Qwen3-8B 的模型只做一件事:输入一个研究问题和检索到的文献摘录,一次生成整篇带引用的报告,不逐节拼装。它已经部署在 Asta 平台的报告功能里当 Fast mode,和 Claude 驱动的 Thinking mode 并列;权重、训练数据和示例工作流全部开放,协议是 Apache-2.0。
训练数据围着引用转
AstaBrief 没走强化学习,用的是监督微调加 DPO。SFT 数据来自 Asta 平台真实科研提问筛出的 9 万条查询,用 Claude、o3、GPT-4.1 等多套系统生成 4.7 万份带引用报告;DPO 配对由 GPT-4.1 和 DeepSeek-R1 两个裁判模型打分(与人类偏好一致率 95),只保留双方一致的大约 6 千对。
真正见效的细节在过滤。团队试了四种统计过滤器,收益最大的不是最复杂的组合,而是最简单的引用密度——训练报告里有多大比例的句子真的挂着引用。低引用密度的样本剔掉,模型的归因行为立刻收紧。这相当于把“请引用文献”从提示词里的祈使句,变成了训练数据里的既成事实。
引用精确率从 76 到 90
在 ScholarQA-CS2 测试集(100 个真实科研提问)上,裸 Qwen3-8B 的引用精确率 76.2,SFT 之后 87.7,DPO 之后 90.5——同一个底座,三步训练把“引用是否支持它附着的那句话”抬了 14 个点。同一测试集的综合分 87.0,咬住 Claude 流水线的 86.2,对后者的胜率 72;DR-Tulu-8B 的 88.8 略高。速度上,Asta 里的 Fast mode 平均 51.1 秒出一份报告,Thinking mode 是 178.5 秒,约 3.5 倍。
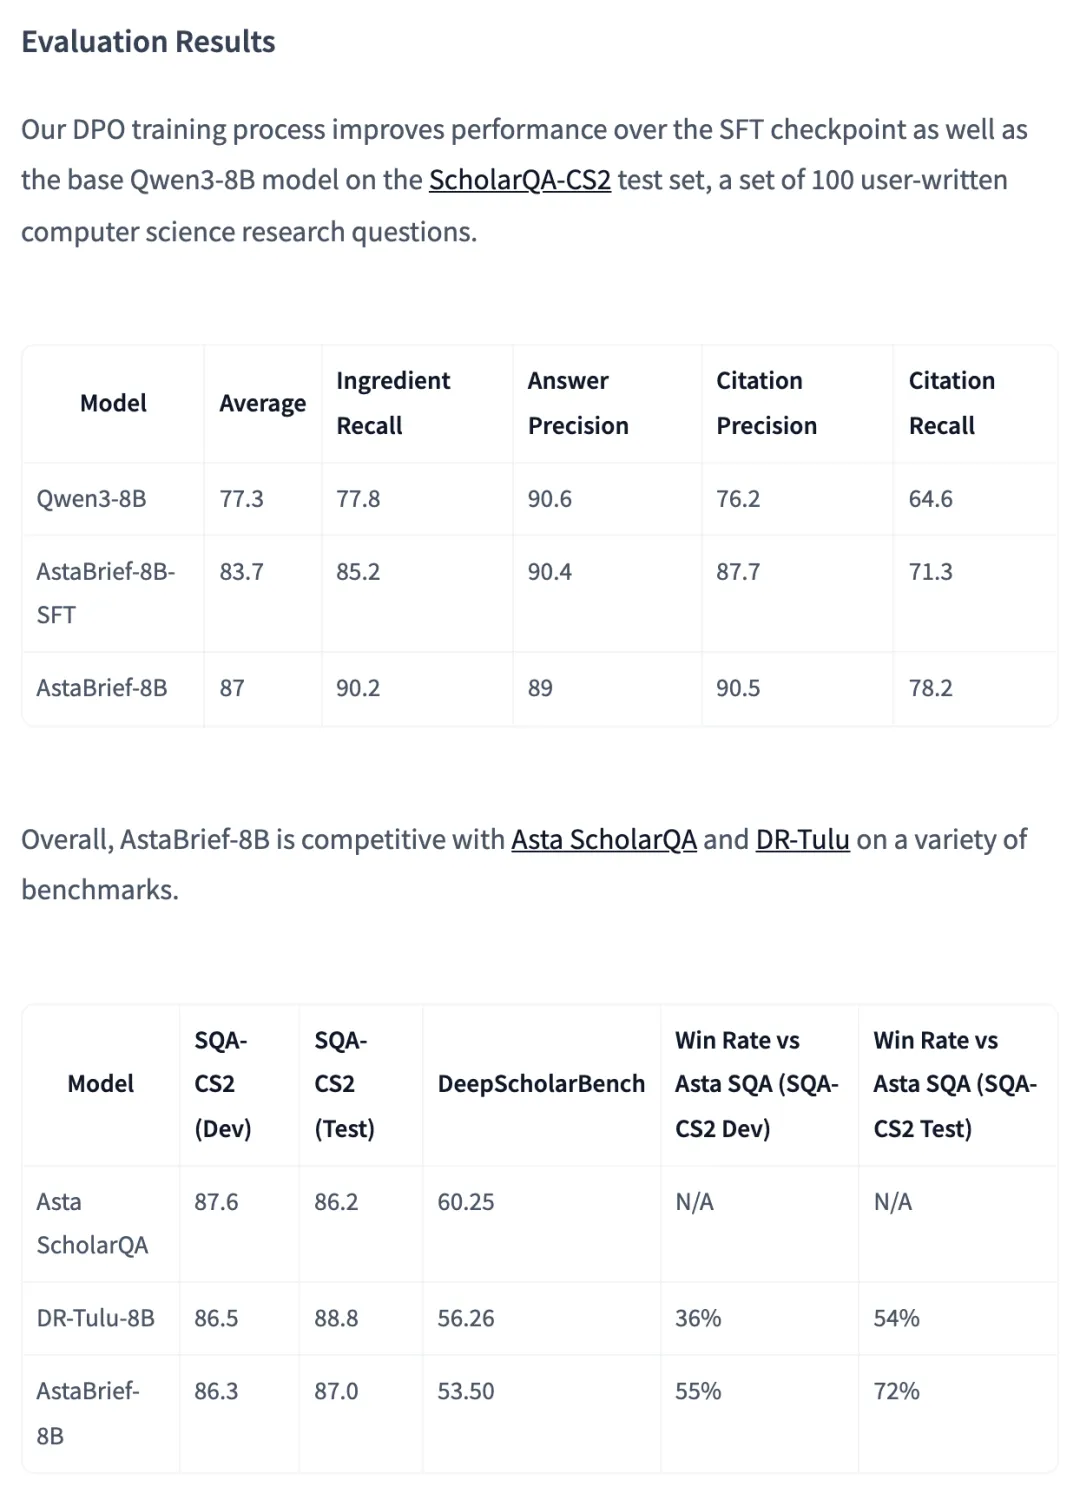
▲ Hugging Face 模型卡评估表(2026-10-03):同一底座三阶段训练的引用指标变化,以及与 Asta ScholarQA、DR-Tulu 的横比与胜率。
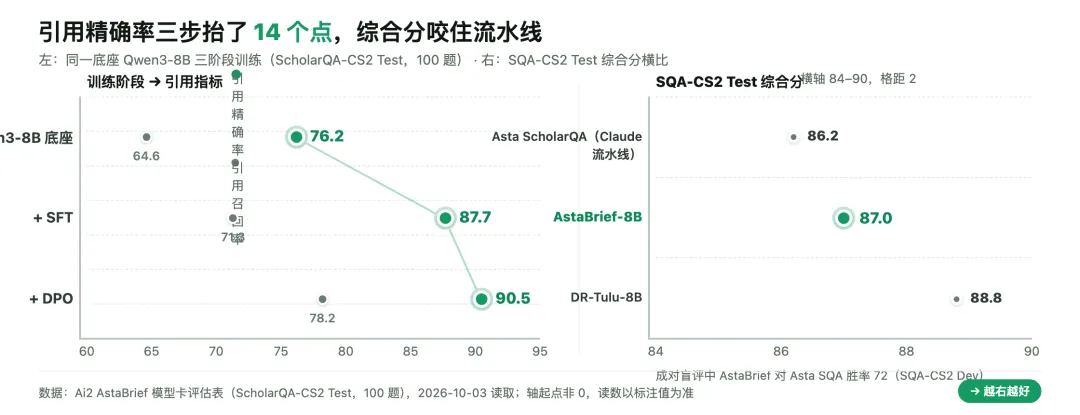
▲ 引用精确率与召回率随三阶段训练的变化(ScholarQA-CS2 Test,100 题);右图为综合分横比:AstaBrief 87.0、Asta ScholarQA 86.2、DR-Tulu-8B 88.8。
和现有三条路比
如果你现在是通用开源模型加 RAG,差异在归因成了训练目标:模型不是被要求引用,而是学过每句话该挂什么引用。如果你用大模型 API 流水线,它把逐节生成换成一次成文,砍掉了摘录摘要和聚类阶段;代价是难题上的上限可能不如多步系统——在更难的 DeepScholarBench 上它反而落后,53.50 对流水线的 60.25。和同门 DR-Tulu 比,它避开了不稳定的强化学习训练,配方更好复现。
现在怎么看它
用得上的场景很具体:在英文计算机科学文献上批量出初稿报告、且不能把问题发到外部 API 的团队。Apache-2.0 允许塞进防火墙内部署,官方还给了从自有 PDF 生成报告的示例工作流。先别急着上的场景:中文文献、非 CS 领域,或者要求引用之外还保住论断强度——Ai2 自己说明,训练和评估大多在 2025 年完成,这些数字是对训练方法的检验,不是和今天前沿模型的横比;引用挂对了,模型仍可能把样本结论说成总体结论。
今天就能做的一步:按模型卡推荐的 SFT 提示词格式跑一份自己方向的报告,重点看每条引用是否真的支持它附着的句子,而不是看文采。
参考:Ai2 AstaBrief 博客(allenai.org/blog/astabrief,2026-10-02);Hugging Face 模型卡 allenai/AstaBrief_8B(2026-10-03 读取)

发表评论
发表评论: