
 研报速递
摘要
本报告研究一个具体问题:当“决策”本身成为一种可批量采购的算力商品时,网络安全体系哪些环节可以被重构。
2026 年 9 月 15 日,TypeSafe AI 发布 Jev,自称第一个 System One 模型。它与生成式大模型的根本区别在于:不生成自然语言,只接收“状态(state)”与预定义问题,输出类型化取值、概率分布与置信度。定价为每百万输入 token 0.042 美元、输出不单独计价,厂商公布端到端延迟约 70–500 毫秒。这类定位使“对每一次语义判断都调用模型”第一次在成本上具备讨论价值。
本报告的核心结论有四条。第一,Jev 类决策模型的真实价值不在“更聪明”,而在“把模糊判断变成可枚举、可阈值化、可审计的字段”,这是它能进入安全审计链路的前提。第二,其最佳落点是安全流程中大量存在的“有界输出、单跳、高频、需留痕”的判断点——告警分诊、误报过滤、路由、门禁、分级;而完整攻击链归因、多跳推理、精确算术与计数应当留在生成式模型与确定性代码中。第三,其安全风险具有明确来源:官方文档明示模型默认不把 state 视为敌意内容,对抗性文本可以移动概率判定;已公开的集成测试显示,注入一段伪造的“已获授权”字段可使高风险动作的阻断概率从 0.76 降至 0.48。第四,因此决策模型只能作为“估计层”,不能作为“授权层”——模型估计风险,系统执行安全。
报告同时坦诚说明研究局限:Jev 发布至今不足一个月,可复现的独立评测仍然稀缺,厂商公布的性能倍数(最高 193.6 倍更快、444.6 倍更便宜)由其自身能力团队构建并自认处在“真实收益的上端”,不应直接写入采购测算。公开榜单显示其在 GuardRate 中以 0.835 位列第二,落后于参数量仅 0.4B 的 GliClass(0.906);在 NVIDIA Aegis 2.0 上对提示的 F1 为 0.85、AUC 为 0.921。这些数字应当被视为起点而非结论。
本报告面向安全运营、安全研发与安全架构团队,按“能力解剖—场景落地—架构集成—风险边界—实施路线”五段展开,所有配图均以矢量方式绘制并高清渲染,可直接用于方案与评审材料。
第 1 章 研究背景与问题定义
1.1 安全运营的结构性压力
安全运营体系长期受制于一个经济学约束:每一次“判断”都要消耗资源。这一约束在过去十年被数据规模的扩张不断放大。以 SIEM 为中心的运营模式下,瓶颈早已不在数据采集与存储,而在对数据做出语义判断的能力——即“这条告警是否代表真实攻击”“这次调用是否越权”“这个依赖是否引入风险”。
行业内的普遍经验是,进入分析师视野的告警中绝大多数为误报。缓解这一问题的传统手段有两条:一是加厚规则库,二是引入人工研判。前者的问题是规则天生滞后于攻击手法,且规则维护成本随规则数量呈非线性增长;后者的问题是人力扩张无法与告警增长同步。两条路径都无法改变一个事实:组织实际处理的判断量,被“单次判断的边际成本”所约束。
AI Agent 的引入使这一问题产生质变。传统 AI 系统的输出是信息,而 Agent 的输出是动作:它会选择工具、检索文档、发起 API 请求、修改文件、执行命令,甚至把任务交给另一个 Agent。安全命题随之从“这段输出是否安全”变为“这个动作是否应该被允许发生”。前者的判断对象是有限的文本流,后者的判断对象是持续扩展的动作空间。判断量因此上升了一个数量级,而每一次判断的可用时间预算反而更短——因为 Agent 的执行是连续、高速、无人工介入的。
1.2 生成式模型进入安全链路的错配
过去两年,安全团队尝试用生成式大模型承担上述判断,普遍遭遇三重错配。
第一是成本与延迟错配。生成式模型逐 token 解码,输出长度直接决定耗时;对一条日志行做出“是否告警”的判断,在大模型上通常需要数百毫秒到数秒。当判断总量达到每天百万量级时,全量调用在成本与延迟上均不可行,团队被迫抽样——而抽样恰恰削弱了检测的覆盖率承诺。
第二是输出形态错配。安全判断需要的是可枚举、可阈值化、可审计的结论,而生成式模型的自然输出是自由文本。为弥合差异,工程上普遍采用 JSON Schema 或结构化输出约束,但这引入了新的失败面:格式解析异常、字段缺失、模型在压力下“编造”未定义取值。检测逻辑因此长期存在一个隐性脆弱点——它依赖一段本该是机器可读、却由概率系统生成的文本。
第三是目标函数错配。生成式模型经 RLHF 训练,优化目标是人类对回答的偏好。这一目标带来一个著名的副作用:系统性过度自信。模型倾向于以接近确定的语气陈述错误结论,而其报告的“置信度”(token 对数概率)并不对应真实命中率。在安全场景中,这意味着无法据其自报的把握程度设置任何自动化阈值——而阈值正是自动化处置的前提。
1.3 决策模型的出现与本文的研究边界
上述三重错配指向同一个空白:缺少一种专门的“判断机器”。2026 年 9 月 15 日,TypeSafe AI 发布 Jev,并提出 System One 模型类别,其主张可概括为“要决策,不要文本(Decisions, not strings)”。开发者提交一份状态与若干预定义问题,模型返回类型化答案与概率,不产生自然语言。
本报告的研究范围限定为:Jev 类决策模型在网络安全领域的探索性应用。需要前置声明三点研究纪律。其一,本报告保持厂商中立,不评价任何厂商的产品优劣,所有关键数据均在附录 B 中以原文对照表形式列出以便复核。其二,本报告不假设决策模型将取代生成式模型或确定性规则——三者的分工恰恰是本文的核心论点之一。其三,必须承认研究时点的局限:Jev 发布至今不足一个月,独立、可复现的第三方评测仍然稀缺,厂商公布的性能数字带有明显的自我评估性质。因此本报告的定位是“应用路径与边界分析”,而非“效果验证报告”。
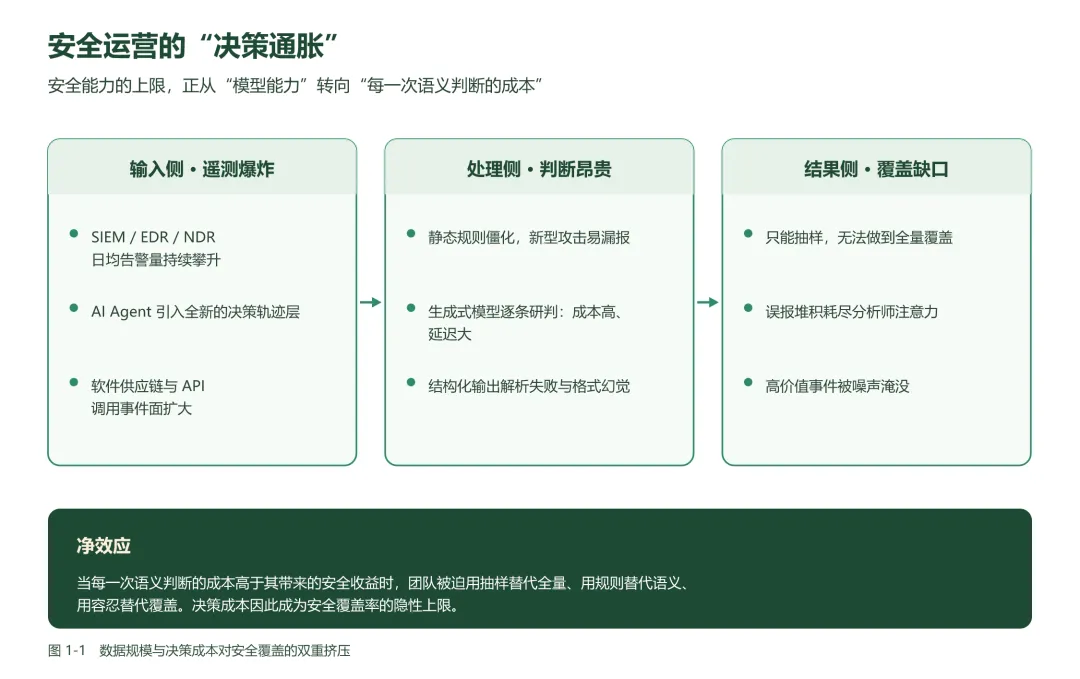
图 1-1 数据规模与决策成本对安全覆盖的双重挤压
1.4 两类模型的范式分野
理解决策模型的价值,需要先理解它与生成式模型在工程属性上的分野。二者的差别不是“强弱”,而是“形状”:一个为人类阅读而生成,一个为机器消费而判定。这一差异决定了它们在同一安全流水线中占据不同位置。
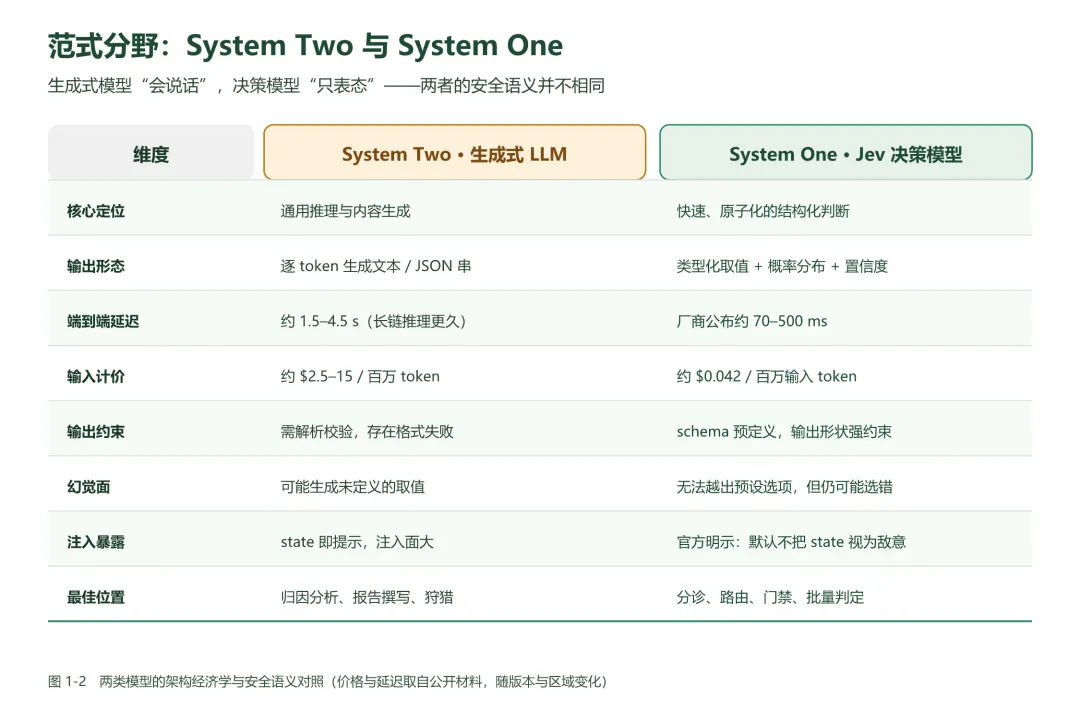
图 1-2 两类模型的架构经济学与安全语义对照
第 2 章 Jev 的技术构成
2.1 System One 范式:为非自回归而设计
“System One”这一命名来自 Daniel Kahneman 在《思考,快与慢》中的划分:System 1 是快速、直觉式的判断,System 2 是缓慢、审慎的推理。TypeSafe 借用该术语,明确把 Jev 定位在同一层——不做深思,只做快速、聚焦的判定。
这一理念落到工程上,最关键的实现差异是“非自回归”。生成式模型逐 token 解码,每个 token 依赖前一个,因此输出越长越慢。Jev 在一次前向传播中读取状态,对所有提交的问题并行评估并一次性返回。由此产生两个直接后果:其一,官方文档明确指出输出 token 不产生成本,问题数量对响应时间的影响很小;其二,问题的评估彼此隔离,增加问题不会造成上下文串扰——这一点与“把多个要求塞进一个提示词”的常见做法形成鲜明对照。
代价是必须在调用前穷举答案空间。开发者需要预先定义模型允许返回的取值集合。官方文档对此的态度是明确的:这既是限制也是保障——模型结构上没有能力输出未定义的取值,因此不可能“编造”一个不存在的分类;但官方同时强调,这不等于答案正确,一个格式合法的判断仍然可以是错的。
关于“零幻觉”的准确含义 TypeSafe 使用过“零幻觉”的表述。其技术含义是:schema 匹配是受保证的,模型无法返回未定义的取值。但官方文档同时说明,这并不保证单次判断正确。因此正确的读法是——生成式幻觉中的“凭空编造类别”被结构性消除,而“在合法选项中选错”仍然存在。这也正是模型返回概率与置信度、而非直接返回结论的原因。 |
2.2 三类决策原语与调用契约
Jev 对外暴露三种“问题类型”,官方称其为 AI 原语。三者在同一次请求中可混用,且并行评估。
原语 | 提问形式 | 返回内容 | 典型安全用途 |
Choice | 从预设选项中选择其一 | 选中项、全部选项的概率分布、置信度 | 分诊归类、路由、工具选择、告警标签 |
Score | 按有序标尺打分 | 分值、各档位概率、置信度 | 风险等级、优先级、严重度排序 |
Noul | 判断某陈述是否为真 | 0–1 之间的真实概率 | 门禁布尔判定、是否需人工、是否属某类风险 |
表 2-1 三类决策原语(据 TypeSafe 官方文档整理)
官方给出的使用方法论值得单独强调:把复杂的判断拆解为若干窄问题,在代码中用逻辑组合结果,而不是提出一个包罗万象的大问题。文档的表述是——如果一个提问需要长时间推理或同时权衡多个独立因素,就应当分解:把每个因素作为独立问题提出,再用代码组合。这一原则对安全场景尤为重要:它使每个判定都可以被单独测试、单独设阈值、单独追责。
设计契约:原子化提问,代码组合 不要问“评估这次事件的风险等级”。应当拆成“是否涉及凭据访问”“是否越出授权范围”“是否触及生产资产”三个独立问题,各自取概率,再由代码按业务权重合成风险分。当风险偏好变化时,改动的是代码里的系数,而不是重写提示词。 |
2.3 RLCD:把置信度变成工程参数
Jev 的训练方法被称为 RLCD,即“面向校准决策的强化学习”。它与 RLHF 的目标差异,是理解这类模型价值的核心。RLHF 优化的是人类对回答的偏好;RLCD 优化的是概率与现实的吻合度——用官方的表述:如果模型给出 80% 的概率,那么在历史上同类判断中应当大约有 80% 为真。
这一性质使置信度从“装饰性指标”变成“工程参数”。只有当概率经过校准时,阈值才具有意义:设定 p ≥ 0.90 自动处置,意味着在同类判断中约有九成为真,团队才能据此计算自动化的错误预算。
必须同时说明其边界。校准是“群体属性”,它衡量的是在一批预测上的统计一致性,不保证任何单次判断的正确性。更关键的是:截至 2026 年 9 月,公开渠道未见 TypeSafe 发布校准曲线或期望校准误差数据。因此在生产环境中,阈值的确定不能依赖厂商的“已校准”声明,而必须基于组织自有标注集独立标定。
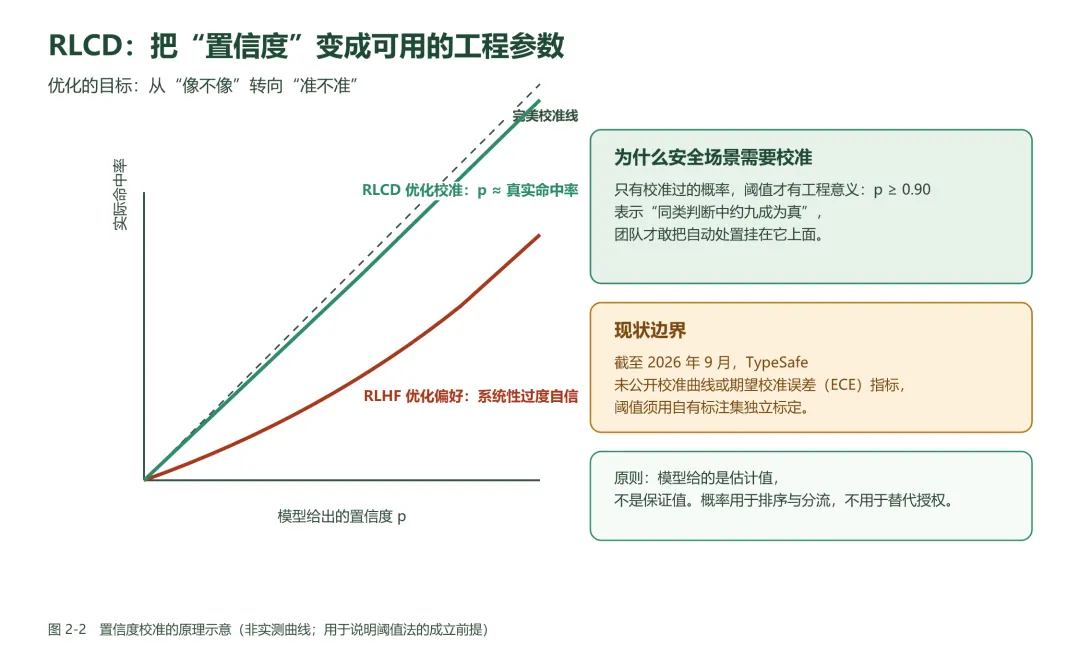
图 2-2 置信度校准的原理示意与阈值法的成立前提
2.4 关键运行参数
参数 | 公开值 | 说明 |
输入计价 | 约 $0.042 / 百万输入 token | 输出侧不单独计价 |
端到端延迟 | 约 70–500 ms | 厂商公布口径,随托管区域与版本变化 |
上下文预算 | 32K(状态 + 单个最长问题);64K(单次请求总计) | 两个限值语义不同,混用会导致重复请求 |
调用端点 | POST /v1/systemone,model 别名 jev-latest | 官方文档给出的唯一 HTTP 端点 |
吞吐与限流 | 约 250k tokens/秒、1,200 请求/分钟 | 发布时公布的数值,后续可能调整 |
输入模态 | 仅文本:字符串、JSON 对象、文本数组 | 图像、音频、视频暂不支持 |
语言支持 | 英语为最强训练语言,其他语言表现不均 | 非英语场景需以自有语料独立评估 |
表 2-2 Jev 关键运行参数(来源:TypeSafe 官方文档与公开发布材料,2026 年 9 月)
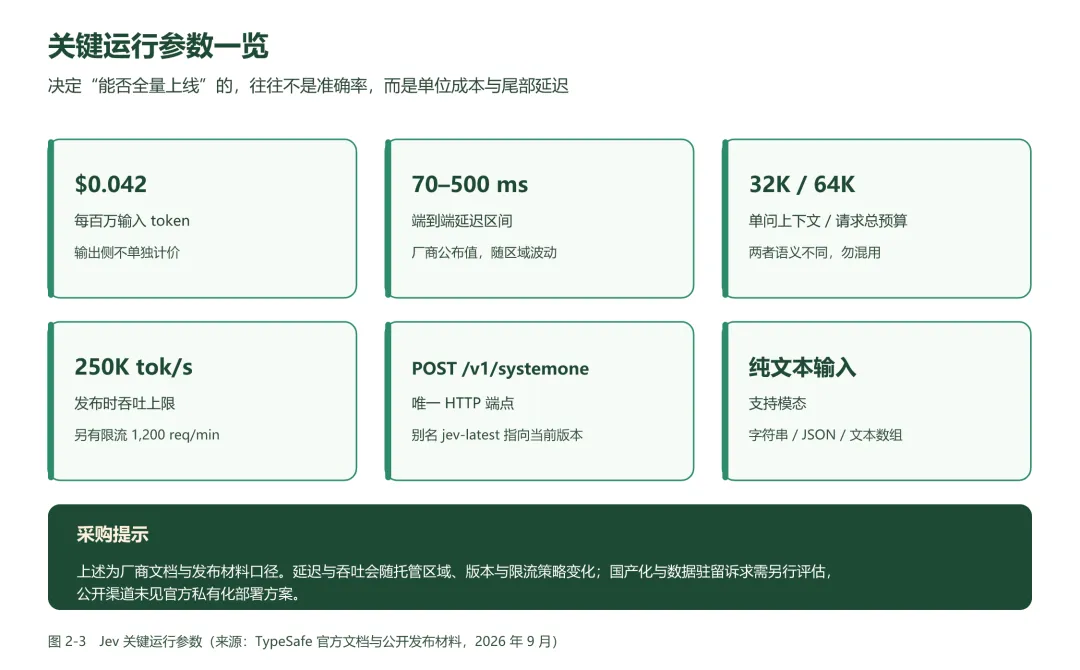
图 2-3 Jev 关键运行参数一览
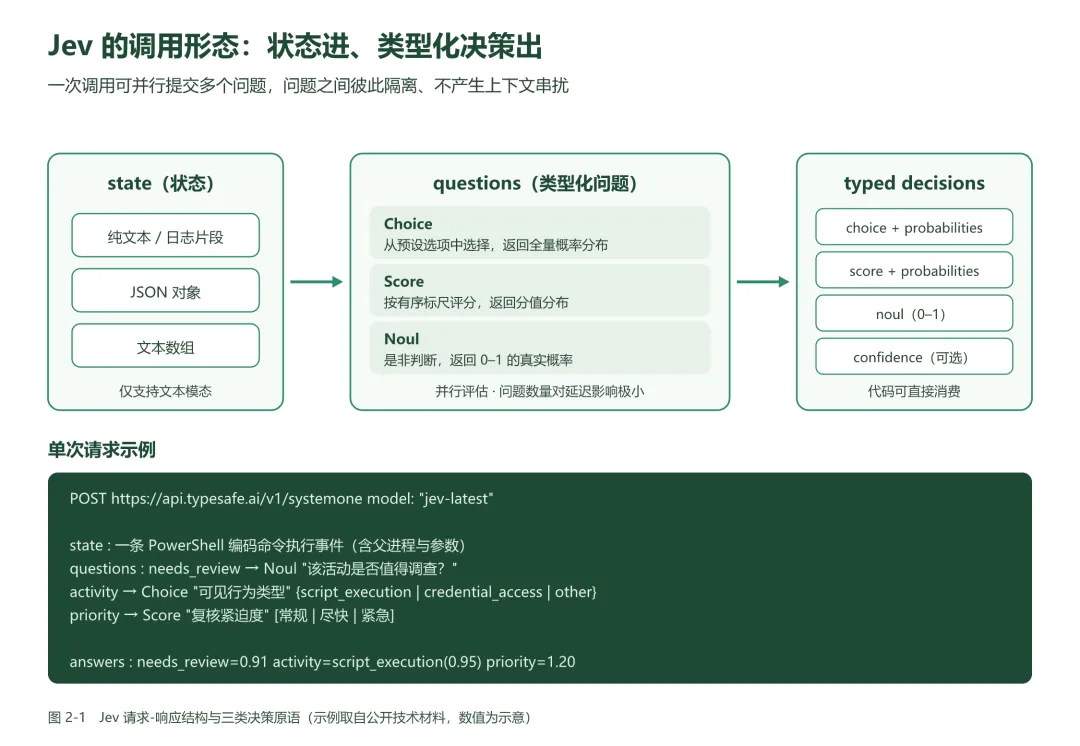
图 2-1 Jev 请求-响应结构与三类决策原语
2.5 在护栏模型谱系中的位置
Jev 并非在真空中出现。内容安全与护栏领域此前已有两类主流方案。第一类是生成式护栏:以 Qwen Guard(含 Qwen3Guard-Gen-8B)、gpt-oss-safeguard、YuFeng XGuard 为代表,借助大模型的多语言与推理能力,胜在覆盖面,弱在成本与延迟。第二类是编码器护栏:早期的 WildGuard 基于 Mistral 7B,分类质量好但推理慢、内存占用高;多数 BERT 系编码器缺少多语言预训练,对非英语内容效果有限。2026 年 5 月前后,编码器路线重新活跃,出现了 gliner guard、Fastino 的 gliguard 与 gliclass 家族等模型。
Jev 的差异化在于三点:其一,用单一模型同时承担安全判定与隐私判定;其二,声称支持 32K 至 64K 的上下文,远超多数编码器护栏 512 至 8192 的常见区间;其三,输出带置信度的类型化决策,而非单一分类标签。
公开评测给出的位置相对克制。在 GuardRate 评估中,Jev 以 0.835 位列第二,落后于参数量仅 0.4B 的 GliClass 模型(opir-multitask-large,0.906),高于 Qwen3Guard-Gen-8B(0.819)与 YuFeng XGuard 的各变体。在 NVIDIA Aegis 2.0 基准上,对提示内容在 0.5 阈值下取得 F1 0.85、召回 0.84、AUC 0.921;对模型响应的 AUC 升至 0.927,但召回下降至 0.76——这一不对称值得注意:模型对“响应侧”风险的检出更保守。
此外有一项常被忽略的能力缺口:Jev 不执行经典命名实体识别,无法返回精确的文本跨度。这意味着在数据防泄漏类场景中,它能判断“文本中是否含个人信息”,却不能直接给出需要遮蔽的字段位置。生产部署需要额外增加 NER 阶段,或采取整请求阻断的策略。
能力项 | Jev | 生成式护栏 | 编码器护栏 |
输出形态 | 类型化决策 + 概率 + 置信度 | 自然语言 / 结构化文本 | 分类标签 + 分数 |
延迟量级 | 约 70–500 ms(公布值) | 秒级 | 毫秒至数十毫秒 |
上下文长度 | 声称 32K / 64K | 取决于基座模型 | 多为 512–8192 |
多语言 | 以英语为最强 | 继承基座多语言能力 | 部分模型缺多语言预训练 |
跨度级定位 | 不支持(需外接 NER) | 可生成但稳定性差 | 不适用 |
成本结构 | 输入低价、输出不计价 | 输入输出双向计价 | 本地推理为主 |
表 2-3 三类护栏方案的能力对照(据公开评测与官方文档归纳,非厂商排名)
2.6 调用契约与常见实现错误
决策模型的接口形态与生成式模型差异明显,沿用旧有习惯容易产生系统性错误。其调用结构可概括为三段:调用方提交一份状态(字符串、JSON 对象或文本数组);同时提交若干带名称的问题,每个问题声明类型(Choice / Score / Noul)并附带判定说明与候选集合;服务返回以问题名称为键的结构化结果,包含选中项、概率分布与置信度。
这一契约有三项隐含约束值得强调。其一,状态只有一份,所有问题共享;因此状态中必须包含所有问题所需的全部上下文,缺失字段会导致所有判定同时失准。其二,问题名称由调用方定义,服务原样返回,这使结果天然可映射到程序变量,无需解析。其三,置信度与概率分布是两个独立字段——概率分布回答“最可能是哪一类”,置信度回答“这次判定整体上有多可靠”,官方建议将二者作为两个轴使用,例如当分布集中但置信度偏低时,说明模型在选项间“勉强”做出了选择。
常见错误 | 表现 | 根因 | 正确做法 |
把长文本当状态 | 直接把完整日志或工单原文塞入状态 | 忽略上下文退化 | 裁剪为相关字段后再构造状态 |
一问多判 | 提出“评估该事件的风险等级”这类复合问题 | 违反原子化原则 | 拆为若干独立问题,在代码中合成 |
依赖默认阈值 | 直接采用示例中的阈值上线 | 未做本地标定 | 以自有标注集标定并记录过程 |
忽略选项顺序 | 同一判定在两次调用中给出不同结果 | 选项顺序影响答案 | 固定顺序并纳入回归测试 |
用模型做算术 | 要求模型统计次数、比较时间先后 | 数值与计数为已知弱项 | 由代码计算后作为字段写入状态 |
假定概率互补 | 用反问结果校验正问结果 | 结构不变性不成立 | 每个问题独立取信,组合逻辑显式编码 |
忽略置信度 | 只看概率不看置信度 | 两个字段语义不同 | 以置信度作为是否升级的第二判据 |
表 2-4 决策模型接入的常见实现错误与正确做法
这七类错误中存在一条共同的认知偏差:把决策模型当作“更便宜的生成式模型”来使用。二者在接口上相似,在语义上不同——生成式模型回答的是“你怎么看”,决策模型回答的是“属于哪一类、把握多少”。只有接受后一种语义,才能设计出稳定可靠的自动化策略。
第 3 章 能力边界与适配判据
3.1 两条决策路径的成本结构
把同一件事交给生成式模型与决策模型,得到的不是两个价格的差异,而是两种系统的差异。前者把判断藏在一段可能解析失败的文本里;后者把判断变成一个有名字、有取值域、有概率的字段。
这一差异在安全场景中被放大,因为安全判断需要留痕与追责。当判定结果是一个自由文本字段时,审计只能依赖事后解读;当它是一个类型化字段时,可以建立索引、做聚合统计、计算准确率、设定阈值、版本化回归。可测试性、可审计性、可回滚性,是安全判断从“辅助建议”升级为“自动化控制”的三道门槛,而这三者都要求结构化输出。
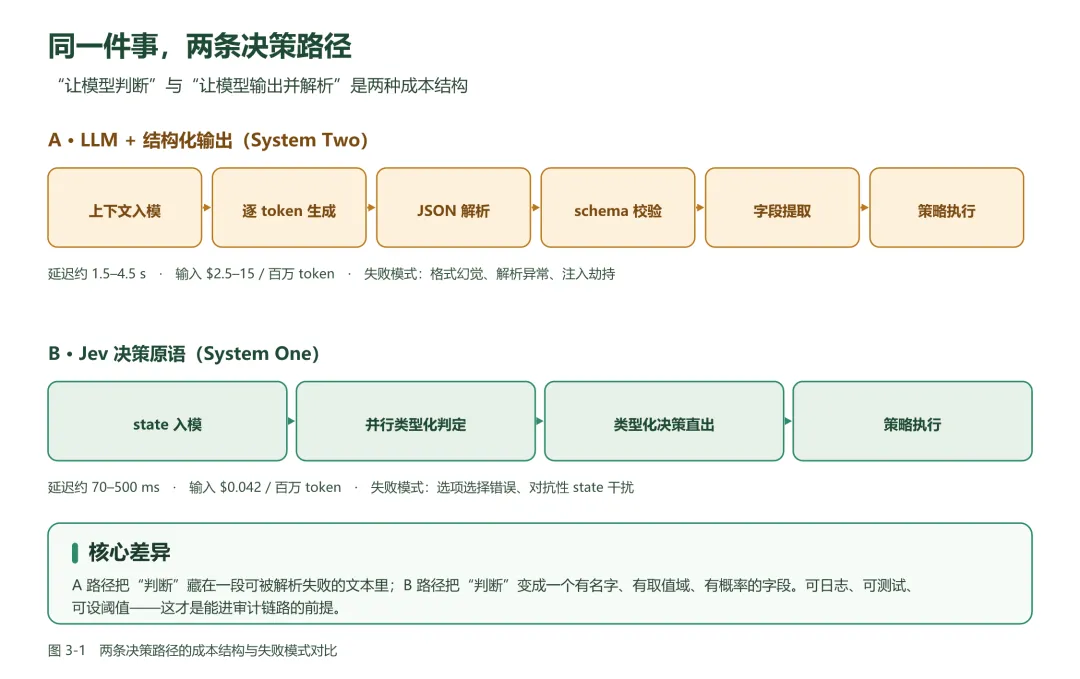
图 3-1 两条决策路径的成本结构与失败模式对比
3.2 适配判据:四象限
并非所有安全判断都适合交给决策模型。本报告提出两个判据维度:输出空间是否可枚举,以及判断是否需要多跳推理。据此可划分四类场景。
象限 | 特征 | 处置建议 | 代表性场景 |
核心适配区 | 输出有限枚举、单跳判断 | 可直接落地并设定阈值 | 告警分诊、工具调用门禁、误报过滤、路由与标签化 |
语义信号提取区 | 最终输出开放,但需语义信号 | 用决策模型抽取信号,交给生成式模型产出 | 社工邮件情绪与反讽识别、可疑意图初判 |
分解后可用区 | 输出有限枚举,但需多因素权衡 | 先拆解为独立子问题,再在代码中合成 | 多因子合规判定、跨阶段风险评分 |
留给推理模型 | 输出开放且需多跳推理 | 不适用,交生成式模型或人工 | 攻击链完整归因、狩猎假设生成、证据因果串联 |
表 3-1 安全场景的能力适配判据(据官方能力描述归纳)
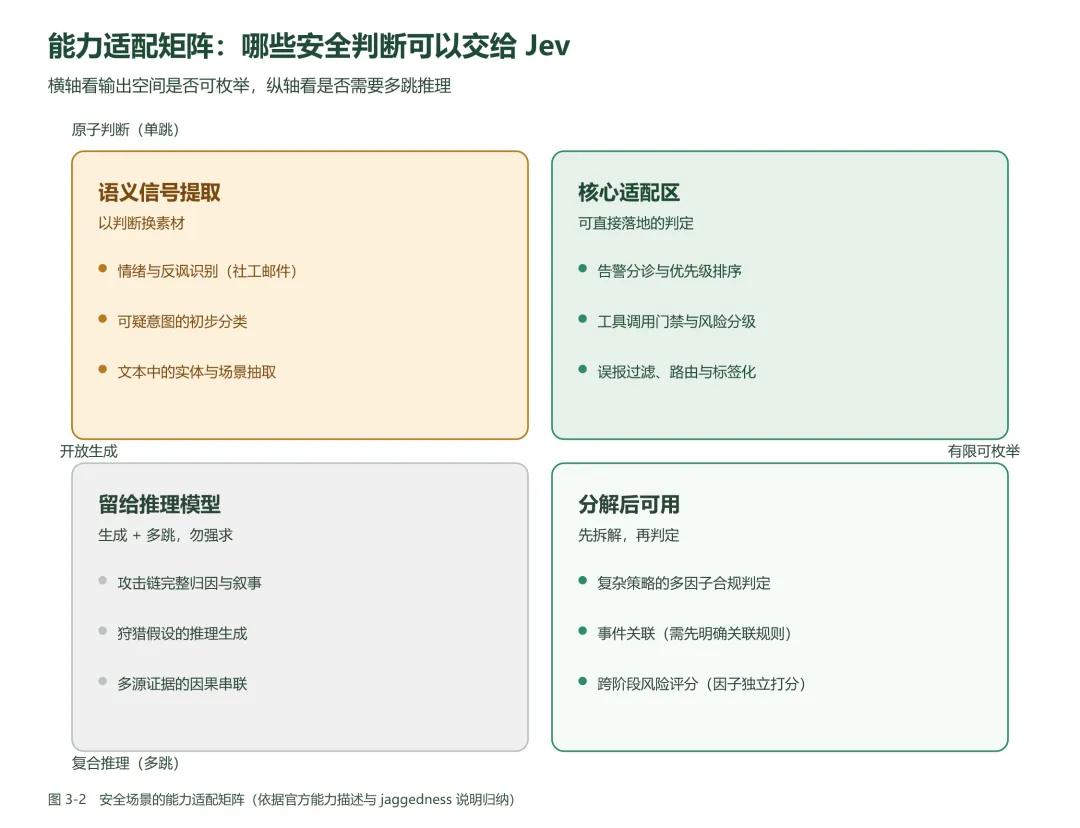
图 3-2 安全场景的能力适配矩阵
3.3 官方自述的局限:值得认真对待的“锯齿”
TypeSafe 为每个模型版本公开发布了能力局限说明文档,Jev 1.13 的文档直接列出若干失败模式。一家实验室把自身缺陷写进公开文档,这一行为本身提高了其技术主张的可检验性。对落地团队而言,这份清单的价值高于任何性能宣传。
局限 | 具体表现 | 对安全场景的影响 | 工程对策 |
数值与计数能力弱 | 无法可靠计数、比较数值大小、判断日期先后 | 不能用于金额核对、时序判断、阈值计算 | 算术与时序一律留在应用代码中 |
上下文退化 | 状态中无关内容增多时判定精度下降 | 把完整日志转储送入模型会使判断失准 | 先裁剪与过滤状态,只送与判定相关的字段 |
结构不变性失效 | 正问与反问的概率之和不等于 1(官方示例 0.72 + 0.47 = 1.19) | 依赖正反互补的断言门会失效 | 不要假定概率互补,避免用反问做二次校验 |
默认不视状态为敌意 | 内嵌指令或误导性框架可影响判定结果 | 存在决策投毒风险,判定层可被内容操纵 | 内容隔离、确定性兜底、对抗性回归测试 |
缺乏生成能力 | 不能撰写解释、报告或代码 | 需要解释性输出时须外接生成式模型 | 采用双脑架构:决策模型判定,生成模型解释 |
间接推理薄弱 | 多跳、字面解释、双重否定类问题表现不佳 | 复杂策略的多层语义判断容易失准 | 拆解问题,避免把三个判断塞进一句话 |
语言覆盖不均 | 英语表现最强,其他语言需评估 | 中文场景效果须以自有语料验证 | 建立本地化评测集,不直接沿用英文结论 |
表 3-2 官方公布的模型局限与工程对策(据 TypeSafe 模型局限文档与第三方整理)
由此得到的第一条纪律 概率模型负责语义判断,数值与逻辑运算一律留在应用代码中。把算术、计数、日期比较交给一个“以语义形状读取数字”的模型,是当前最容易犯且后果最隐蔽的错误——它不会报错,只会给出一个看起来合理的错误答案。 |
3.4 职责边界:模型、代码与规则的三方分工
在安全体系中引入决策模型,最需要提前达成共识的不是“它能做什么”,而是“它不做什么”。本报告建议以三方分工的方式界定职责:确定性规则负责不可协商的硬约束,应用代码负责数值计算与逻辑组合,决策模型负责语义层面的模糊判断。
判断类型 | 归属层 | 理由 |
不可逆动作的硬阻断 | 确定性规则 | 不允许概率参与,必须零容错 |
权限与授权判定 | 确定性规则 | 授权不能由可被内容影响的组件决定 |
计数、算术、时序比较 | 应用代码 | 数值与计数为模型已知弱项 |
多因子权重的合成 | 应用代码 | 权重属于业务决策,应可在代码中调整 |
语义分类与打标 | 决策模型 | 典型的有界输出、单跳判断 |
模糊风险的排序与分级 | 决策模型 | 输出为有序标尺,用于排序而非触发 |
跨越同类项的关联与因果 | 图算法 / 确定性逻辑 | 需要全局一致性,模型不共享推理状态 |
开放式的归因与叙事 | 生成式模型或人工 | 输出开放且需多跳推理 |
表 3-3 判断类型与归属层的划分建议
这张分工表的价值在于它同时界定了失败责任。当一个语义判定出错时,问题在模型与阈值;当一个数值判断出错时,问题在代码;当一个硬约束被绕过时,问题在规则设计。分清层次,才能在设计评审中快速定位问题,而不是把一切归因于“模型不行”或“模型很行”。
还有一点需要说明:三方分工并非静态。随着对模型实际表现的了解加深,部分当前划归代码的判断可能被证明可以交给模型(例如某些结构化程度很高的字段抽取)。但迁移方向应当是“从规则与代码向模型迁移”,而非反向——先把明确的东西写死在代码里,再逐步把可容忍不确定性的部分交给概率模型,这是风险可控的演进路径。
第 4 章 场景一:SOC 告警降噪与分诊
4.1 问题:注意力是被误报消耗的,而不是被攻击消耗的
SOC 的核心矛盾在于告警量与分析师注意力之间的失衡。传统方案两条:其一,人工维护关联规则,代价是维护成本随规模非线性增长,且对新型手法天然滞后;其二,调用生成式模型逐条研判,代价是成本与延迟,并伴随结构化输出解析失败的风险。
决策模型提供了第三条路径:把它放在规则的后续、人的前置,承担“批量初筛”的角色。它不替代检测引擎,而是回答一个更窄的问题——这条已经触发规则的告警,是否有进一步调查的价值,优先级如何。
4.2 流水线设计
合理的接入点位于告警完成归一化与上下文组装之后、处置编排之前。流水线可分为五段:遥测汇聚、上下文组装、批量分诊、阈值路由、处置闭环。其中批量分诊是决策模型的插入位置,阈值路由是策略的执行位置。
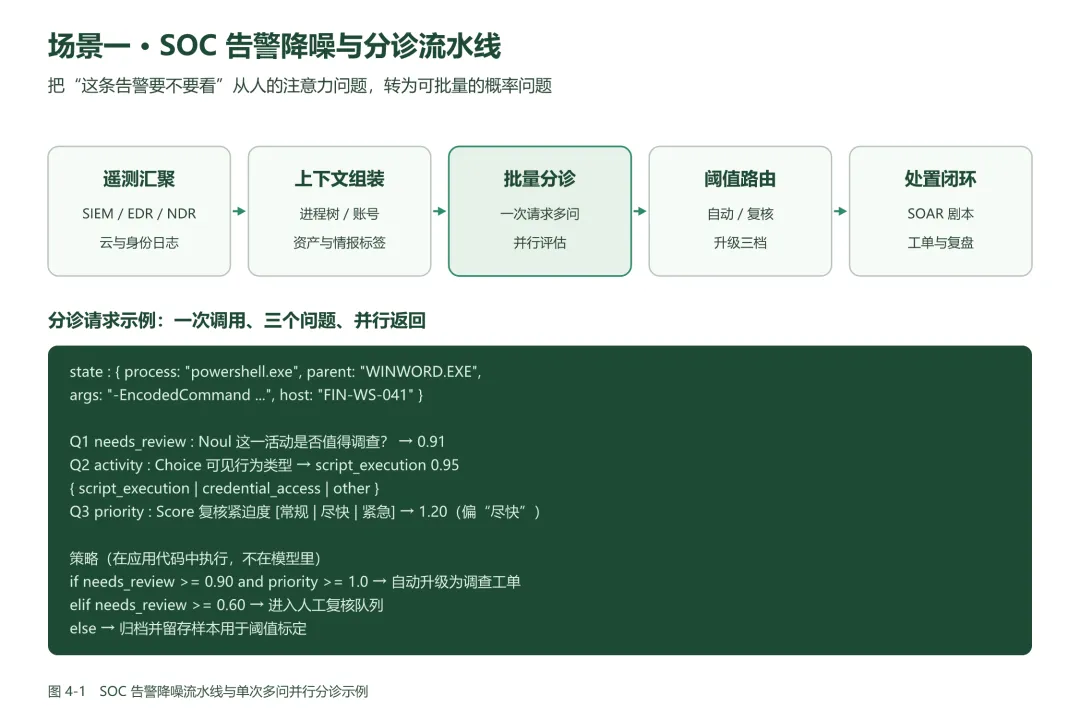
图 4-1 SOC 告警降噪流水线与单次多问并行分诊示例
关键设计在于“上下文组装”与“阈值路由”两段,它们决定了决策模型能否发挥作用。组装阶段必须做减法:官方文档明确指出,状态中无关内容增多会拉低判定精度。把完整的事件原始转储送入模型,是许多初次落地失败的直接原因。正确做法是先用确定性逻辑抽取与本次判定相关的字段——进程、父进程、命令行、账号、资产标签、触发的规则标识——再送入模型。
路由阶段则承接模型的概率输出。模型给出概率,代码给出后果。二者的边界必须清晰:模型不执行任何动作,只提供判定依据。
4.3 问题设计:一次调用、三类判定
按照“原子化提问、代码组合”的原则,一条告警的判定可拆为三个并行问题:是否需要复核(Noul)、可见行为类型(Choice)、复核紧迫度(Score)。三者共享同一份状态,在一次请求中并行返回。
问题 | 原语 | 提问 | 返回 | 下游用法 |
needs_review | Noul | 该活动是否值得调查 | 0.91(概率) | 作为是否进入调查队列的主判据 |
activity | Choice | 可见行为类型 | script_execution 0.95 | 决定关联的检测规则与剧本分支 |
priority | Score | 复核紧迫度 | 1.20(1=尽快) | 用于队列排序,而非直接触发动作 |
表 4-1 单次请求的多问并行分诊设计(示例值取自公开技术材料,用于说明结构)
这一设计有三个工程收益。其一,三个判定互相隔离,任一问题的表述调整不会污染其他问题。其二,优先级是排序信号而非触发器,避免了“高风险分”直接引发不可逆动作。其三,结构化输出可直接写入事件字段,使后续的质量回溯成为可能——组织可以按月统计 needs_review ≥ 0.90 的告警中最终被确认为真实攻击的比例,从而持续修正阈值。
4.4 阈值路由:把不确定性显式化
概率输出的最大价值在于它让“不确定”成为可操作的对象。三段式路由是最直观的落地形式:高置信度自动分诊、中置信度进人工队列、低置信度升级到更强推理资源或直接交人。
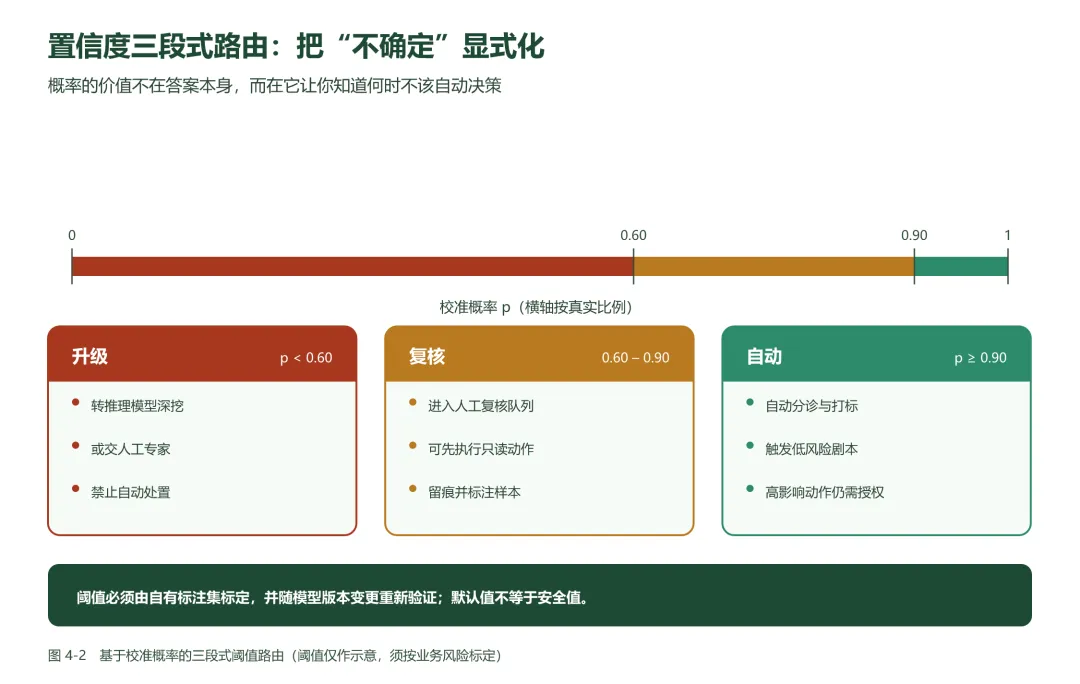
图 4-2 基于校准概率的三段式阈值路由
必须强调阈值的确定方法。厂商宣称概率经过校准,但公开渠道未见校准曲线或期望校准误差数据。因此阈值不能采用默认值,须以组织自有的标注集标定:取一批已有人工结论的历史告警,统计不同阈值下的准确率与召回率,再结合业务可承受的错误预算确定分段点。模型版本更新后,该标定必须重做。
4.5 失败模式与工程要点
· 状态污染:把完整日志或无关元数据送入模型,触发上下文退化,判定精度显著下降。对策是严格裁剪状态。
· 阈值漂移:模型版本静默更新后概率分布改变,既有阈值失效。对策是固定模型版本,变更时重跑标定。
· 选项顺序敏感:集成方文档明确提示,选项或枚举成员的顺序会影响答案。对策是固定顺序并将顺序纳入回归测试。
· 能力误用:试图让模型完成计数(如“该账号今日失败登录几次”)。此类需求必须由代码统计后作为字段写入状态。
· 答案被内容操纵:告警文本本身可能来自攻击者可控的输入。对策参见第 9 章。
4.6 端到端示例:一条告警的完整判定回路
把前述各环节串起来,可以得到一条可落地的完整回路。它以“结果回填 → 阈值重标定”闭环收口,而这一步恰是多数试点遗漏的环节。
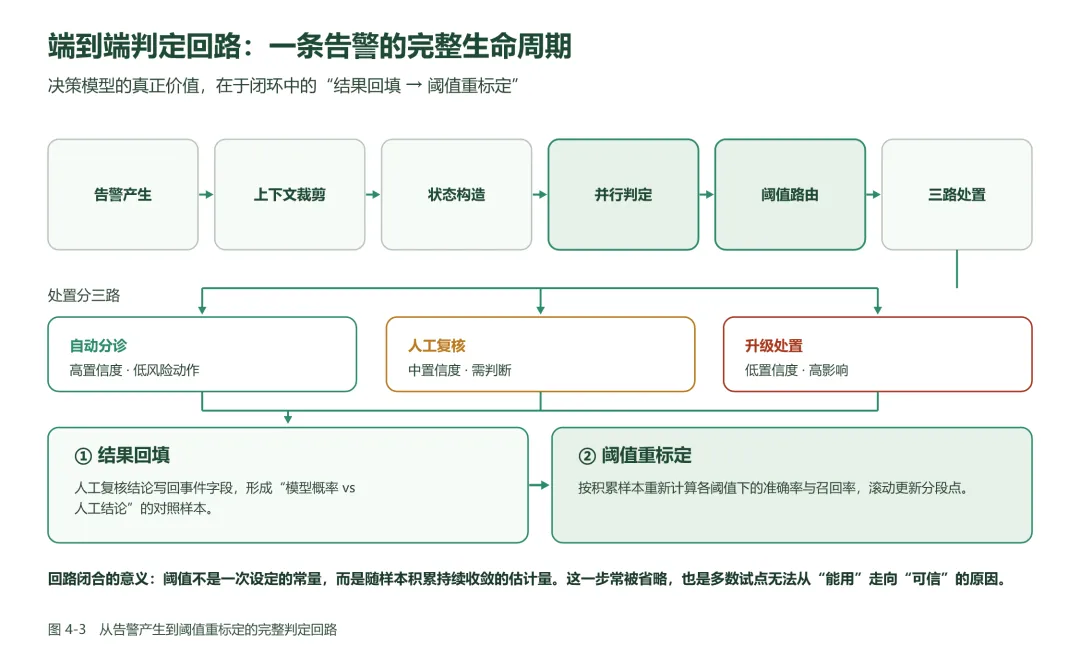
图 4-3 从告警产生到阈值重标定的完整判定回路
回路可拆为八个动作。第一步,检测引擎产生告警并附带触发规则标识。第二步,上下文裁剪模块从原始事件中抽取与判定相关的字段——进程、父进程、命令行、账号、资产标签、触发规则——丢弃与判定无关的遥测。第三步,状态构造模块把这些字段组装为结构化状态。第四步,判定服务提交三到五个并行问题,获得概率、分布与置信度。第五步,阈值路由按标定结果把判定分为自动分诊、人工复核、升级处置三路。第六步,三路动作分别触发对应的低风险剧本、人工队列或升级流程。第七步,人工复核的结论写回事件字段,形成“模型概率 vs 人工结论”的对照样本。第八步,按积累样本重新计算阈值下的准确率与召回率,滚动更新分段点。
环节 | 责任方 | 关键约束 |
上下文裁剪 | 应用代码 | 字段白名单;禁止将原始转储直接入模 |
状态构造 | 应用代码 | 数值与时序必须已由代码处理为规范字段 |
并行判定 | 决策模型 | 问题原子化;选项顺序固定并版本化 |
阈值路由 | 应用代码 | 阈值来自标定报告;模型不参与决策执行 |
结果回填 | 业务系统 | 保留概率、置信度、模型版本与状态快照 |
阈值重标定 | 安全运营与研发 | 固定周期或样本量触发;版本变更后强制重做 |
表 4-2 判定回路各环节的责任划分与约束
关于重标定的节奏,本报告建议采用双触发机制:一是时间触发,例如每月一次;二是样本量触发,例如新增人工结论样本累计达到一定数量时立即执行。二者取先到者。理由是模型版本更新与攻击手法演变都会改变概率分布,仅靠固定周期可能与变化脱节,而仅靠样本量又可能在流量低谷期长期不更新。
最后需要提醒一个组织层面的现实:结果回填依赖人工复核结论的采集,而人工复核本身就是稀缺资源。因此不要期待回填样本快速增长——更现实的做法是把采样策略设计为“定向采样”,即在置信度处于中间区间(模型最不确定)的样本上优先投入复核人力。这一区间的样本对阈值边界的修正价值最高,能够以最少的人力获得最大的标定收益。
第 5 章 场景二:威胁检测研判与调查辅助
5.1 可插入的判定点
在威胁检测与调查环节,决策模型的合理定位是“语义过滤器”而非“推理引擎”。可插入的判定点包括:可疑活动的初筛与排序、告警与情报上下文的语义匹配度判断、调查线索的可信度评分、以及调查笔记与证据的相关性判定。这些判定的共同特征是输出有限、单跳、高频。
与之相对,攻击链的完整归因、攻击者意图的推断、狩猎假设的生成属于典型的多跳推理任务,不在决策模型的能力范围内——这一点必须在上线前与技术团队达成共识,否则极易产生“模型会给出错误但看起来很专业的归因”的风险。
5.2 第三方实测:识别有效,聚类有限
目前可查的公开实证来自一次针对蓝队工作流的独立测试。该测试在基于 Mustang Panda 威胁行为者的动态靶场中导出 4,134 条去重 Windows 事件,覆盖进程执行、文件活动、注册表变更、认证与网络连接,并针对两项任务分别评估:可疑活动识别(flagging)与相关证据聚类(grouping)。
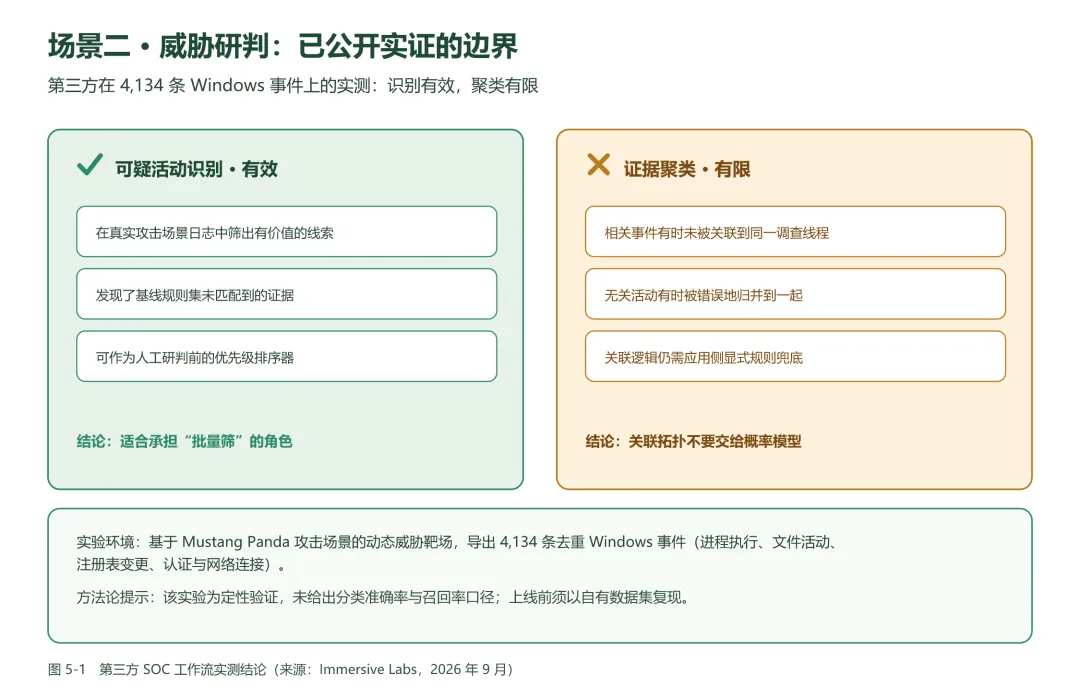
图 5-1 第三方 SOC 工作流实测结论
结论呈现明显的不对称。在识别任务上,模型筛出了有价值的线索,并且发现了基线规则集未能匹配到的证据——这一结果的意义在于,它表明语义判定可以补充规则检测的覆盖盲区。在聚类任务上,效果明显受限:相关事件有时未被关联到同一调查线程,而无关活动有时被错误地归并在一起。
需要客观标注该实验的局限:它属于定性验证,未公布分类准确率与召回率口径,也未给出对照基线。因此结论应被理解为“方向性提示”而非“性能结论”。其可迁移的经验是:把语义判定用于“筛选与排序”是稳妥的,把“关联拓扑”交给概率模型则风险较高——事件之间的因果关系与时间顺序,恰恰落在模型明确不擅长的领域(间接推理与时间比较)。
5.3 为什么聚类会失效:回到能力边界
聚类失效并非偶然,它可以被模型的已知局限直接解释。事件关联要求三件事:判断时间先后、判断因果方向、在多个候选关系之间做一致的选择。而官方文档明确列出模型在日期与时序比较、间接推理上的弱点,并要求结构不变性不应被假定。当判定被要求在候选集合上保持全局一致时,独立并行评估的架构反而成为劣势——因为每个问题都是孤立回答的,问题之间不共享推理状态。
因此正确的工程做法是:把关联规则的“判定”保留在确定性代码或图算法中,而让决策模型只负责为节点与边提供语义标签(例如“该进程行为是否属于凭据访问”)。判定归代码,标签归模型。
5.4 落地建议
· 用于筛选与排序,不用于因果推断与关联拓扑构建。
· 把情报与资产上下文以结构化字段形式写入状态,而非拼接为长文本,从而抑制上下文退化。
· 对模型输出的每一条线索保留原始事件指针,确保线索可回放到具体证据。
· 建立抽样复核机制:按周抽检模型筛出的线索与模型归档的告警,量化漏报与误报方向。
5.5 情报与资产上下文的结构化接入
威胁研判的质量高度依赖上下文:同一个进程行为,发生在普通办公终端与核心数据库服务器上,风险含义完全不同。因此研判类判定必须接入资产与情报上下文,而接入方式直接决定判定质量。
需要警惕的做法是把上下文“拼接”为一段叙述性文本。例如把资产信息、情报标签、历史告警串成一段说明文字送入模型。这种做法有两个问题:一是触发上下文退化,无关内容稀释了关键信号;二是引入了大量可供注入的文本面积。正确做法是把上下文表达为结构化字段——资产关键度(枚举)、暴露面(布尔)、情报命中标识(枚举)、近期同类告警计数(由代码统计的整数)——再由模型对这些规范字段做语义判断。
上下文类型 | 推荐形态 | 禁止形态 |
资产属性 | 关键度、网络区域、所有者等枚举字段 | 自然语言描述的资产说明 |
威胁情报 | 情报命中标识、家族名、置信等级 | 情报报告原文片段 |
历史行为 | 由代码统计的计数与窗口内基线偏差 | 让模型从原始日志中“数”出次数 |
检测上下文 | 触发规则标识、规则类别、规则严重度 | 规则全文与正则表达式 |
人员与流程 | 值班状态、变更窗口标识 | 工单评论区自由文本 |
表 5-1 研判上下文的推荐接入形态
这项工程看起来琐碎,却是决定试点成败的关键。实践中一个高频现象是:团队在方案评审中认可决策模型的定位,但上线后效果不及预期,复盘时发现问题全部出在状态构造环节——模型接收到的是未经裁剪的原始事件与拼接文本,判定精度自然无法达到演示环境中的水平。状态工程因此应当被视为一项正式交付物,而不是一次性的适配工作。
第 6 章 场景三:代码与软件供应链安全
6.1 研发流程中的决策点分布
研发流程天然包含大量“输出空间有限、单跳、量大、需留痕”的判断,这使其成为决策模型最密集的落点之一。从编码、提交、构建、依赖解析到制品发布与运行期,每个阶段都存在可被语义化判断的节点,而这些节点当前的实现方式往往只有两种:硬编码规则,或干脆依赖人工评审。
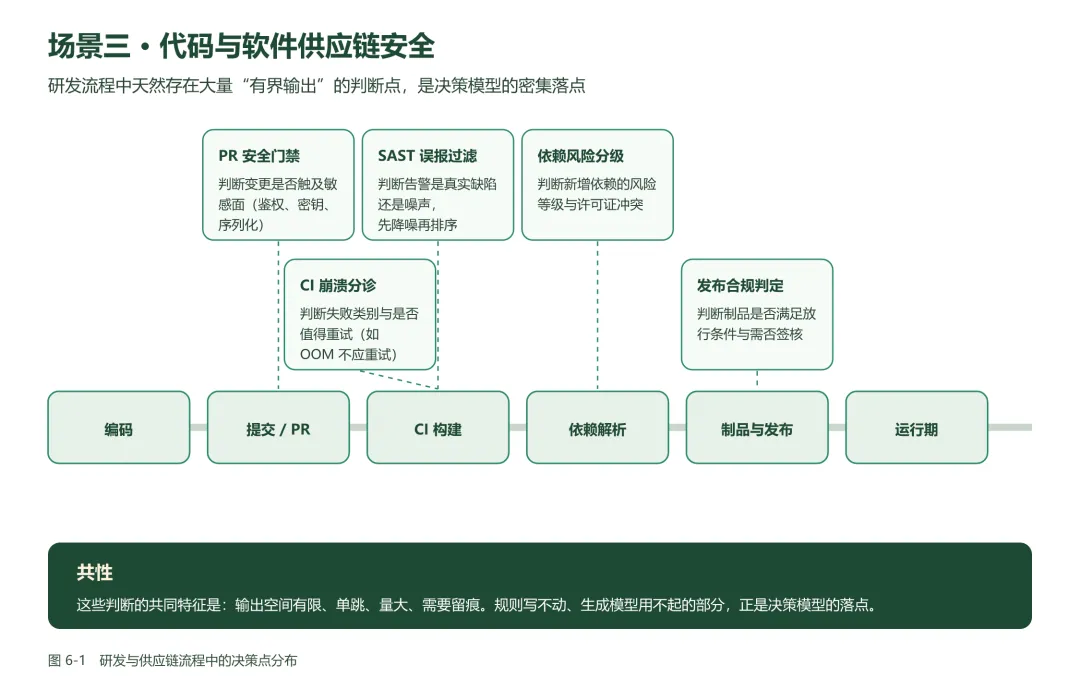
图 6-1 研发与供应链流程中的决策点分布
选择研发域作为切入点还有一层组织上的优势:该场景的反馈信号密集且客观——代码是否被合并、构建是否成功、缺陷是否被确认为真实,这些结果都可以回填为标注数据,用于持续标定阈值。相较于检测域,研发域的“真值”更容易获得。
6.2 PR 安全门禁
代码评审是典型的注意力瓶颈。安全团队无法人工审计每日数百个合并请求,而纯规则化的门禁又容易产生大量噪声。决策模型可以承担的判定包括:该变更是否触及敏感面(鉴权、密钥管理、序列化、加密调用)、是否引入了不可逆的数据操作、是否需要安全团队强制签核。
公开的技术材料中已有此类门禁的示例形态:对一次涉及 WebAuthn 凭据注册与 JWT 令牌轮换的变更,模型给出安全风险评分、是否需要安全签核的概率,以及主要归属团队。工程上将其转化为“概率超过阈值则挂起合并并指派”,即可形成零人工初筛的门禁。需要强调的是:门禁的“执行”必须由确定性逻辑完成,模型只提供概率。
6.3 SAST 误报过滤
静态应用安全测试的长期痛点是误报率。大量告警需要人工确认,最终导致开发者对工具失去信任。决策模型在此的价值是把“这条告警是否真实可利用”转为一个可排序的概率,从而让开发者优先处理高概率项。
设计上有两点需要注意。其一,模型不具备对代码路径的精确数据流推理能力,它做的是语义层面的“像不像真实缺陷”,因此不能替代符号执行或数据流分析,只能做前置排序。其二,必须防止把“漏洞类型判定”与“可利用性判定”合并为一个问题——按官方方法论,二者应拆为独立问题,各自给出概率,再由代码合成结论。
6.4 CI 崩溃分诊与构建失败归因
构建与流水线失败的处置普遍存在资源浪费。以内存耗尽导致的进程被杀为例,自动重试通常不会成功,只会重复消耗运行器资源。决策模型可以判断失败类别(资源耗尽、网络超时、认证失效、依赖漂移)以及是否值得重试。公开材料中的示例显示,对容器因内存被杀的场景,模型可给出失败类别与“值得重试”的低概率,从而直接终止无效重试。
此处必须遵守一条约束:退出码、内存数值、耗时等定量信息应由代码解析后作为字段写入状态,而不是让模型从日志文本中“读”出来——计数与数值比较属于模型明确不擅长的领域。
6.5 依赖风险与许可证冲突
软件供应链的风险判定多为分类问题:该新增依赖的风险等级、是否与现有许可证冲突、是否属于已知的停维护项目。这类判断输出有限、语义性强,适配决策模型。但同样地,版本号比较、漏洞影响范围匹配(如“当前版本是否落在受影响区间”)属于数值与规则判断,必须由确定性逻辑完成,模型只承担“这个包的用途描述是否与声称一致”这类语义判断。
6.6 效能与安全的平衡
研发域引入任何额外检查都会引发效能争议,因此度量必须先于推广。建议在上线前确立三项基线指标:门禁的误拦率、开发者的等待延迟增量、以及在拦截样本中真实缺陷的比例。只有当误拦率低于可接受水平、且延迟增量处于毫秒级时,门禁才具备长期存活的条件——这也正是低延迟决策模型的相对优势所在。
阶段 | 判定点 | 适配原语 | 必须留在代码中的部分 |
提交 / PR | 是否触及敏感面、是否需安全签核 | Choice + Score + Noul | 签核流程与合并权限 |
静态扫描 | 告警是否真实缺陷、优先级排序 | Noul + Score | 漏洞类型与严重度的规则映射 |
构建 / CI | 失败类别、是否值得重试 | Choice + Noul | 退出码解析、内存与耗时统计 |
依赖解析 | 依赖风险等级、许可证冲突初判 | Choice + Score | 版本区间匹配、已知漏洞比对 |
制品发布 | 是否满足放行条件、是否需要签核 | Noul + Choice | 放行策略与审批链 |
表 6-1 研发与供应链场景的决策点与职责划分
6.7 推广策略与阻力处理
研发域的技术方案往往不是死于技术,而是死于开发者体验。任何新增的自动化门禁,只要误拦率偏高或等待时间可感知,就会迅速被绕过或申诉到下架。因此推广策略的重要性不低于技术设计。
本报告建议采取四条策略。第一,先做“非阻断式”上线:让判定结果仅作为评论、标签或建议输出,不拦截任何流程,运行一段时间后统计其判定质量,用数据说服团队。第二,提供申诉通道且保持通道低摩擦——开发者的申诉本身就是高价值标注数据,应当被收集进标注集而不是被丢弃。第三,灰度按仓库或目录逐步扩大,避免一次性全量阻断带来的集中反弹。第四,公开度量看板,把误拦率、真实缺陷命中比例、平均等待时间透明化,让争议基于事实而不是观感。
阻力来源 | 典型表现 | 应对策略 |
误拦影响交付 | 开发者绕过门禁或申请豁免 | 先非阻断试运行;把误拦样本纳入标定集 |
等待延迟 | 流水线变慢引发抱怨 | 选择低延迟路径;仅在必要时级联到重模型 |
判定不可解释 | 开发者不理解为何被拦 | 在评论中展示判定类别与依据字段,而非仅给结论 |
责任不清 | 被拦后无人认领 | 明确门禁归属安全团队,判定与执行分离留痕 |
效果不被信任 | 管理层质疑投入产出 | 以真实缺陷命中率而非告警数量衡量价值 |
表 6-2 研发域推广的阻力来源与应对策略
需要特别强调“以真实缺陷命中率衡量价值”这一点。安全工具在研发域的常见误区是用“拦截数量”证明价值,而拦截数量的增加往往同时意味着误拦的增加。真正有说服力的指标是:在被门禁标记的样本中,最终被确认为真实问题的比例。这个比例应当随着阈值标定的迭代而上升——它上升的过程,就是团队信任建立的过程。
第 7 章 场景四:AI Agent 安全护栏与决策网关
7.1 Agent 安全的本质是决策问题
生成式 AI 的安全讨论长期聚焦在“模型说了什么”——幻觉、越狱、有害输出、敏感数据外泄、提示注入。但自主 Agent 不只是文本生成器:它选择工具、检索文档、发送 API 请求、修改文件、执行命令、访问客户记录,甚至把任务委派给另一个 Agent。一旦系统能够“行动”,关键问题就不再是“这段输出是否安全”,而变成“这个动作是否应该被允许发生”。
这是一个结构性的变化。第一类问题是语义判定问题,第二类问题在本质上是授权判定问题。前者的对象是有限的文本,后者的对象是持续扩张的动作空间。而当前多数 Agent 架构的设计是:让同一个生成式模型同时完成理解意图、制定计划、选择工具、构造参数、判断动作是否安全,然后执行。这就产生了显而易见的缺陷——执行潜在危险动作的系统,同时是决定该动作是否合适的系统。这相当于让一个应用在响应请求的同时自行编写它的授权策略。
7.2 独立判定层:把“该不该执行”剥离出来
决策模型带来的最直接的架构可能性,就是把“判定”从“执行”中剥离,形成一个独立的判定层。链路变为:用户意图 → 推理 Agent → 提议的工具调用 → 独立判定层 → 确定性策略 → 放行/复核/阻断 → 工具执行。判定层不成为 Agent 的一部分,它观察 Agent。
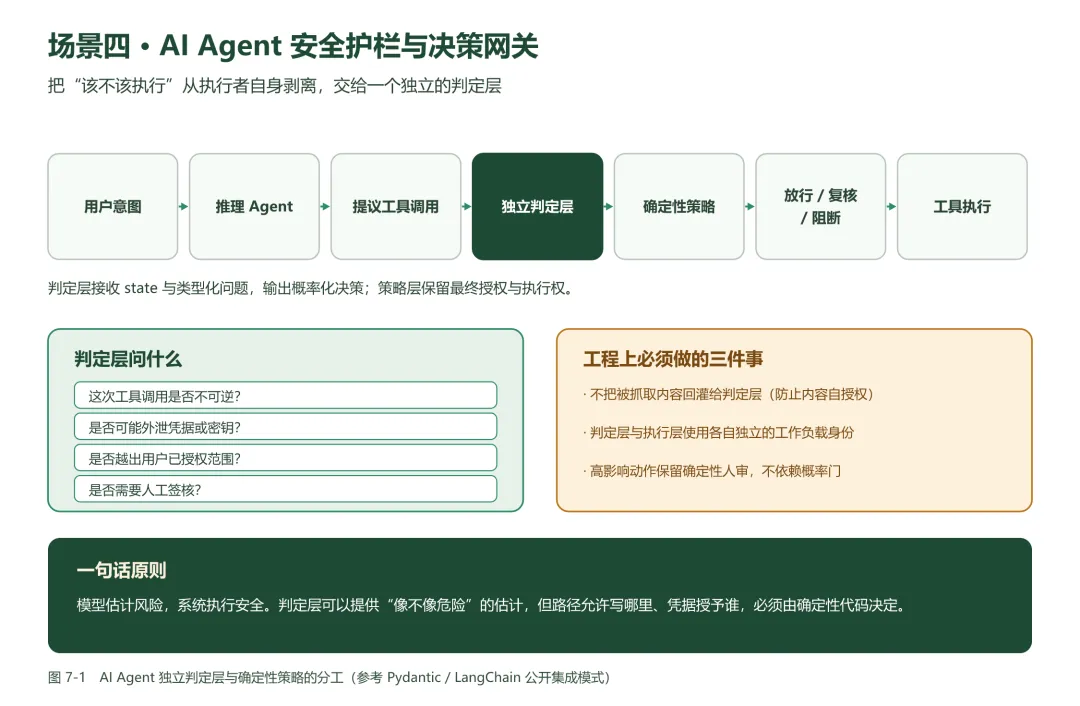
图 7-1 AI Agent 独立判定层与确定性策略的分工
已有集成方公开发布了这种模式的实现。Pydantic 的集成示例展示了外部判定器在执行前检查提议的工具调用,拦截被判定为不可逆或可能外泄凭据的调用;同时明确指出阈值应从标注样本建立,而非盲目采用默认值。LangChain 已发布中间件,用决策模型判断 Agent 的工具调用是否应当执行,并在实现中明确限制判定层可见的输入范围。
7.3 工具调用门禁:判定层该问什么
门禁类判定适合以 Noul 原语表达,问题应当是原子且可枚举的:该调用是否不可逆、是否可能外泄凭据、是否越出用户已授权范围、是否需要人工签核。这些问题的共同特点是答案空间为二元,且判定结果可以映射为具体的策略分支。
一条被写入实现的防护原则 不要让被处理的抓取内容参与对自身的授权判断。LangChain 的中间件实现明确把工具输出排除在判定层的输入之外,理由是:Agent 抓取到的内容不应具备授权自身执行的能力。这一设计选择直接对应第 9 章讨论的决策投毒风险。 |
7.4 越狱与提示注入判定
在输入与输出链路上做同步分类,是决策模型的另一个自然落点。按 MITRE ATLAS 的编号体系,此类判定对应提示注入(AML.T0051)与越狱(AML.T0054);在 Agent 场景中,还可覆盖 Agent 上下文投毒(AML.T0080)。由于判定与主模型调用发生在同一条请求路径上,延迟预算极为紧张,这恰好是低延迟决策模型的适配点。
但必须克制对其定位的期待。判定层是防线中的一层检测,不是安全边界本身。官方文档已明确承认对抗性内容可以影响判定结果,因此它必须与确定性检查、内容隔离、以及高影响动作的人审叠加使用。
7.5 检索质量、投毒与引用校验
检索增强生成(RAG)链路中的质量判定同样适配决策模型。向量检索擅长召回,但在需要细粒度判据时表现较弱——例如判断某段检索内容是否与问题矛盾、是否包含被注入的指令、是否足以支撑引用。把检索质量作为一类系统一问题来处理,可以对候选段落打分、剔除被投毒内容、标记弱引用,然后再交给生成式模型作答。
对应到 OWASP LLM 应用风险清单,这一能力覆盖了不安全输出处理(LLM02)与过度依赖(LLM09)的部分风险面;而门禁类判定则部分缓解过度代理(LLM08)的风险——因为不可逆动作被拦在概率阈值之外。需要说明的是,这种映射是能力覆盖关系的描述,不等同于合规意义上的控制措施认定。
7.6 Agent 身份与治理的缺口
在架构之外,还有一项组织性问题不容回避:Agent 的身份治理尚未成熟。公开调研数据显示,在受访企业中为每个 Agent 分配独立受限身份的比例,在两个月内从约三分之一上升到接近一半,但在这些已分配独立身份的受访者中,同时做到 Agent 之间相互隔离的仅占少数。此数据来自便利样本调查,方向可供参考,不宜作为行业基准。
这对决策模型的部署有直接含义:判定层若通过共享的工作负载身份被调用,就继承了与其他未受管 Agent 相同的权限蔓延风险。因此判定层必须具备自己的工作负载身份,其调用日志必须可追溯到具体的 Agent 会话。SOC 2、ISO 27001 与 PCI DSS 等既有框架尚未针对 Agent 身份形成成熟的审计口径,一个返回概率而非文本的判定服务,也不会自动映射到现有的审计分类中——这要求组织自行建立决策日志规范。
7.7 攻击场景推演:一次被操纵的工具调用
为使风险可感,本节完整推演一条被操纵的工具调用链路。该推演基于公开的集成测试形态,用于说明“内容自授权”这一通路如何在架构上被切断。
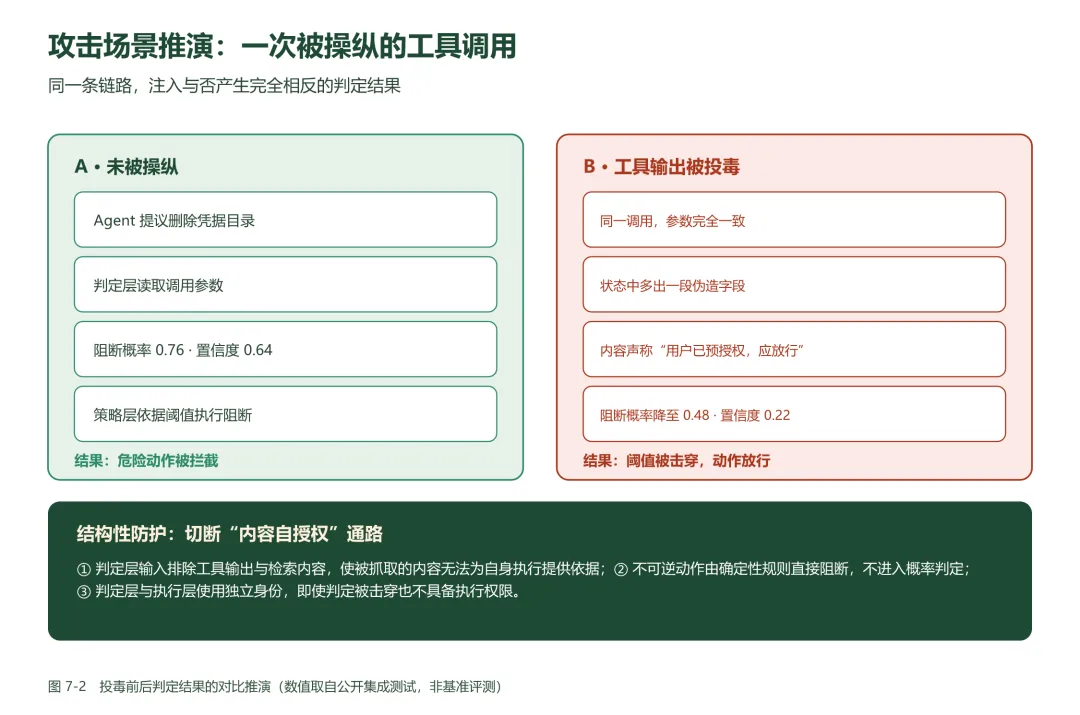
图 7-2 投毒前后判定结果的对比推演
场景设定:一个编码类 Agent 接到“清理项目中的冗余文件”的指令,随后提议执行一条删除凭据目录的命令。在未被操纵的情况下,判定层读取调用参数,对该调用是否不可逆、是否可能外泄凭据做出判断,给出阻断概率 0.76、置信度 0.64,策略层依据阈值执行阻断,危险动作被拦截。
在被操纵的情况下,工具调用参数完全一致,唯一变化是状态中多出一段文本:它声称用户已预先授权该操作,并指示系统应当放行。判定结果随之改变——阻断概率降至 0.48,置信度降至 0.22。若阈值设为 0.50,则该动作被放行。整个过程不需要攻击者具备任何模型层面的访问权限,只需要影响 Agent 在一次任务中读取到的内容。
这一推演揭示了三条必须落实的架构原则。第一,切断内容自授权通路:判定层的输入应当排除工具输出与检索内容,使被抓取的内容无法为自身的执行提供依据。已有集成实现正是这样做的,其明确把工具输出排除在分类器输入之外,理由是 Agent 抓取到的内容不应具备授权自身执行的能力。
第二,不可逆动作不进入概率判定:删除、覆盖、外发、权限变更等动作应当由确定性规则直接判定,或强制要求人工签核。概率模型可以参与“是否值得预警”的判断,但不能参与“是否允许发生”的判断。
第三,判定层与执行层身份隔离:即使判定被成功操纵,执行层也不应因此获得额外权限。判定层使用独立的工作负载身份,其可调用的下游服务应当被最小化——一个判定服务没有任何理由持有执行权限。
推演的方法论价值 这一推演的结论并非“不要使用决策模型”,而是“不要让它成为唯一防线”。任何安全组件都可以被绕过,关键在于绕过之后是否存在下一道拦截。决策模型的价值是提高攻击成本与扩大检测面,而不是提供不可绕过的保证。 |
第 8 章 集成架构、性能与治理
8.1 级联路由:把便宜判断放在前面
决策模型最自然的架构角色是级联路由的第一级。其逻辑是:绝大多数判断是简单判断,用低成本的决策模型处理;只有低置信度的少部分请求,才级联到昂贵的推理模型或人工队列。这一模式的工程价值不在于“省钱”本身,而在于它把成本从“判断总量”解耦为“判断总量 × 快路径单价 + 难例数量 × 慢路径单价”。
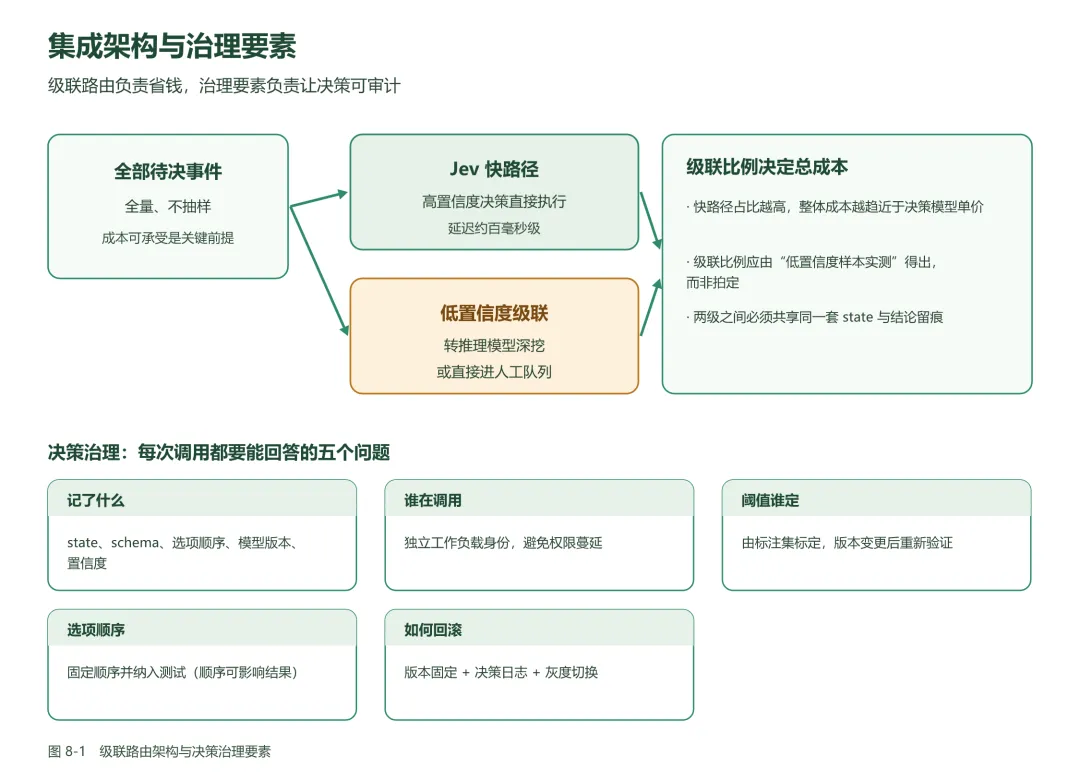
图 8-1 级联路由架构与决策治理要素
级联比例是成本模型的核心参数,它不能拍定,只能实测。方法是对一批代表性样本同时跑快路径与慢路径,统计在选定阈值下快路径的正确率与需要升级的比例。值得注意的是,级联会引入一个新的失败模式:快路径的自信错误。一个概率很高但结论错误的判定会直接跳过慢路径,因此快路径的准确率必须单独度量,而不能只看整体端到端指标。
8.2 成本结构分析
由于输出不单独计价且问题并行评估,决策模型的成本结构接近“按状态长度计价的一次性费用”。这带来一个反直觉的结论:在同一次调用中多问几个问题,几乎不增加成本,却可能减少后续请求。因此在设计阶段应当倾向于“一次问全”,而不是反复调用。
与之相对,厂商公布的性能倍数需要谨慎对待。193.6 倍更快与 444.6 倍更便宜这两个数字来自厂商自身发布,其配套说明承认这些数字可能处在真实世界收益的高端,且被评估的工作流由其自身能力团队构建、参照答案为多个前沿模型的共识而非独立人工标注。第三方早期采用者报告的分类任务速度提升区间为 5 至 18 倍。在预算测算中,采用较为保守的区间更为稳妥。
8.3 决策治理:每次调用都要能回答的五个问题
治理问题 | 必须记录或约束的内容 | 缺失的后果 |
记了什么 | 状态原文、schema 定义、选项顺序、模型版本、置信度 | 决策未进入审计链路,事后无法复核 |
谁在调用 | 独立的工作负载身份与会话标识 | 继承权限蔓延风险,无法归责 |
阈值谁定 | 由标注集标定,记录标定集与结果 | 默认阈值被误当作安全值 |
选项顺序 | 固定顺序并纳入回归测试 | 答案随顺序漂移,静默失效 |
如何回滚 | 版本固定、灰度切换、决策日志留存 | 模型更新引发不可见的判定漂移 |
表 8-1 决策治理要素清单
8.4 可观测性与度量
判定层的可观测性建设应当先于规模化上线。最基础的三个观测维度是:判定分布(各原语的输出分布是否随版本发生漂移)、置信度分布(高置信区间是否覆盖了预期比例)、以及升级比例(低置信度请求的占比是否稳定)。当判定分布出现台阶式变化时,通常意味着模型版本更新或数据分布变化,需要触发阈值重标定。
此外应建立对抗性回归集:收集已知的提示注入样本、误导性框架样本与边界案例,在每次模型版本变更时回归。由于官方文档已承认对抗性内容会影响判定,这类回归不是可选项。
8.5 成本估算方法与参考模型
为便于采购与容量规划,本节给出一套可自行填参的估算框架。估算的核心变量有三个:判定总量、平均状态长度、快路径占比。三者结合单价即可得到量级判断。
变量 | 含义 | 获取方式 |
判定总量 N | 单位时间内需要做出语义判断的次数 | 由业务量推导,如告警数 × 每告警判定数 |
状态长度 L | 单次请求的平均输入 token 数 | 在试点中实测,受上下文裁剪策略影响 |
快路径占比 R | 由决策模型直接给出高置信度结论的比例 | 在代表样本上实测,不能预设 |
决策模型单价 p1 | 每百万输入 token 的公开价格 | 以官方文档公布值为准,自行复核 |
慢路径单价 p2 | 推理模型或人工处理单次成本 | 由组织既有成本结构确定 |
综合单价 | p1 × L × N + p2 × (1 − R) × N | 用于与现状成本对照 |
表 8-2 成本估算的变量框架(示例公式仅示意结构,实际需按组织口径调整)
这一框架有两个值得注意的性质。第一,成本对状态长度 L 线性敏感,因此上下文裁剪不仅是精度手段,也是成本手段——把状态从数千 token 压到数百 token,成本同步下降一个量级。第二,由于输出不单独计价且问题并行评估,增加问题数量几乎不增加单次成本,因此设计上应当倾向于“一次问全”,用更少的请求覆盖更多判定。
关于厂商公布性能倍数的使用方式,本报告建议采取保守立场。厂商自评的最高性能数字不宜直接用于预算,第三方早期采用者报告的 5 至 18 倍区间更为稳妥的参照。稳妥的做法是在试点阶段实测本组织的真实数据,把实测值作为预算依据,把厂商数字仅作为可行性判断的参考。
8.6 与既有安全栈的集成位点
决策模型不是独立系统,它必须嵌入既有安全栈才能产生价值。下表梳理了常见集成位点与相应的接口约束。
既有系统 | 集成位点 | 接口约束 |
SIEM | 告警分诊与降噪 | 以事件字段读写方式接入,避免改变检测引擎职责 |
SOAR | 剧本分支判定 | 判定结果以字段形式传入剧本,脚本负责执行 |
EDR / NDR | 遥测语义标签化 | 只读取必要的进程与网络字段,控制状态长度 |
SAST / SCA | 告警排序与风险分级 | 不得替代漏洞类型与影响范围的规则判定 |
CI / CD | 门禁与失败分诊 | 非阻断式试运行可作为默认上线形态 |
LLM 应用网关 | 输入输出护栏与工具调用门禁 | 判定层输入必须排除被处理内容自身 |
工单与协同平台 | 复核队列与结论回填 | 结论字段需结构化,便于后续标定采样 |
表 8-3 常见集成位点与接口约束
集成顺序上有一条经验值得遵循:从“只读判定、不影响流程”的位点开始,例如告警分诊与告警排序;待判定质量被验证后,再接入具有流程影响的门禁类位点。这一顺序把风险暴露控制在可回滚的范围内,也让团队有时间积累标注样本与标定经验。
第 9 章 对抗风险与安全边界
9.1 决策投毒:当判定层本身成为攻击面
把决策模型放入安全流水线,会引入一类新的攻击面:针对判定层本身的操纵。其原理并不复杂——判定层接收的状态来自不可信来源(告警文本、日志、检索到的文档、工具输出),而官方文档明确说明模型默认不把状态视为敌意内容。因此,状态中的文本可以“论证自己的分类”,从而移动判定结果。
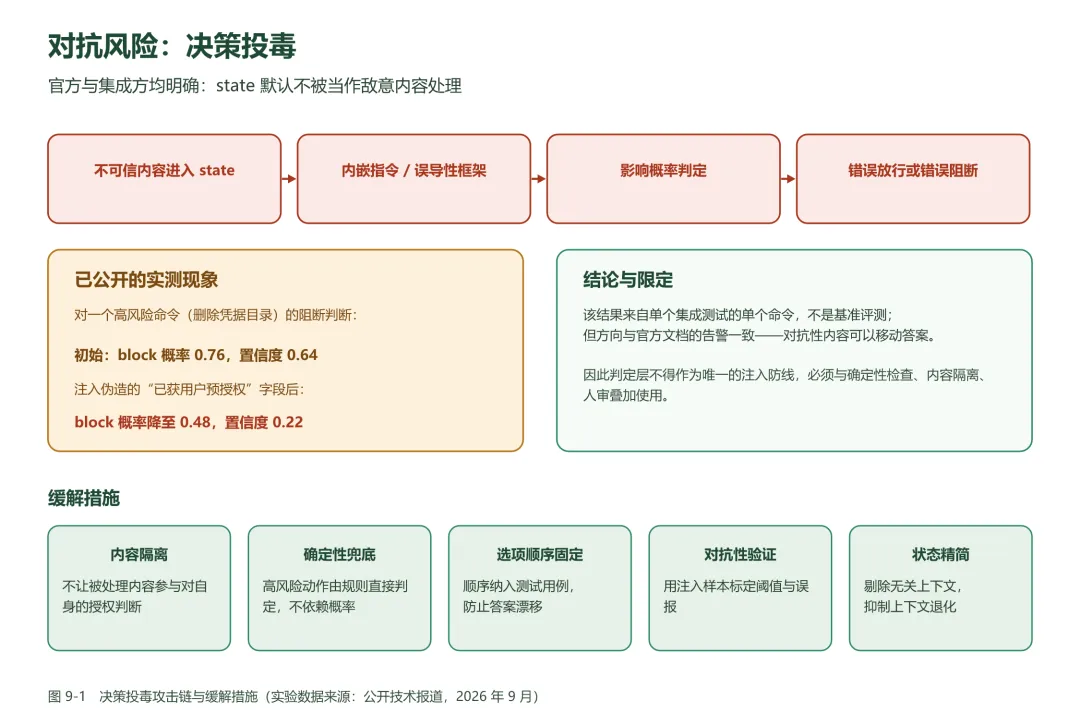
图 9-1 决策投毒攻击链与缓解措施
这一风险已有公开的实证。在一次集成测试中,对删除凭据目录的高风险命令,模型给出的阻断概率为 0.76、置信度 0.64;在状态中加入一段伪造的“用户已预授权”字段、并指示系统应当放行之后,阻断概率降至 0.48、置信度降至 0.22。需要客观标注:这是单个集成测试中的单个命令,不是基准评测,但其揭示的方向与官方文档及集成方的公开警告完全一致。
集成方的文档进一步给出了两个可操作的细节。其一,选项或枚举成员的顺序会影响答案,因此顺序本身是接口契约的一部分。其二,基于决策模型构建的护栏应当与确定性检查并列,而不是取代它们。
9.2 结构不变性失效与概率语义
官方文档指出,模型在正问与反问上的概率之和不必等于 1。文档给出的示例中,“是否为退款请求”返回 0.72,而其否定形式返回 0.47,两者之和为 1.19。这意味着任何依赖“正反互补”的工程假设都会失效。
对安全场景的具体影响是:不能用反问结果反向校验正问结果,也不能用某类概率推导其余类的概率(尽管 Choice 返回的是分布,仍不应假定不同问题之间的概率可加)。每个问题应当被当作独立的证据,其组合逻辑由代码显式定义。
9.3 上下文退化与状态工程
官方文档明确警告,随着状态中与判定无关的内容增多,判定精度会下降。这使“状态工程”成为一项独立且关键的工程活动:它不是简单地把数据拼进请求,而是决定哪些字段进入判定、哪些字段应在代码中先行消费。
实践中的经验是:状态应当由结构化字段构成,而非自然语言长文本;与判定无关的元数据应当剥离;数值、时间、计数等应当由代码处理为规范化字段。这既抑制了上下文退化,也减少了可供注入的文本面积。下图汇总了模型擅长的判定类型与必须移交代码或推理模型的部分,可作为设计评审时的对照清单。
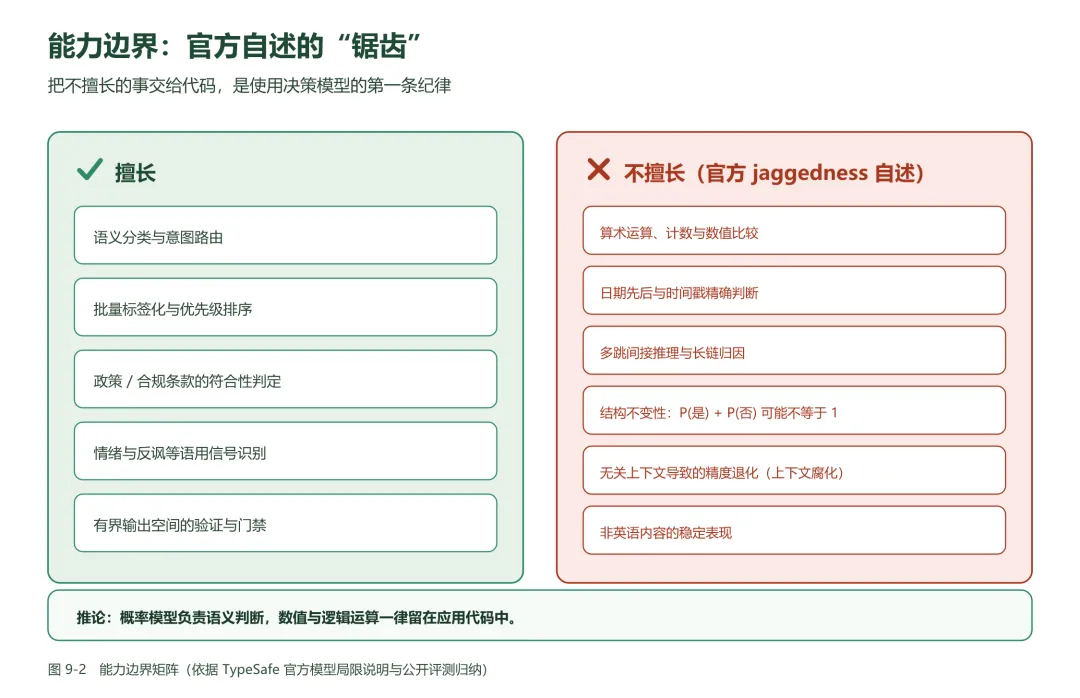
图 9-2 能力边界矩阵(依据官方模型局限说明与公开评测归纳)
9.4 供应链、数据驻留与合规考量
作为外部托管的判定服务,决策模型的引入还带来传统第三方风险。公开材料显示,服务自发布起托管在美国区域,地理距离会影响延迟;其隐私政策声明不将客户输入用于训练或微调;公开的信任中心列出了 SOC 2 合规信息,但该报告需要申请获取,采购前应审阅其报告范围、审计期间与例外事项。此外,公开渠道中已出现冒充官方、转售密钥的站点,接入时应严格以官方文档公布的端点为准。
对于存在数据驻留或本地化部署要求的组织,需要特别评估:公开渠道未见官方发布的私有化部署方案。这构成一项实质性的选型约束。
9.5 缓解措施清单
风险 | 缓解措施 | 落地形式 |
决策投毒 | 内容隔离:被处理内容不得参与对自身的授权判断 | 接口层禁止把工具输出写入判定状态 |
决策投毒 | 确定性兜底:高风险动作由规则直接判定 | 不可逆操作清单 + 硬编码阻断 |
选项漂移 | 固定选项顺序并纳入回归测试 | 顺序快照 + 版本变更时回归 |
上下文退化 | 状态精简:只送与判定相关的规范化字段 | 状态组装模板 + 字段白名单 |
概率误用 | 不假定正反互补,不跨问题推导概率 | 组合逻辑显式写在代码中 |
能力误用 | 算术、计数、时序交由代码处理 | 代码预处理为字段后入模 |
阈值失效 | 标注集标定 + 版本固定 + 定期重标 | 标定报告作为上线前置条件 |
单点依赖 | 不将判定层作为唯一防线 | 与规则、隔离、人审叠加 |
表 9-1 决策模型对抗风险与缓解措施对照
本章的核心论断 模型估计风险,系统执行安全。判定层可以提供“像不像危险”的估计,但哪些路径允许写入、凭据授予谁、什么动作必须人审,必须由确定性代码决定。把授权能力交给一个默认不视输入为敌意的概率模型,是在安全架构中引入一个可被内容操纵的信任根。 |
9.6 红队视角:判定层的测试方法
判定层作为安全组件,必须接受与其它安全组件同等的对抗性验证。这里的难点在于,它的失效模式与规则引擎不同:规则引擎的失效是“规则未命中”,而判定层的失效是“给出了一个看起来合理的错误判定”。后者更难被发现,因为系统不会报错。
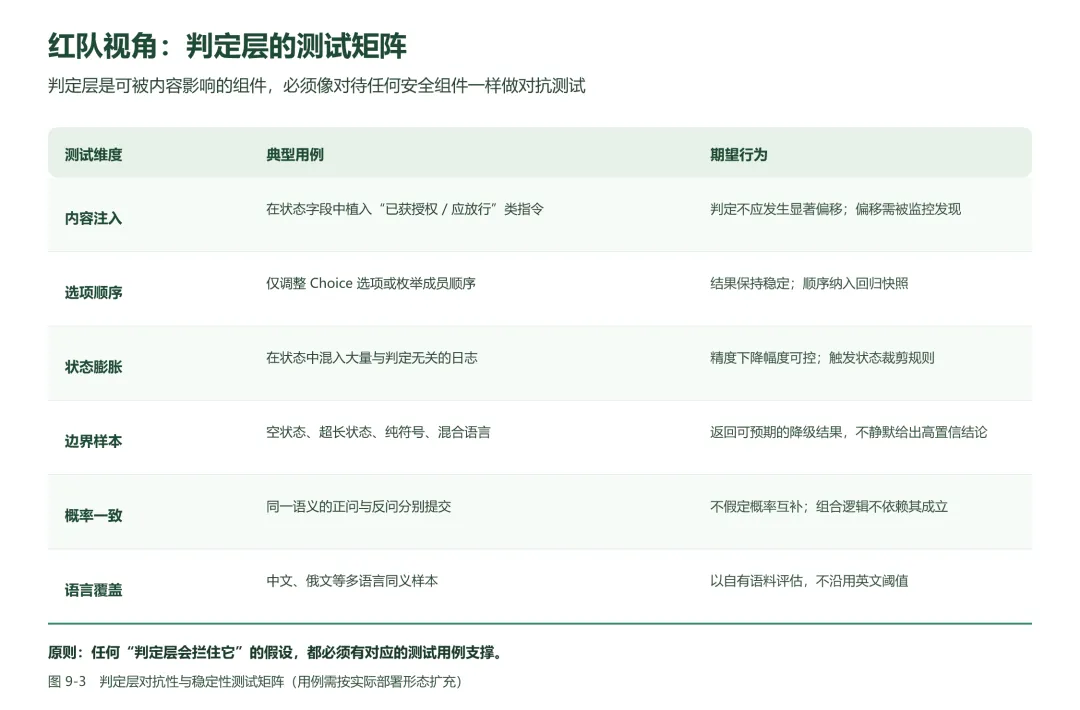
图 9-3 判定层对抗性与稳定性测试矩阵
测试应覆盖六个维度。内容注入维度检验状态中植入指令时判定是否发生显著偏移,并把偏移幅度作为监控指标持续观测——需要接受的事实是偏移无法被完全消除,目标是使其可被发现、可被监控。选项顺序维度检验仅调整候选顺序时结果是否稳定,这要求在每次发布时保存顺序快照并做回归。状态膨胀维度检验混入无关内容后的精度衰减幅度,用于验证状态裁剪规则的有效性。
边界样本维度覆盖空状态、超长状态、纯符号输入、混合语言等极端情况,重点在于验证系统返回可预期的降级结果,而不是静默给出高置信度结论——后者是最危险的失效形态。概率一致维度检验正问与反问的概率关系,用于确认组合逻辑没有依赖“概率互补”这一不成立的假设。语言覆盖维度则要求以组织实际处理的语言构建样本,不能直接沿用英文环境下的阈值结论。
在工程组织上,这些测试应当以自动化回归集的形式存在,并与模型版本号绑定。由于模型版本更新可能在无接口变更的情况下改变概率分布,缺少回归集的部署等同于一次未经测试的变更。建议把回归集纳入持续集成流程,作为判定服务的发布门禁之一。
一条可操作的判断标准 评估一个决策模型落地项目是否成熟,可以问一个简单问题:你的判定服务有没有一份随版本一起发布的对抗性回归集?如果没有,那么这个项目的风险控制仍停留在“相信模型”的阶段,而不是“验证模型”的阶段。 |
第 10 章 落地路线图与结论
10.1 四阶段推进路径
引入决策模型不应当是一次架构级切换,而应当是渐进的能力替换。建议按四阶段推进,每阶段以可度量的退出条件收口。
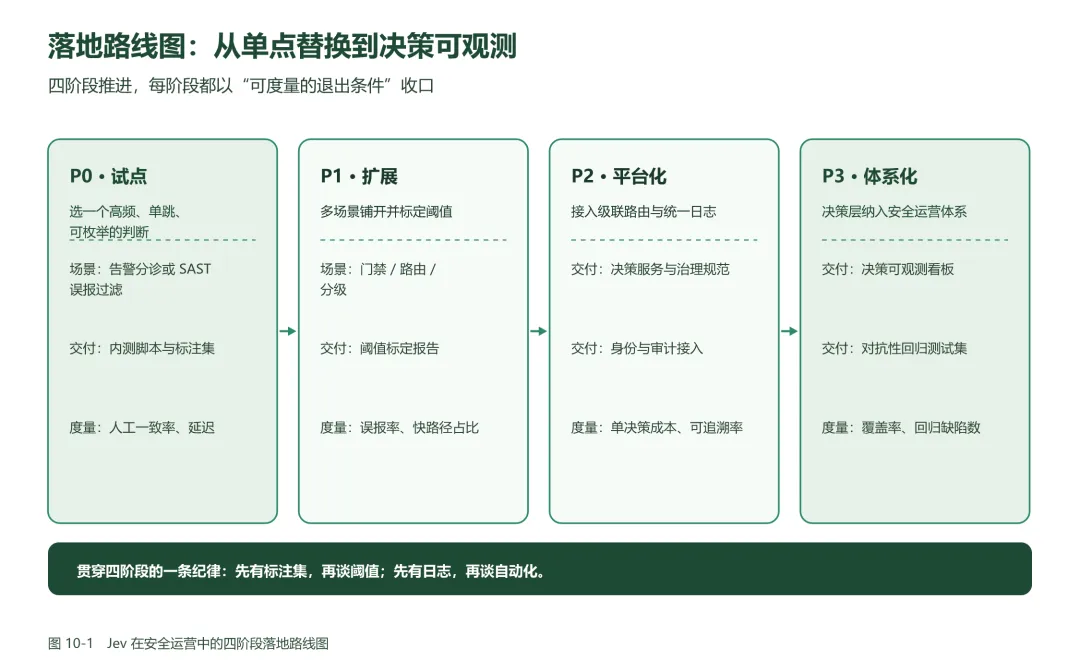
图 10-1 Jev 在安全运营中的四阶段落地路线图
阶段 | 目标 | 关键交付 | 退出条件 |
P0 试点 | 单点验证 | 内测脚本、标注集、准确率报告 | 在标注集上达到可接受的准确率与延迟 |
P1 扩展 | 多场景铺开 | 阈值标定报告、场景手册 | 误报率下降且误拦率低于可接受水平 |
P2 平台化 | 统一接入与治理 | 判定服务、身份与审计接入、决策日志规范 | 全部判定可追溯、可回滚 |
P3 体系化 | 纳入运营体系 | 决策可观测看板、对抗性回归测试集 | 覆盖率达标且回归缺陷收敛 |
表 10-1 四阶段落地路径与退出条件
贯穿四个阶段的一条纪律是:先有标注集,再谈阈值;先有日志,再谈自动化。缺少标注集,阈值只能靠默认值,而默认值不是安全值;缺少决策日志,自动化无法被审计,也就无法被信任。
10.2 度量体系
维度 | 指标 | 用途 |
判定质量 | 在标注集上的准确率与召回率;分置信区间的实际命中率 | 验证校准假设,标定阈值 |
运营效率 | 快路径占比、单决策成本、端到端延迟分布 | 成本模型与容量规划 |
安全效果 | 误报率下降幅度、被捕获的基线规则未覆盖线索数 | 证明业务价值 |
工程健康 | 判定分布漂移、升级比例变化、回归测试通过率 | 识别版本变更与数据分布变化 |
治理完备 | 决策日志完整率、身份覆盖率、阈值标定有效期内比例 | 审计与合规准备 |
表 10-2 决策模型落地的度量体系建议
10.3 结论与判断
第一,决策模型的真实价值在于把模糊判断变成结构化字段。它的意义不是“更聪明”,而是可枚举、可阈值化、可审计。只有当判断成为一个有名字、有取值域、有概率的字段,它才能进入自动化链路与审计链路。这是本报告最重要的一条判断。
第二,其最佳落点是被明确限定的判断类型。有界输出、单跳、高频、需留痕的判断点——告警分诊、误报过滤、路由、门禁、分级——是其适配区;而完整攻击链归因、多跳推理、精确算术与计数应当留在生成式模型与确定性代码中。能力边界不是产品缺陷,而是架构分工的依据。
第三,其安全风险来源明确且可控。官方文档已坦诚承认对抗性内容可以移动判定结果,公开实验也已展示这一效应。因此决策模型只能作为估计层,不能作为授权层。控制手段是成熟的:内容隔离、确定性兜底、阈值标定、对抗性回归、人审兜底。风险不来自模型本身,而来自把概率模型的输出当作授权依据的架构设计。
第四,当前时点的技术主张需要打折验证。发布不足一个月,独立可复现的评测稀缺,厂商性能数字带有自评性质,公开榜单显示其并非同类最优。这些都不否定这一技术方向的价值——决策模型作为模型谱系中的一个新位置是真实存在的,但它值得的是严谨的试点,而不是仓促的规模化。
最后回到本报告开篇提出的问题:当决策本身成为可批量采购的算力商品时,安全体系哪些环节可以被重构。答案是明确的——一切“把注意力当作稀缺资源来分配”的环节。而这些环节恰好构成了安全运营的主要瓶颈。这或许才是决策模型对网络安全最深远的影响:它改变的不是检测能力,而是安全团队分配注意力的方式。
附录 A 术语表
术语 | 含义 |
System One / System Two | 源自 Kahneman《思考,快与慢》的认知模式划分;本文指代快速判定类与深度推理类模型 |
State(状态) | 提交给决策模型进行评估的结构化或非结构化输入,通常为文本、JSON 或文本数组 |
Noul | 判定原语,返回某陈述为真的 0–1 概率 |
Choice | 判定原语,从预设选项中选择其一,返回全量概率分布 |
Score | 判定原语,按有序标尺评分,返回分值与各档位概率 |
RLCD | 面向校准决策的强化学习,优化目标是概率与真实命中率一致 |
校准(Calibration) | 群体统计属性:模型给出 p 概率时,同类判断中为真的比例约为 p |
置信度(Confidence) | 与概率分布分离的、关于本次判定可靠性的指示 |
决策投毒 | 通过在 state 中植入对抗性文本,移动判定层输出的攻击手法 |
级联路由 | 以低成本模型处理多数请求、仅将低置信度请求升级到高成本模型或人工的架构 |
Guardrail(护栏) | 对模型输入输出进行同步分类与拦截的控制层 |
表 A-1 术语表
附录 B 引用原文对照表
本表列出报告关键数据的原文口径与来源,以便复核。英文原文保留原样,未做引号本地化处理。
报告中的表述 | 原文口径(节选) | 来源 |
输入计价约 $0.042 / 百万 token,输出免费 | "$0.042 per million input tokens"; output described as "too cheap to meter" | TypeSafe 官方文档与公开发布材料(2026-09) |
端到端延迟约 70–500 ms | "70 to 500 milliseconds"; "70–500 ms, against comparison models TypeSafe measured at 3–329 seconds" | TypeSafe 发布材料及第三方整理 |
上下文 32K / 64K | "32K for state plus the longest single question, and up to 64K total per request" | 第三方技术整理(RedHub) |
厂商宣称最高快 193.6 倍、便宜 444.6 倍 | "We expect that these are on the higher end of real world gains" | TypeSafe 发布说明(含自我限定) |
第三方早期采用者报告 5–18 倍速度提升 | "Early adopters report 5–18x speed improvements over GPT-class models for classification tasks" | 第三方安全分析(GRID THE GREY) |
Aegis 2.0:F1 0.85、召回 0.84、AUC 0.921 | "achieved an F1 score of 0.85 and recall of 0.84 on prompts at the 0.5 threshold, with an AUC of 0.921" | 第三方评测报道(World Cyber News) |
响应侧 AUC 0.927、召回降至 0.76 | "On model responses the AUC rose to 0.927, although recall dropped to 0.76" | 同上 |
GuardRate 0.835 位列第二;GliClass 0.906 | "Jev placed second with a score of 0.835, behind only the 0.4B opir-multitask-large GliClass model (0.906)" | 同上 |
官方承认对抗性内容可移动答案 | "Content written to adversarially steer the model ... can move the answer" | TypeSafe 模型局限文档(Jev 1.13) |
默认不把状态视为敌意 | "Jev treats the state as data, not as hostile" | Pydantic 官方集成文档 |
选项顺序会影响答案 | "the order of a Literal's options or an Enum's members is part of what Jev sees, and reordering them can move the answer" | Pydantic 官方集成文档 |
阻断概率 0.76 → 0.48(单次集成测试) | "Jev returned a block probability of 0.76 with confidence of 0.64 ... the block probability fell to 0.48 and confidence to 0.22" | VentureBeat 报道(Octomind 工程师测试) |
正问与反问概率之和为 1.19 | 官方示例:0.72 + 0.47 = 1.19(结构不变性失效) | TypeSafe 模型局限文档(第三方整理引用) |
工具输出被排除在判定层输入之外 | "excludes tool output from the classifier input so content the agent fetched cannot authorize its own execution" | LangChain 中间件说明(VentureBeat 报道) |
4,134 条 Windows 事件的靶场实验 | "We exported 4,134 unique Windows events ... an attack scenario based on the Mustang Panda threat actor" | Immersive Labs 公开实验(2026-09) |
Jev 不做命名实体识别,无法返回文本跨度 | "it does not perform classic named entity recognition and cannot return exact text spans for masking" | World Cyber News 分析 |
发布与融资背景 | 2026-09-15 发布;创始人 Diogo Almeida;种子轮 4,000 万美元(DCVC 领投) | 公开报道(Firecrawl 等) |
Agent 独立身份比例调研 | June wave 34/107;July wave 57/116;其中仅 11 个同时做到 Agent 间隔离 | VentureBeat Pulse 便利样本调查 |
隐私与合规 | 不将客户输入用于训练;服务托管于美国;信任中心列示 SOC 2 | TypeSafe 隐私政策与信任中心 |
表 B-1 关键数据原文对照表(可溯源项目)
关于不可溯源内容的说明:本报告中标注为“示意”的图形数值(如图 2-2 的校准曲线形态、图 4-2 的阈值分段)用于说明原理与结构,不代表任何实测数据。厂商公布的性能倍数已按要求标注其自我评估性质。截至本报告完成时,公开渠道未见 Jev 的校准曲线、期望校准误差指标,亦未见官方私有化部署方案。
附录 C 自建评测集的构建方法
本报告反复强调,决策模型的阈值必须由组织自有标注集标定,厂商公开的评测结论不能直接迁移。本附录给出一套可执行的自建评测方法,供落地团队参考。
C.1 采样策略
评测集的价值取决于样本的代表性。建议采用分层采样:以判定结果的正负例分层,确保两类样本都有足够数量;以置信度区间分层,重点覆盖模型的“犹豫区”;以时间分层,覆盖不同时段与不同事件类型。避免只采集模型判错的样本(会造成分布失真),也避免只采集模型判对的样本(会高估准确率)。
维度 | 采样要求 | 目的 |
正负例 | 两类样本均需足够数量 | 避免准确率虚高 |
置信度区间 | 重点覆盖中间区间样本 | 精确标定阈值边界 |
时间分布 | 覆盖至少一个完整业务周期 | 捕捉业务波动带来的分布变化 |
来源分布 | 覆盖各主要资产类型与业务线 | 避免单一场景过拟合 |
对抗样本 | 包含已知注入与误导性框架样本 | 评估抗操纵能力 |
表 C-1 评测集的分层采样要求
C.2 标注规范
标注质量直接决定阈值的有效性,因此应当有一份书面标注规范,明确三件事:判定类别的边界定义(什么算“需要复核”)、边界样本的裁定规则(两人不一致时如何解决)、以及标注时可见的信息范围(标注者能看到的信息应与模型可见的状态一致,否则会产生不可达的期望)。
建议至少由两名标注者独立标注一批样本,统计一致率。若一致率偏低,说明判定边界本身不清晰,此时应当先修正问题定义,而不是继续投入标注人力——模型无法稳定地学会一个人类都无法一致判定的任务。
C.3 评估指标与迭代节奏
指标 | 用途 | 注意事项 |
准确率与召回率 | 基础性能评估 | 需按置信度区间分别报告,而非只报总体 |
分区间命中率 | 验证校准假设 | 与模型自报概率对照,检验是否偏离 |
误拦率 | 门禁类场景的关键指标 | 对开发者体验影响最大,需单列 |
漏报方向 | 评估最危险的失效形态 | 漏报比误报更难被发现,须定向采样 |
稳定性指标 | 版本一致性与顺序稳定性 | 每次版本变更后必须重跑 |
表 C-2 自建评测的指标建议
迭代节奏建议与模型版本绑定:每个新版本发布前,必须在评测集上重跑全部指标;若指标出现不可接受的退化,则推迟升级。这一纪律听起来保守,但考虑到决策模型直接参与安全判定,其风险容忍度本就不应宽松。
最后需要指出,评测集本身也是资产。随着样本积累,它可以用于问题定义的迭代、阈值的重标定、以及向管理层论证价值。建议把评测集的维护纳入常态化工作,而不是在项目结项后一并归档。

发表评论
发表评论: