
 研报速递
(完整版.pdf ) 以下仅展示部分内容 下载方式见文末
先进计算产业发展联盟发布的重磅报告,把开源大模型时代的算力战争讲透了:未来拼的不是单卡跑分,而是“芯片+互联+软件+生态+标准”的团体赛。
如果说 2022 年 ChatGPT 是发令枪,2023 年 Llama 开源是分水岭,那么 2026 年 DeepSeek V4 的出现,则把“开源大模型”和“国产算力”推到了同一张牌桌上。
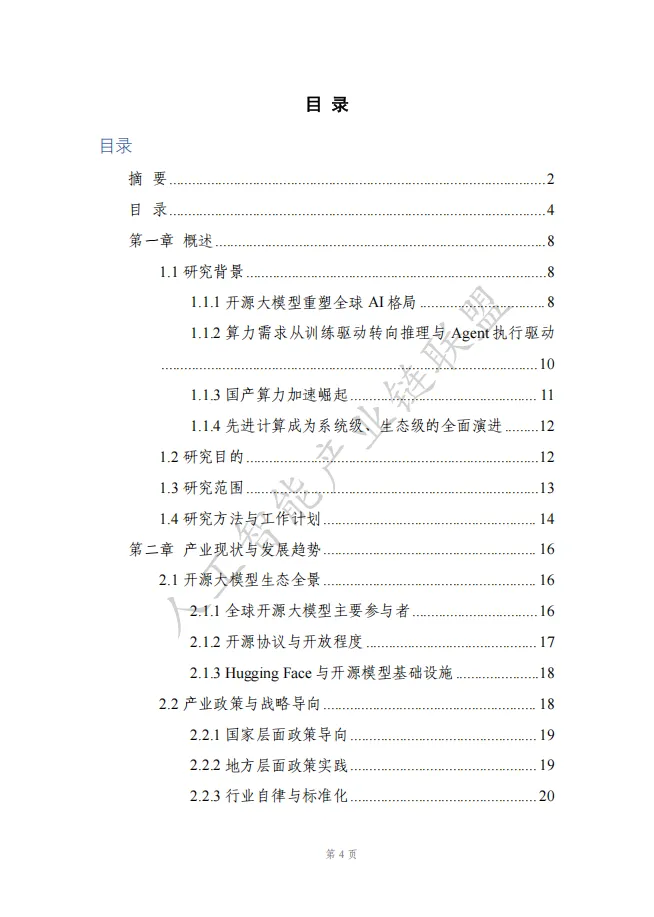
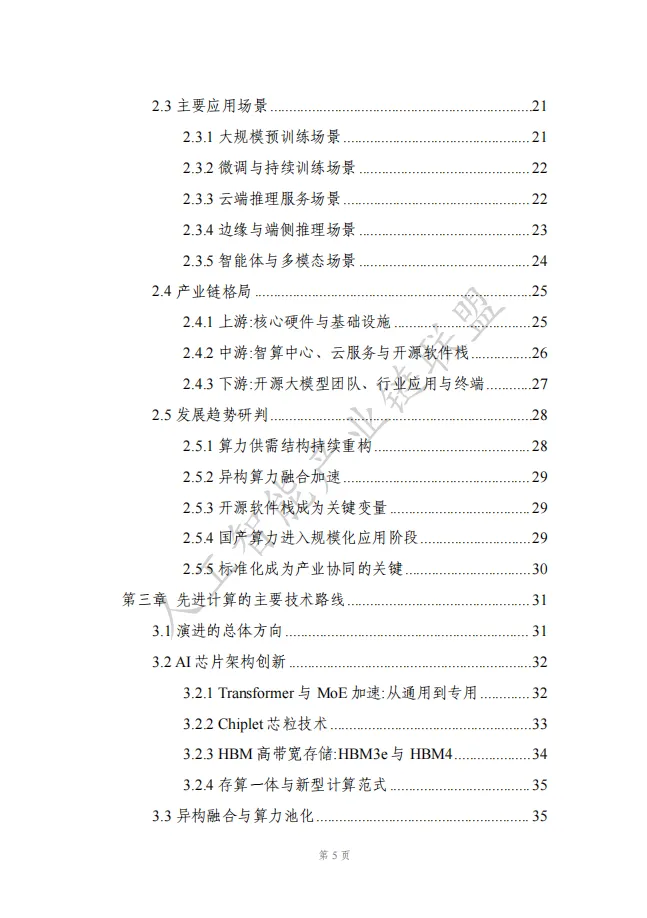
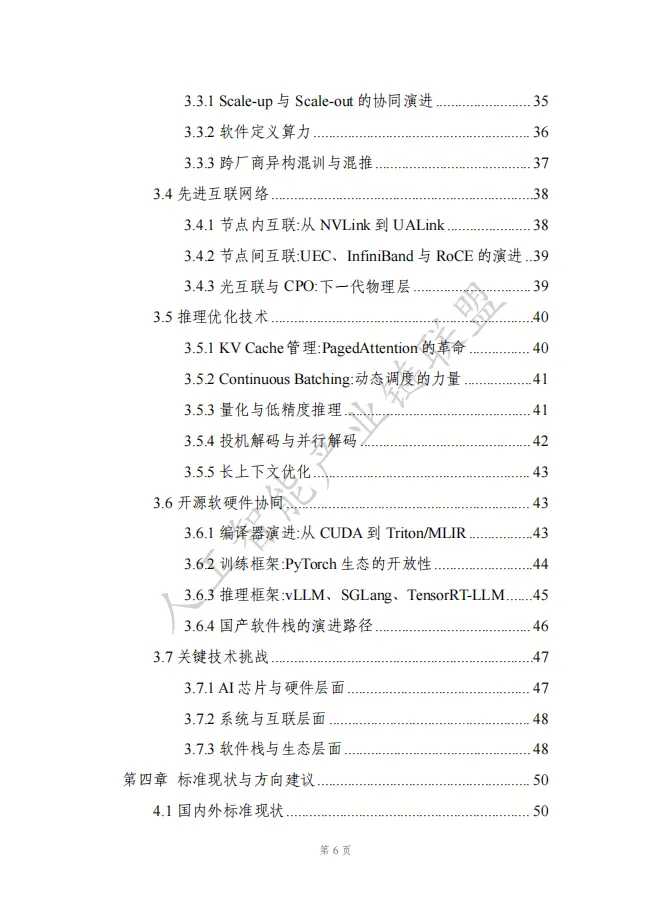
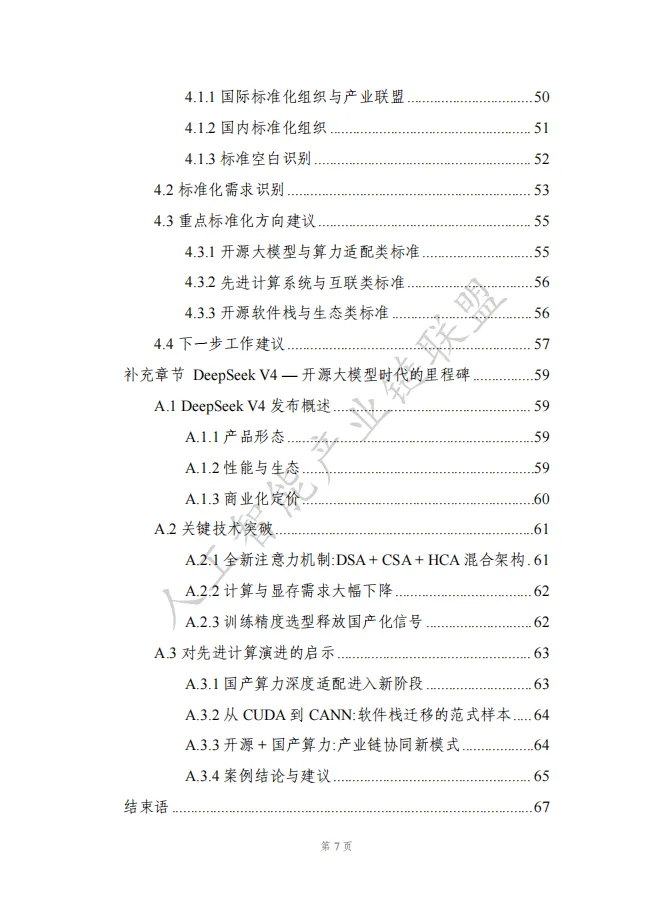
先进计算产业发展联盟发布的《开源大模型时代下先进计算演进的研究报告(2026年)》,系统梳理了开源大模型如何重塑 AI 产业,以及先进计算正在往哪走。今天这篇文章,帮你划出最核心的重点,并用大白话讲清楚:为什么算力竞争变了,谁的机会来了,标准为什么成了关键胜负手。
01 一份报告的核心判断:先进计算,不再只是“芯片的事”
报告开篇就给出一个关键结论:
先进计算已经从“芯片为王”,进入“系统级竞争”和“生态级竞争”的新阶段。
什么意思?
过去大家比的是单颗 AI 芯片的算力、显存、功耗。但现在,一颗芯片再强,如果没有高带宽互联、没有成熟软件栈、没有开源生态支持,实际可用性就会大打折扣。
反过来,即使单卡性能有差距,通过先进互联、并行训练框架、推理优化技术,也能搭出有竞争力的整体方案。
一句话总结:
未来算力竞争,不是单卡跑分,而是“芯片+互联+软件+生态+标准”的团体赛。
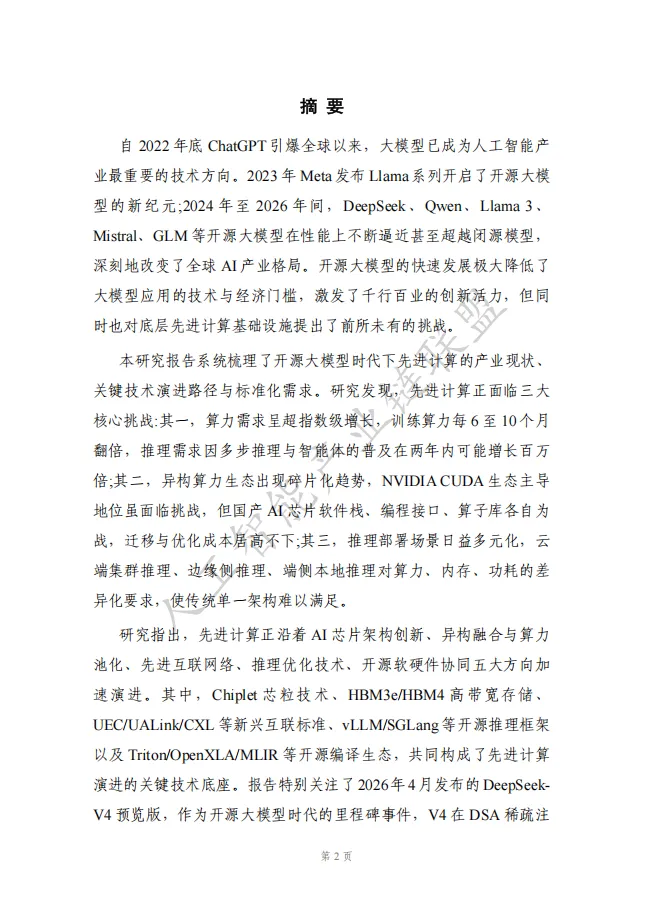
报告指出,先进计算正面临三大核心挑战:
1. 算力需求超指数增长:训练算力每 6 到 10 个月翻倍;推理需求因多步推理和 Agent 普及,两年内可能增长百万倍。 2. 异构算力生态碎片化:NVIDIA CUDA 仍强势,但国产 AI 芯片软件栈、编程接口、算子库各自为战,迁移优化成本高。 3. 推理部署场景多元化:云端集群、边缘侧、端侧本地推理,对算力、内存、功耗要求差异巨大,单一架构难以通吃。
02 开源大模型,如何改写全球 AI 格局?
报告认为,开源大模型是这轮 AI 普及的核心力量。
2023 年 Meta 发布 Llama 系列并开放权重,正式拉开开源大模型时代。此后,DeepSeek、Qwen、Llama 3、Mistral、GLM 等模型不断逼近甚至超越闭源模型。
几个关键数据非常值得关注:
• Hugging Face 模型库收录模型数量已突破百万量级。 • 2026 年春季全球开源 AI 生态报告显示,过去一年 Hugging Face 平台上 41% 的大模型下载量来自中国研发的模型,首次超过美国的 36.5%。 • 国产开源大模型全球累计下载量已突破 100 亿次。 • OpenRouter 2026 年 5 月 6 日 Token 调用量排名中,全球前十有 六款来自中国厂商,包括腾讯 Hy3 preview、Kimi K2.6、DeepSeek V4 Flash、DeepSeek V3.2、MiniMax M2.7、阶跃星辰 Step 3.5 Flash 等。
这意味着什么?
开源大模型不只是“免费模型”,它把 AI 竞争从模型层,拉到了算力层、系统层、生态层。
谁能让开发者低成本用起来,谁就能掌握下一轮产业主动权。
03 算力需求大变天:从“训练狂飙”到“推理+Agent 爆发”
报告最重要的趋势判断之一:
算力需求结构正在从训练驱动,转向推理与 Agent 执行驱动。
早期大模型时代,大家关注预训练:几千到上万张高端 GPU,跑数月,成本数千万到数亿美元。
但进入 2024 到 2026 年,随着多步推理、思维链、智能体 Agent 兴起,推理算力需求开始爆炸。
为什么 Agent 更吃算力?
因为传统问答可能一次推理就结束,而 Agent 要:
• 多轮对话 • 工具调用 • 长链路推理 • 自我反思与规划 • 维护大量上下文
单次任务 Token 消耗,可能是传统对话的几十倍甚至几百倍。
报告引用预测:
• 大模型训练算力大约每 6 至 10 个月翻一倍。 • 推理侧算力需求,因多步推理和 Agent 普及,两年内可能增长百万倍量级。 • 中国新增算力中,智能算力占比已超过 70%,推理算力增速明显高于训练算力。
市场规模同样惊人:
• AMD 预测,2027 年全球数据中心 AI 加速器市场规模约 4000 亿美元。 • 英伟达预计 2025 至 2027 年累计订单超 1 万亿美元。 • 到 2030 年,全球 AI 基础设施市场规模可能达到 3 万亿至 4 万亿美元。
说人话:
训练像建电厂,推理像全民用电,Agent 像 24 小时开工的工厂。真正的算力消耗大头,还在后面。
04 国产算力崛起:从“补短板”到“Day 0 适配”
报告对国产算力的判断非常积极。
华为昇腾、寒武纪、海光、燧原、摩尔线程、壁仞、天数智芯、沐曦、瀚博等一批国产 AI 芯片厂商,已经在大模型训练与推理场景中实现规模化应用。
最具标志性的事件,是 DeepSeek V4。
报告专门增补了 DeepSeek V4 章节,指出:
• DeepSeek V4 预览版于 2026 年 4 月 24 日发布,以 MIT 许可证同步开源。 • V4-Pro:1.6 万亿总参数 / 49B 激活参数,对标顶级闭源模型。 • V4-Flash:2840 亿总参数 / 13B 激活参数,主打高速低成本。 • 两个版本均原生支持 1M token 超长上下文,约 75 万字。
更关键的是:
DeepSeek 将早期访问权限独家开放给国产芯片厂商。
这标志着前沿开源大模型与国产算力首次形成同步发布节奏,也就是“Day 0 适配”。
过去,前沿模型通常优先适配 NVIDIA GPU,国产算力往往滞后数月。现在,国产算力不再是“二等公民”,而是首发合作伙伴。
报告还提到,DeepSeek 团队完成了核心代码从 CUDA 生态向昇腾 CANN 架构的底层迁移。这涉及算子、通信、调度、调试工具链的全面切换,是当前业界最大规模、最深入的开源大模型软件栈迁移实践之一。
资本市场的反应也很直接:V4 发布当日,海光信息、寒武纪、中芯国际等国产芯片板块明显走强。
一句话:
算法省下来的算力,就是国产算力的机会。
05 五大技术路线:先进计算到底往哪走?
报告把先进计算演进归纳为五大方向。我们用大白话逐个拆解。
① AI 芯片架构创新:从通用到专用
大模型几乎都基于 Transformer。矩阵乘法、注意力机制、MoE 稀疏激活、长序列处理,成为芯片设计重心。
关键趋势:
• Transformer 与 MoE 加速:专用稀疏计算单元、动态路由调度、增强 All-to-All 通信。 • Chiplet 芯粒技术:像搭乐高,把大芯片拆成小芯粒,再通过先进封装组合,提升良率、降低成本。 • HBM3e / HBM4:给 GPU 配“超宽内存高速公路”。HBM4 单堆栈带宽将超 2TB/s,容量向 48GB、64GB 演进。 • 存算一体:把计算单元贴近存储单元,缓解“内存墙”。国内知存科技、九天睿芯、亿铸科技、后摩智能等已在端侧低功耗场景产品化。
② 异构融合与算力池化:不同芯片一起干活
• Scale-up:节点内向上扩展,如 NVIDIA NVL72,72 颗 GPU 通过 NVLink Switch 连成一个计算单元。 • Scale-out:节点间向外扩展,万卡甚至十万卡集群。 • 软件定义算力:用软件屏蔽硬件差异,让同一套模型代码跑在不同芯片上。 • 跨厂商异构混训/混推:不同品牌、不同架构 AI 芯片混合使用。挑战大,但价值极高。
③ 先进互联网络:算力集群的“神经系统”
• 节点内:从 NVLink 到开放标准 UALink,最多支持 1024 个加速器互联。 • 节点间:UEC、InfiniBand、RoCE 演进,以太网生态挑战 InfiniBand。 • 光互联与 CPO:共封装光学,把光引擎和芯片封装在一起,降功耗、降延迟、提带宽密度。
④ 推理优化技术:把每一分算力榨干
这是报告中最“接地气”的部分。
• PagedAttention:借鉴操作系统虚拟内存,把 KV Cache 分页管理,显存利用率从不足 50% 提升到 95% 以上。 • Continuous Batching:动态批处理,谁生成完谁先走,新请求随时加入,不再“等最长的那桌”。 • 量化与低精度推理:INT8、INT4、FP8、FP4,显存降 2 到 4 倍,速度提升数倍。 • 投机解码:小模型先草拟,大模型一次性验证,速度提升 2 到 3 倍。 • 长上下文优化:稀疏注意力、线性注意力、KV Cache 压缩、Ring Attention、Flash Attention。
⑤ 开源软硬件协同:CUDA 的护城河正在被撬动
• 编译器:从 CUDA 到 Triton / MLIR / OpenXLA。 • 训练框架:PyTorch 成为事实标准,PyTorch Foundation 中立治理。 • 推理框架:vLLM、SGLang、TensorRT-LLM、LMDeploy、MindIE 百花齐放。 • 国产软件栈:华为 CANN、寒武纪 Neuware、海光 DTK,同时积极对接 PyTorch、vLLM、Triton 等开源生态。
报告特别指出:
开源软件栈的繁荣,客观上削弱了 CUDA 的相对优势,为国产算力厂商提供了重要窗口期。
06 标准战:谁定接口,谁定生态
报告第四章系统梳理了国内外标准现状,并识别出标准空白。
国际方面:
• MLCommons:MLPerf 训练、推理、HPC、客户端评测。 • OCP:OAM、UBB、OCP ESUN 等硬件开放标准。 • UEC、UALink、UCIe、CXL:互联标准。 • IEEE、ITU、ISO/IEC JTC1 SC42:传统标准组织。
国内方面:
• TC28 SC42:AI 异构加速器、计算虚拟化、AI 芯片性能评测等。 • CCSA:算力网络、异构算力管理、互联互通、算力调度。 • 中国电子工业标准化技术协会:Chiplet 互联、先进封装、AI 芯片测试。 • 中国信通院、ACIA、AIIA 等:评测规范与产业协同。
报告指出五大标准空白:
1. 开源大模型在异构 AI 算力平台的适配评测规范缺位。 2. 大规模训练集群技术要求与评测方法不成熟。 3. 先进互联网络接口与互操作规范待统一。 4. 开源软件栈统一编程接口与算子规范未形成。 5. 软硬件协同优化方法论缺乏标准引导。
为此,报告提出三类重点标准化方向:
• 开源大模型与算力适配类标准:适配评测、推理性能基准、迁移与精度对齐。 • 先进计算系统与互联类标准:大规模训练集群、先进互联接口、算力池化与异构调度。 • 开源软件栈与生态类标准:统一编程接口与算子规范、推理引擎互操作、软硬件协同优化方法论。
一句话:
标准不是纸面文章,而是产业协同的“通用语言”。谁先定义接口,谁就掌握生态主动权。
07 DeepSeek V4:报告里的里程碑样本
报告把 DeepSeek V4 作为开源大模型时代的里程碑事件,进行了专题分析。
产品形态
• V4-Pro:1.6 万亿总参数 / 49B 激活参数,对标 GPT-5.5 Pro、Claude Opus 4.7。 • V4-Flash:2840 亿总参数 / 13B 激活参数,主打高速低成本。 • 均原生支持 1M token 超长上下文。 • MIT 许可证开源,兼容 OpenAI ChatCompletions 与 Anthropic 接口。
商业化定价
• V4-Flash:每百万 tokens 输入 0.2 元人民币,输出 2 元人民币。 • 对比 GPT-5.5 Pro:输入 30 美元/百万 tokens,输出 180 美元/百万 tokens。 • 性价比优势极其明显。
关键技术突破
1. 全新注意力机制:DSA + CSA + HCA 混合架构 • DSA:稀疏注意力,只计算最相关键值对。 • CSA:压缩稀疏注意力,进一步降低显存。 • HCA:重压缩注意力,适用于极致性价比场景。 2. 计算与显存需求大幅下降 • 1M token 场景下,V4-Pro 单 token 推理 FLOPs 仅为 V3.2 的 27%。 • KV Cache 用量仅为 V3.2 的 10%。 • 百万级长上下文从“硬件蛮力”进入“算法+系统协同优化”阶段。 3. 训练精度选型释放国产化信号 • 采用 mxFP4,这是 OCP 主导推动的开放低精度数据格式标准。 • 相比 NVIDIA 私有 FP8/FP4 实现,mxFP4 更容易被多厂商采纳,也更便于适配国产芯片。
对先进计算的启示
• 国产算力深度适配进入新阶段,Day 0 适配成为现实。 • 从 CUDA 到 CANN,软件栈迁移有了范式样本。 • “开源+国产算力”形成产业链协同新模式,双向赋能。 • 标准化工作必须跟上:如何评估 Day 0 适配?如何度量长上下文推理?如何支持稀疏注意力硬件?这些问题都亟需答案。
08 专业解读:用大白话看懂几个关键词
KV Cache 是什么?就像你聊天时的“记忆缓存”。上下文越长,缓存越大。PagedAttention 把它切成小页,像操作系统管理内存,显存利用率从 50% 提到 95%。
Continuous Batching 是什么?像餐厅不再等一桌人全吃完才翻台,而是谁吃完谁走,新客随时进。GPU 利用率大幅提升。
Chiplet 是什么?像乐高。以前一颗大芯片,面积越大良率越低。现在拆成小芯粒,再封装在一起,灵活又省钱。
CUDA 和 Triton/MLIR 的关系?CUDA 像 iOS,封闭但强大。Triton/MLIR 像安卓和 USB-C,提供更开放的中间层。开源大模型时代,大家希望代码能跨硬件跑,所以开放生态越来越重要。
Day 0 适配意味着什么?以前国产芯片要等模型发布几个月后才能适配。现在 DeepSeek V4 首发就同步开放给国产芯片,国产算力不再是“备胎”,而是“首发队员”。
09 结论:未来 1 到 2 年,看什么?
报告给出明确判断:
• 算力供需结构持续重构,推理算力成为主战场。 • 异构算力融合加速,跨厂商混训混推从实验走向生产。 • 开源软件栈成为关键变量,CUDA 护城河被逐步撬动。 • 国产算力进入规模化应用阶段,Day 0 适配开启新篇章。 • 标准化成为产业协同的关键,谁把握标准,谁占据主动。
报告建议联盟下一步:
1. 组建“开源大模型与先进计算”专项标准化工作组。 2. 优先启动适配评测、推理性能基准等紧迫标准。 3. 加强国际标准协同,避免技术孤岛。 4. 推动“标准+开源”双轮驱动。 5. 建立标准评测与认证体系。 6. 持续跟踪产业前沿动态。
最后一句
开源大模型时代,先进计算的竞争,已经不只是芯片性能的竞争,而是系统能力、软件生态、标准话语权的全面竞争。
DeepSeek V4 只是一个开始。
接下来,会有更多“V5”“V6”出现。产业迭代只会越来越快。谁能把算法、系统、硬件、生态、标准协同起来,谁就能在下一轮 AI 算力大变局中占据主动。
先进计算产业发展联盟(ACIA) 将持续推进相关标准化工作与产业协同。开源大模型与先进计算的新纪元,才刚刚开始。
☟☟☟
☞人工智能产业链联盟筹备组征集公告☜
☝
篇幅有限,部分展示 加入会员,任意下载 资料下载方式
Download method of report materials
关注公众号后回复:KY260922 即可领取完整版资料 
荐: 【中国风动漫】《姜子牙》刷屏背后,藏着中国动画100年内幕! 【中国风动漫】除了《哪吒》,这些良心国产动画也应该被更多人知道!
【中国风动漫】《雾山五行》大火,却很少人知道它的前身《岁城璃心》一个拿着十米大刀的男主夭折!

如需获取更多报告
报告部分截图
编辑:Zero

文末福利
1.赠送800G人工智能资源。
获取方式:关注本公众号,回复“人工智能”。
2.「超级公开课NVIDIA专场」免费下载
获取方式:关注本公众号,回复“公开课”。
3.免费微信交流群:
人工智能行业研究报告分享群、
人工智能知识分享群、
智能机器人交流论坛、
人工智能厂家交流群、
AI产业链服务交流群、
STEAM创客教育交流群、
人工智能技术论坛、
人工智能未来发展论坛、
AI企业家交流俱乐部
雄安企业家交流俱乐部
细分领域交流群:
【智能家居系统论坛】【智慧城市系统论坛】【智能医疗养老论坛】【自动驾驶产业论坛】【智慧金融交流论坛】【智慧农业交流论坛】【无人飞行器产业论坛】【人工智能大数据论坛】【人工智能※区块链论坛】【人工智能&物联网论坛】【青少年教育机器人论坛】【人工智能智能制造论坛】【AI/AR/VR/MR畅享畅聊】【机械自动化交流论坛】【工业互联网交流论坛】
入群方式:关注本公众号,回复“入群”
戳“阅读原文”下载报告。


发表评论
发表评论: