
 研报速递
一、引言
当人工智能从对话式交互的初级阶段全面迈向自主执行的执行式 AI 新纪元,推理环节的 Token 需求随范式跃迁呈指数级暴涨,算力需求规模已逼近现有供给体系的极限。全球算力竞争的底层逻辑,正从单点算力堆砌转向覆盖能源网络、下游应用的体系化产业链基建突破,以光电通信为代表的颠覆式技术开始主导新的竞争赛道。
2025 年,英伟达以算力垄断维系技术霸权的产业逻辑已得到充分验证;步入 2026 年,面对超出自身服务能力的市场需求,英伟达正以系统性布局避免份额稀释 —— 硬件端搭建异构平台、锁定稀缺产能与光电核心技术,同时向能源、电力、6G 通信等产业链短板环节延伸;软件端则在巩固生态优势的同时,重点卡位智能体、汽车、机器人、量子、生物医药等关键应用领域。与此同时,中美算力对垒已从芯片禁运升级为生态替代的深层博弈:国产大模型实现全栈国产化适配,打破美国全栈封锁;美国放开特定芯片看似解绑,实则是全球 AI 版图攻守易位的开端,中国 AI 产业正处在从跟跑替代向主权突围的关键阶段。
在十五五战略规划的开局之年,国产 AI 产业加速突围却仍面临生态锁定与规则霸权双重压力。拆解英伟达从异构硬件到全栈生态、从算力基建到应用卡位的战略布局,对中国在关键技术领域实现自主可控、推动人工智能产业长足进步,具有紧迫的现实意义。本文基于鼎帷咨询发布的报告,全景式拆解英伟达在新周期的战略脉络,清晰呈现其从单一产品竞争向全产业链上下游关键环节延伸的完整路径,以期为中国 AI 产业找准破局方向、突破发展瓶颈提供参考。
二、英伟达 2026 年经营业绩与战略总览
(一)经营业绩再创新高,数据中心业务成绝对核心
2026 财年英伟达总营收达2159.38 亿美元,同比增长65%;净利润达1200.67 亿美元,同比增长65%,毛利率维持在71.1%的高位水平。其中数据中心业务全年营收达 1940 亿美元,同比增长 68%,占总营收比重超 90%,过去四年间该业务规模增长了约 19 倍,是驱动公司增长的绝对核心动力。超大规模云服务商仍是最大客户类别,占数据中心营收比例略高于 50%,同时客户群体已拓展至 AI 模型研发商、企业客户及主权国家,实现多元化布局。
进入 2026 自然年,增长势头持续延续,2026 财年第四季度单季营收达 681.27 亿美元,同比增长 73%,环比增长 20%;单季净利润达 429.6 亿美元,同比增长 94%,环比增长 35%,毛利率提升至 75%。公司对下一财季的营收指引为 780 亿美元左右,增长动力仍主要来自数据中心业务。管理层明确表示,Blackwell 与 Rubin 产品组合在 2025 至 2026 年间将带来 5000 亿美元营收规模,先进 AI 芯片至 2027 年的潜在商机可达 1 万亿美元。
(二)核心战略:一体布局、多线卡位的全链条壁垒构建
2026 年英伟达的战略核心已从单纯的算力性能迭代转向全产业链体系化竞争,以一体布局、多线卡位为核心逻辑,构建覆盖底层技术到终端场景的全链条竞争壁垒。在供给端,通过异构算力架构拆分工作负载,匹配训练与推理的差异化需求,同时锁定先进制程、封装与光电核心技术的稀缺产能,缓解供给瓶颈;在产业链上游,主动向能源、电力、光电通信等算力基建短板环节延伸,解决算力规模化扩张的底层约束;在下游应用端,依托软件生态优势,在智能体、生物医药、汽车、机器人等高价值赛道完成提前卡位,将算力优势转化为场景壁垒。
整体战略的底层逻辑,是应对全球算力需求爆发下的份额稀释风险,通过向产业链上下游延伸,将单一芯片的竞争转化为体系化的生态竞争,持续巩固自身在全球 AI 产业中的核心枢纽地位。
三、硬件端:异构算力平台搭建与核心技术锁定
(一)Vera Rubin 全栈异构平台:重构 AI 计算底层逻辑
针对 AI 从训练主导向推理主导的范式转变,英伟达推出 Vera Rubin 整柜级算力平台,搭载七款全新芯片并实现全面投产,是首个采用极致协同设计的全栈 AI 平台,目标是将生成 Token 的成本降低至上一代平台的约十分之一。
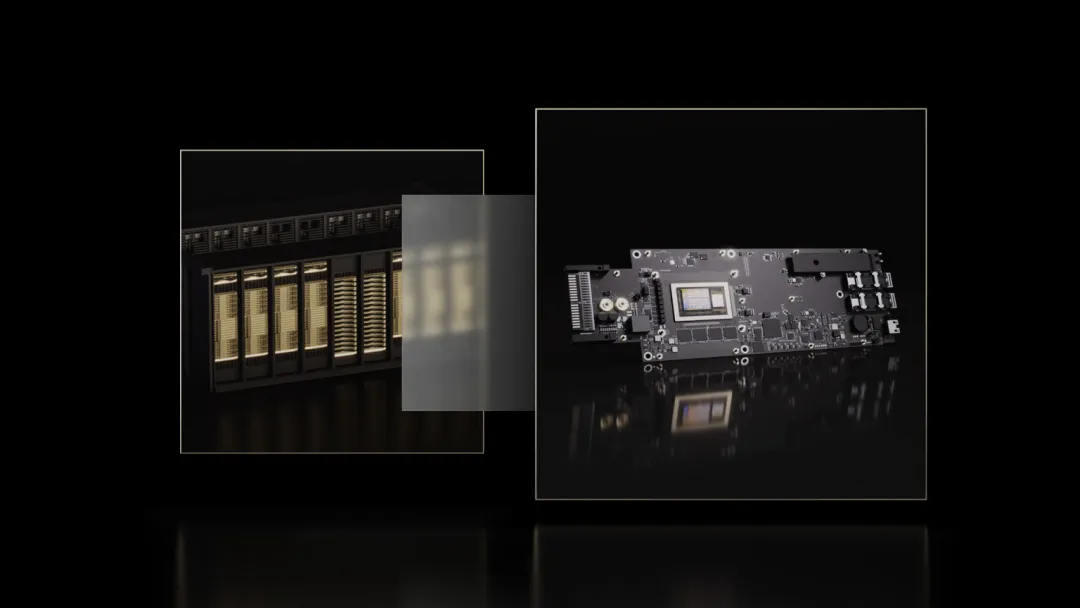
该平台打破了单一通用 GPU 应对所有工作负载的传统模式,构建 CPU+GPU+LPU 全栈协同算力体系,对推理任务进行精细化分工:Rubin GPU 负责预填充与注意力解码环节,匹配访存密集型任务特性;Groq 3 LPU 主打超低延迟推理能力,负责解码中的前馈网络与混合专家模块计算,弥补传统 GPU 在 AI 智能体交互任务中的适配缺陷,配套 Groq 3 LPX 加速器机架可实现高吞吐、低时延的规模化推理;Vera CPU 搭载自研 Olympus 定制核心,在核心规模、算力、内存带宽及容量等关键指标上较前代 Grace CPU 实现全方位升级,承担通用调度与预处理任务。同时平台整合 BlueField-4 DPU、Spectrum-6 以太网交换机、NVLink 6 交换机等配套芯片,构成完整的 AI 超级计算机系统,可覆盖从大规模预训练、后训练到实时智能体式推理的全 AI 阶段需求。
为支撑大规模算力集群的互联需求,英伟达实现了共封装光学 CPO 技术的量产落地,推出 Spectrum-X 以太网硅光交换机,这是全球首款进入量产的 200G/lane CPO 以太网交换机系统。该方案将功耗降至传统方案的 1/5,信号完整性提升 64 倍,平均故障间隔时间延长 10 倍,通过光铜混合扩展方案支撑算力集群的规模化扩容,打破数据中心内部的通信带宽瓶颈。此外,平台采用 100% 全液冷散热架构,大幅提升散热效率与整机柜交付效率,适配吉瓦级算力集群的部署需求。
(二)产能与上游核心技术锁定
为缓解供给瓶颈、掌握产业链主动权,英伟达持续向上游核心环节延伸,锁定稀缺产能与关键技术。在芯片制造环节,英伟达深度绑定台积电先进制程,Rubin 系列芯片采用台积电 3nm 工艺量产,同时提前锁定下一代先进制程的产能配额;在先进封装环节,持续扩大 CoWoS 封装产能的合作规模,保障高端 GPU 的交付能力。
在光电核心技术领域,英伟达投入 40 亿美元与 Lumentum、Coherent 两家企业达成深度合作,支持磷化铟激光器与硅光子技术的研发、产能扩张与美国本土制造布局,从源头掌握 AI 算力集群的高速互联核心元器件,保障下一代硅光子技术的供给稳定性。此前英伟达还通过技术许可与团队吸纳的方式,获得 Groq 的 LPU 核心知识产权与核心工程团队,补齐自身在低延迟推理芯片领域的技术短板,完善异构算力的技术拼图。
(三)端侧算力产品线完善
在数据中心之外,英伟达持续完善端侧 AI 芯片布局,推出面向 PC 终端的 RTX Spark SoC 芯片,联合联发科协同研发,采用台积电 3nm 工艺,集成 700 亿晶体管,采用 CPU+GPU 一体化 SoC 设计,搭载 Blackwell 架构 GPU 与 20 核 Grace CPU,通过 NVLink-C2C 高速互联实现算力高效互通,补齐端侧 AI 算力的产品矩阵。
四、产业链纵向延伸:向能源、通信等基建短板环节渗透
(一)能源电力:构建算力配套的专属能源底座
随着算力规模持续扩大,电力供给正在成为制约产业发展的核心瓶颈,算力的尽头是电力已成为产业共识。英伟达主动向能源领域延伸,破解吉瓦级 AI 工厂的电力约束。
英伟达推出 Omniverse DSX 平台,这是用于设计和运营吉瓦级 AI 工厂的全面开放蓝图,覆盖 AI 工厂从规划、建设到运营的全流程,整合算力部署、散热系统、电力配套等多维度方案。同时英伟达与斗山集团达成深度合作,斗山重工依托旗下燃气轮机、蒸汽轮机、小型模块化反应堆以及成熟的氢燃料电池系统,为英伟达全球 AI 工厂、DSX AI 工厂平台搭建专属电力基础设施。这一合作标志着英伟达标杆级 AI 工厂彻底告别单一依赖公共电网的传统模式,正式迈入市电加氢能分布式发电的多元混合供电新时代,为超大算力集群筑牢能源底座。
(二)6G 与通信:AI 原生网络重构通信产业
英伟达将算力优势延伸至通信领域,推动通信网络向 AI 原生架构转型,布局 6G 时代的产业话语权。英伟达投入 10 亿美元与诺基亚达成战略合作,共同开发 AI 原生的 5G-Advanced 与 6G 网络,推出 NVIDIA Arc Aerial RAN Computer 这一 6G 就绪的电信计算平台,诺基亚将基于英伟达平台推出全新 AI-RAN 产品,T-Mobile 等运营商已加入联合研发进程。
英伟达发布完整的 AI-RAN 技术堆栈,通过软件定义架构与嵌入式智能,让无线网络可通过软件迭代持续优化性能,将通用算力注入基站设备,使基站从单纯的信号处理节点转变为边缘算力节点。同时英伟达已启动国内端侧算力组网布局,敲定国内合作伙伴推进 AI-RAN 基站试点,目标是将全城基站串联为边缘算力网络,把云端 AI 算力下沉至终端侧,支撑端侧 AI 应用的低时延需求。配合 Spectrum-X 硅光交换机的量产落地,英伟达已构建起从数据中心内部光互联、到骨干网络再到边缘基站的全层级通信算力布局。
五、软件生态与下游应用卡位:巩固生态壁垒,抢占高价值场景
(一)CUDA 生态持续深化,NIM 微服务降低部署门槛
CUDA 生态仍是英伟达最核心的护城河,英伟达持续迭代 CUDA-X 工具库,覆盖 AI、高性能计算、数据处理、优化调度等多个领域,将 cuDF、cuOpt、AI-Q 等专业库封装为领域专属技能,开放给 AI 智能体调用,持续扩大生态的覆盖边界。
同时英伟达推出 NIM 微服务架构,将模型推理、领域工具封装为标准化微服务,大幅降低企业部署 AI 应用的门槛,实现开箱即用的算力调度与模型调用能力,推动 AI 算力向千行百业渗透。NIM 微服务已覆盖大语言模型、生物医药、科学计算等多个领域,成为英伟达连接算力供给与下游应用的核心中间层。
(二)智能体 AI 全栈布局,抢占下一代 AI 入口
随着执行式 AI 成为产业共识,英伟达全面布局智能体技术栈,从基础模型到开发工具再到运行时环境形成完整体系。模型层面推出 Nemotron 3 全模态理解模型,以及更轻量、更快速的 Nemotron 3 Ultra 版本,后者处理复杂智能体任务时推理速度提升 5 倍,成本最多降低 30%,专为长时间运行的智能体场景优化。
工具层面推出 NemoClaw、OpenClaw 等智能体开发工具,支持企业快速构建专用 AI 智能体;推出 OpenShell 安全运行时环境,与微软、红帽等企业合作,实现智能体在 Windows、Linux 等系统中的安全部署。目前 Cadence、达索系统、西门子等工业软件企业已使用该工具构建自主 AI 工程师,将原本数周的工程仿真与验证工作压缩为数小时;CrowdStrike、Palantir 等企业利用智能体推动网络安全与运营决策转型,智能体已在工业、安防、办公等场景实现规模化落地。
(三)垂直领域深度卡位,释放算力场景价值
1. 生物医药
英伟达推出 BioNeMo Agent Toolkit,为生命科学领域的 AI 智能体提供专业工具与技能,全面覆盖生物学、化学、基因组学及药物研发等领域。该工具包汇集英伟达十多年积累的生命科学库、工具和开放模型,使 AI 智能体能够完成证据收集、跨研究推理、计算实验执行与后续步骤推荐等工作,将原本数月的研发周期缩短至数天。目前达索系统、礼来、华盛顿大学医学院蛋白质设计研究所等机构已采用该工具包,Anthropic 和 OpenAI 也在集成相关能力,Proteina-Complexa 模型可加速蛋白质复合物研发,配套开放数据集包含数百万条 AI 预测的蛋白质复合物结构数据。
2. 汽车与机器人
汽车领域推出 Alpamayo 开放推理模型系列,用于辅助驾驶与自动驾驶开发,将 AI 能力注入汽车产业。机器人领域发布 Isaac GR00T 机器人基础模型,以及 Cosmos3Edge 端侧世界模型,后者为 40 亿参数规模,专为 Jetson Thor 等边缘硬件优化,可支撑机器人的实时推理与动作规划,实现物理世界的感知与决策。英伟达与斗山机器人合作,整合仿真平台、大模型与算力模组,迭代智能体机器人操作系统,重点研发双臂协作机器人与人形机器人产品。
3. 量子计算
英伟达推出 NVQLink 开放式系统架构,可将 GPU 计算与量子处理器紧密结合,实现经典算力与量子算力的高效协同,该架构已被全球十余家超级计算中心采用。同时推出 CUDA-Q 量子计算编程平台,降低量子计算应用的开发门槛,提前布局量子计算时代的生态话语权。
六、中美算力博弈:从芯片禁运到生态替代的深层对垒
(一)英伟达中国市场的策略调整与份额变化
受出口管制政策影响,英伟达中国区数据中心业务营收已未纳入业绩指引,高端芯片对华出口持续受限。尽管 H200 芯片获得形式上的出口许可,但关税、总量限制、安全审查等多重约束,叠加国产算力的快速替代,使得该产品在中国市场的商业吸引力大幅下降,实际出货规模有限。
2025 年中国 AI 加速卡市场总出货量达 400 万张,其中英伟达出货约 220 万张,占比 55%,仍占据市场首位,但份额已呈逐步收窄趋势。英伟达通过推出特供版芯片维持市场存在,但面对国产算力的快速追赶,其市场垄断地位已出现松动。
(二)国产算力全栈突围,生态替代加速
中国 AI 产业已从硬件替代进入全栈生态替代的新阶段,核心标志是大模型与国产算力底座的深度适配。DeepSeek V4 万亿参数旗舰模型实现 100% 运行在华为昇腾 950PR 芯片上,研发团队重写 200 + 核心算子,将模型底层架构从 CUDA 全面迁移至华为 CANN 框架,实现算子与操作系统的全栈国产化,成为全球首个脱离英伟达 CUDA 生态的顶级 AI 大模型,被业内称为飞行中更换引擎的技术突破。
华为昇腾已成为国产算力的核心力量,2025 年出货 81.2 万张 AI 加速卡,占国产总出货量的近一半,以 20% 的市场销售额份额位列中国厂商之首。2026 年 3 月华为发布昇腾 950PR 芯片,全年计划出货约 75 万颗,预计全年 AI 芯片收入将达 120 亿美元,较 2025 年的 75 亿美元增长 60% 以上。华为推出 Atlas 950 SuperPoD 集群系统,可将 8192 颗昇腾 950DT 处理器接入单一计算节点,实现 FP8 精度下 1EFLOPS 的算力规模,形成对标英伟达的整柜级算力交付能力。
整体来看,2025 年国产 AI 加速卡出货量已达 165 万张,占国内市场比例达 41%,形成以华为昇腾为龙头,阿里巴巴平头哥、寒武纪、百度昆仑芯、海光信息等企业梯队化发展的竞争格局。国产算力已完成从可用到好用的关键跨越,在推理场景率先实现规模化替代。
(三)全球 AI 市场二元化趋势显现
中美算力博弈已进入生态竞争的深层阶段,全球 AI 市场逐步呈现二元化发展趋势:英伟达加美国前沿模型体系主导除中国外的全球市场,华为加中国开源权重模型体系主导中国市场,并开始向海外市场拓展。英伟达失去的不仅是中国市场份额,更面临国产算力体系成熟后向第三方市场渗透的长期结构性风险;而中国 AI 产业在政策与市场双重驱动下,正加速构建自主可控的全栈产业体系,从跟跑替代迈向主权突围的新阶段。
七、产业启示与未来展望
英伟达 2026 年的战略布局,揭示了全球 AI 产业竞争的核心演变方向:算力竞争已超越单一芯片性能维度,进入全产业链体系化竞争的新阶段。对中国 AI 产业而言,可从中获得多重启示。
第一,坚持全栈自主与生态建设并重。硬件性能追赶是基础,但软件生态与开发者体系才是长期壁垒。应依托国内大模型与应用市场优势,持续完善国产编程框架与工具链,扩大开发者生态,从硬件可用走向生态繁荣。
第二,向上游核心环节延伸布局。光电、先进封装、能源配套等是算力规模化扩张的共性瓶颈,应提前布局核心技术与产能,破解产业链卡脖子环节,构建自主可控的算力基建体系。
第三,强化垂直场景卡位,以应用拉动产业迭代。智能体、生物医药、机器人等是下一代 AI 的高价值场景,应结合国内产业优势,推动算力技术与垂直场景深度融合,以场景需求倒逼技术迭代,形成技术与应用相互促进的正向循环。
未来全球 AI 产业竞争将更趋激烈,体系化能力将成为核心竞争力。中国 AI 产业需把握执行式 AI 与推理时代的产业机遇,坚持自主创新与开放合作相结合,在全球算力格局重构中赢得战略主动。
— END —

发表评论
2026-09-20 17:19:59 回复该评论
发表评论: