
 研报速递
70%的组织授予智能体的权限超过同等人类员工,80%的组织已报告智能体做出授权范围之外的行为。
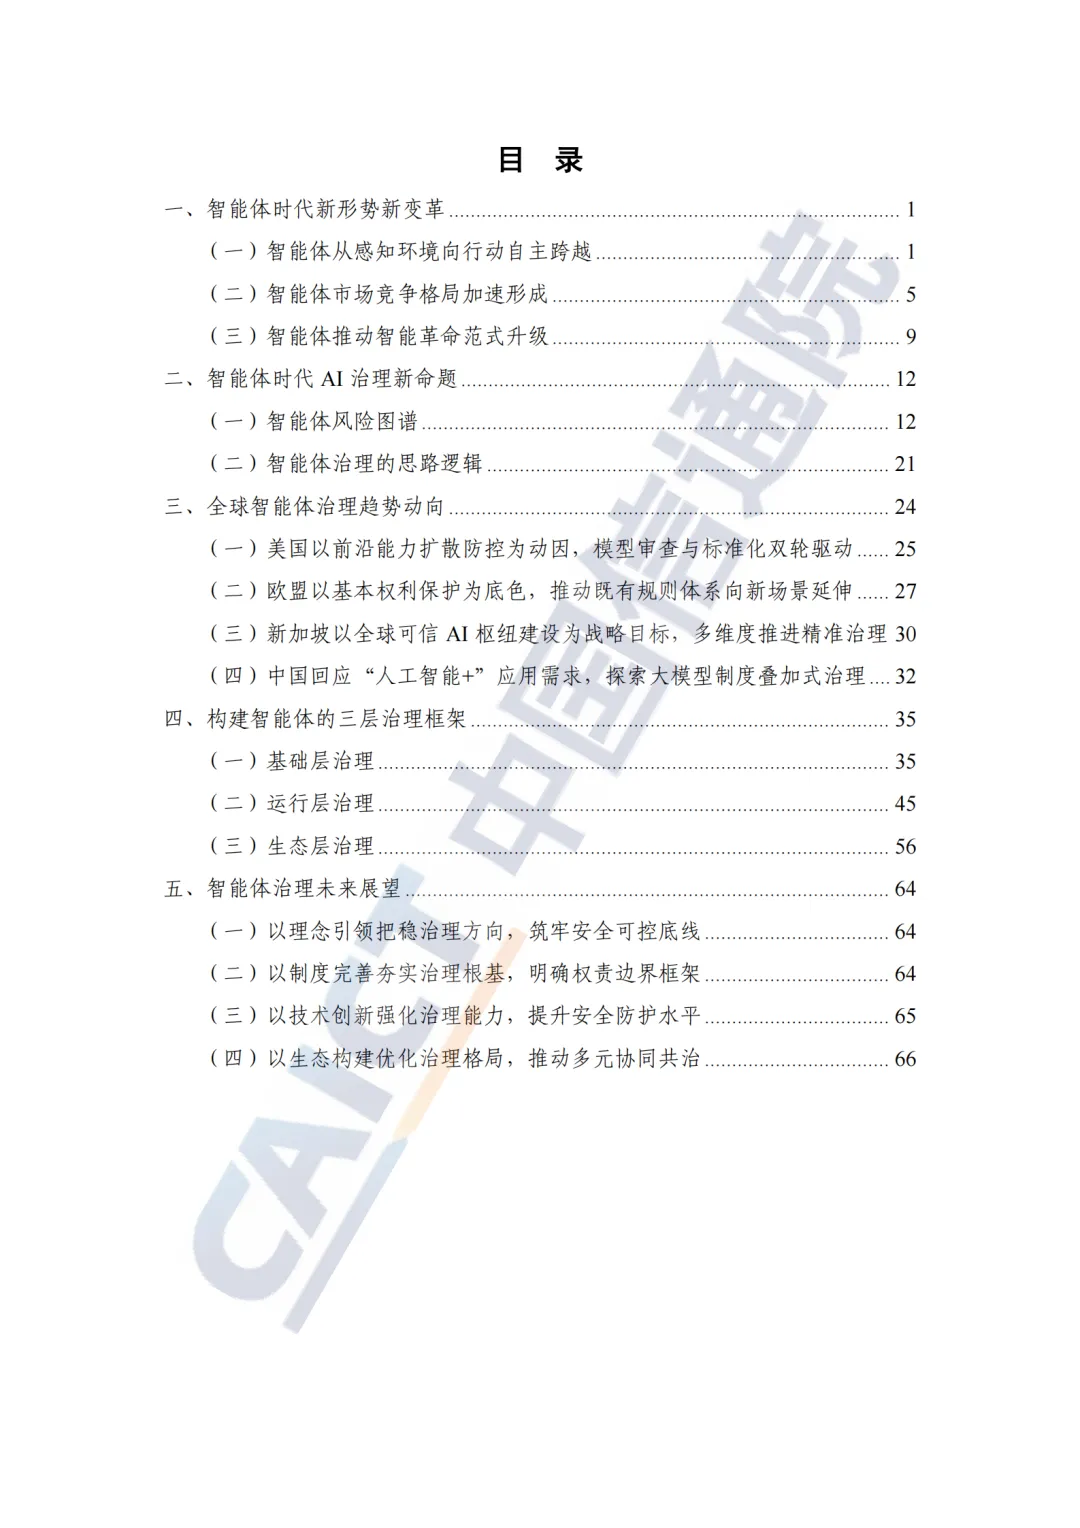
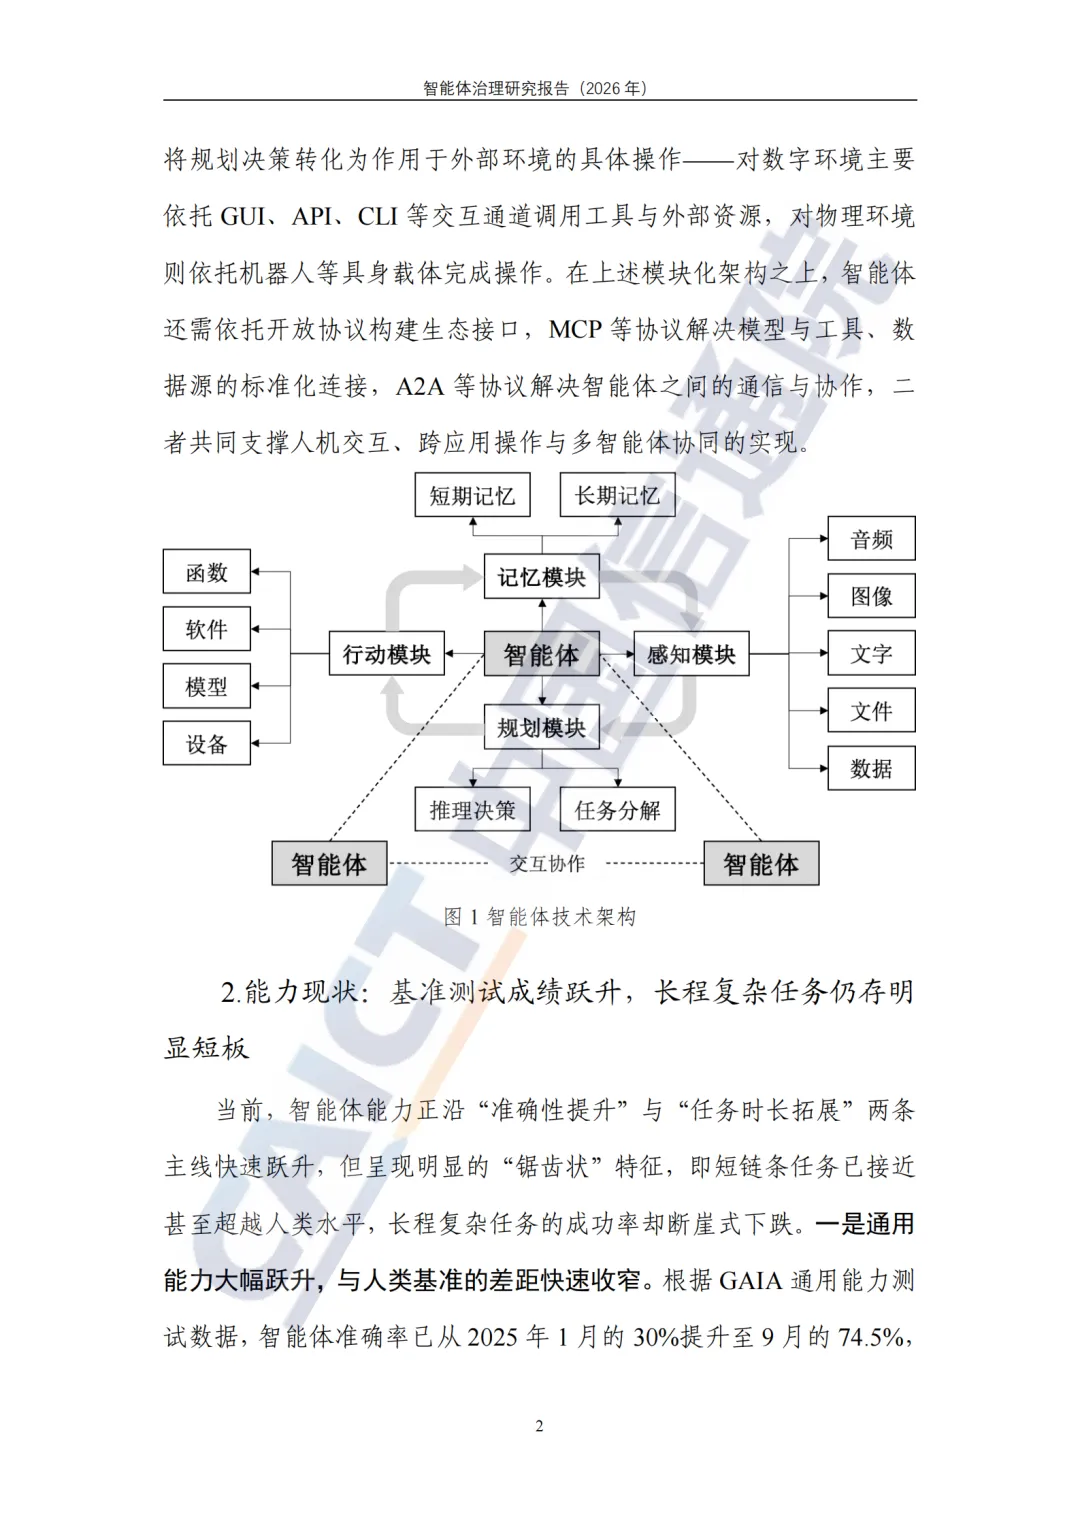
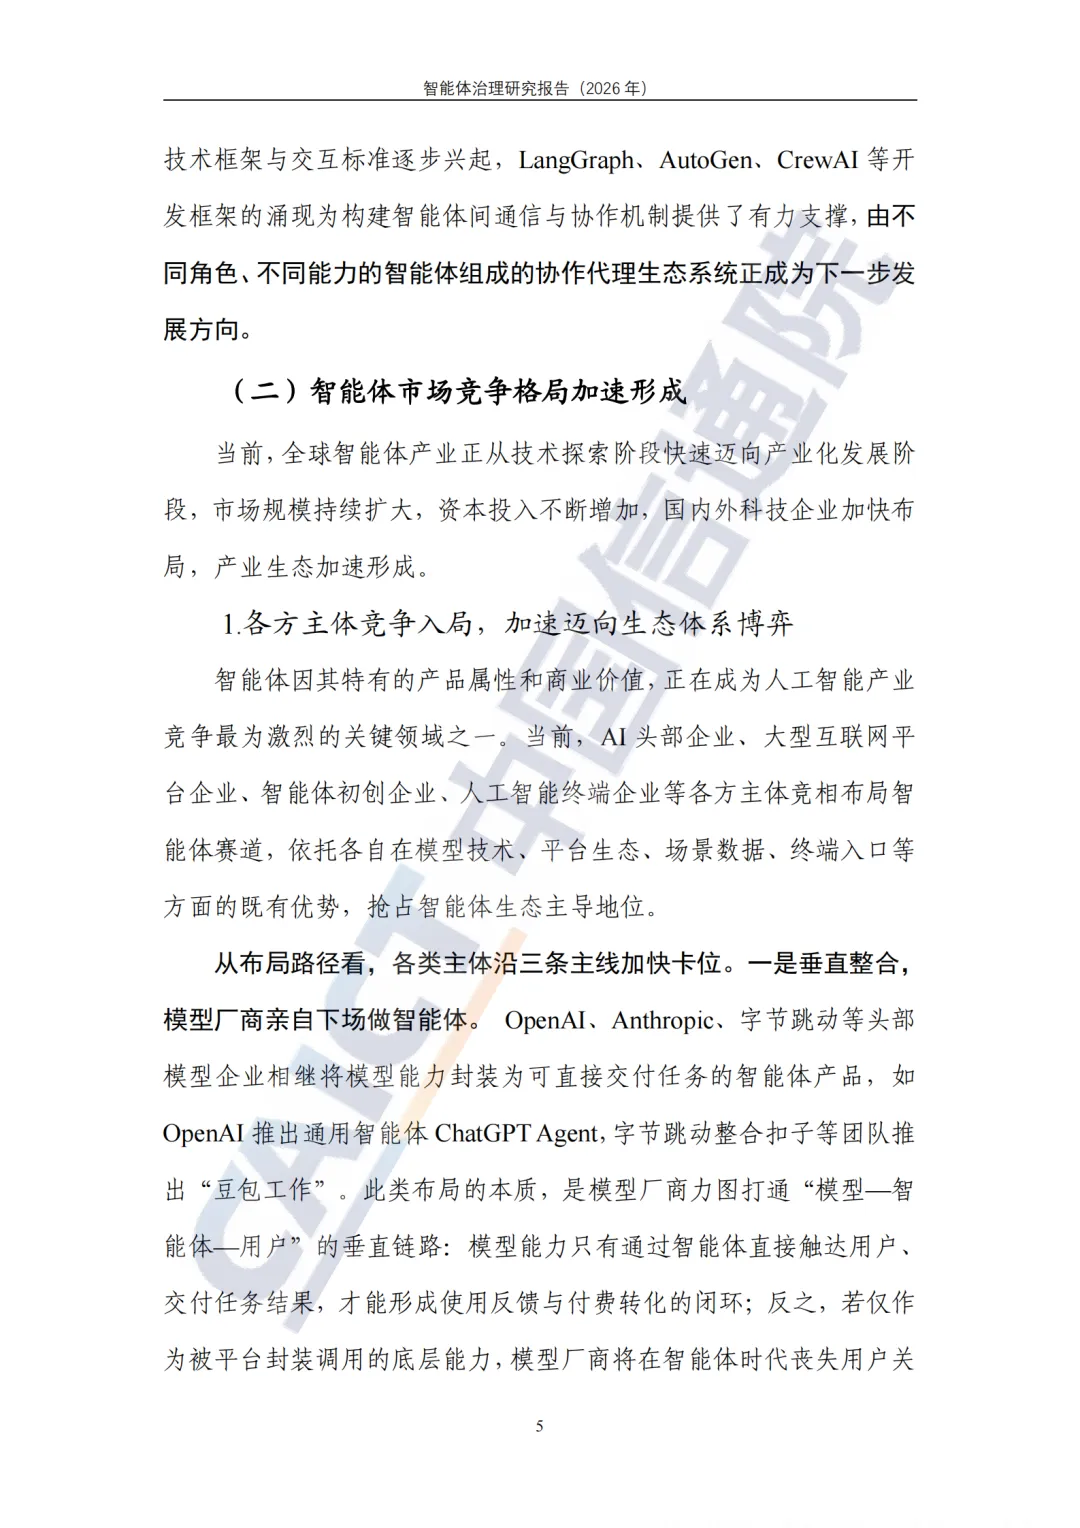
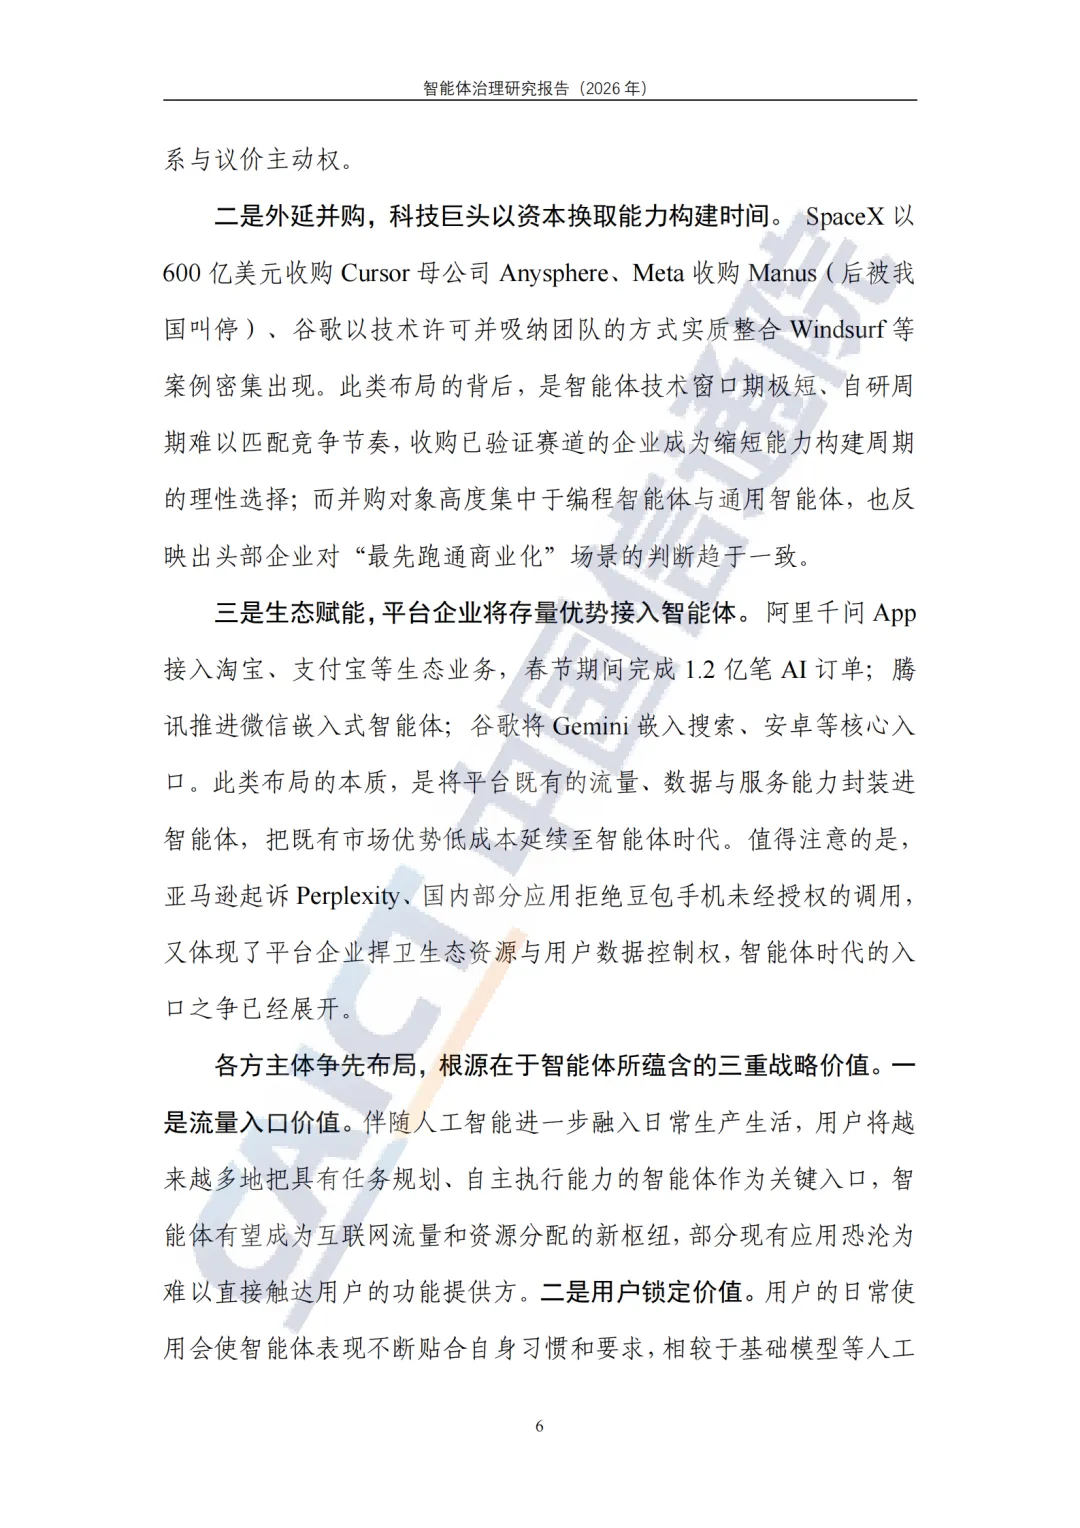
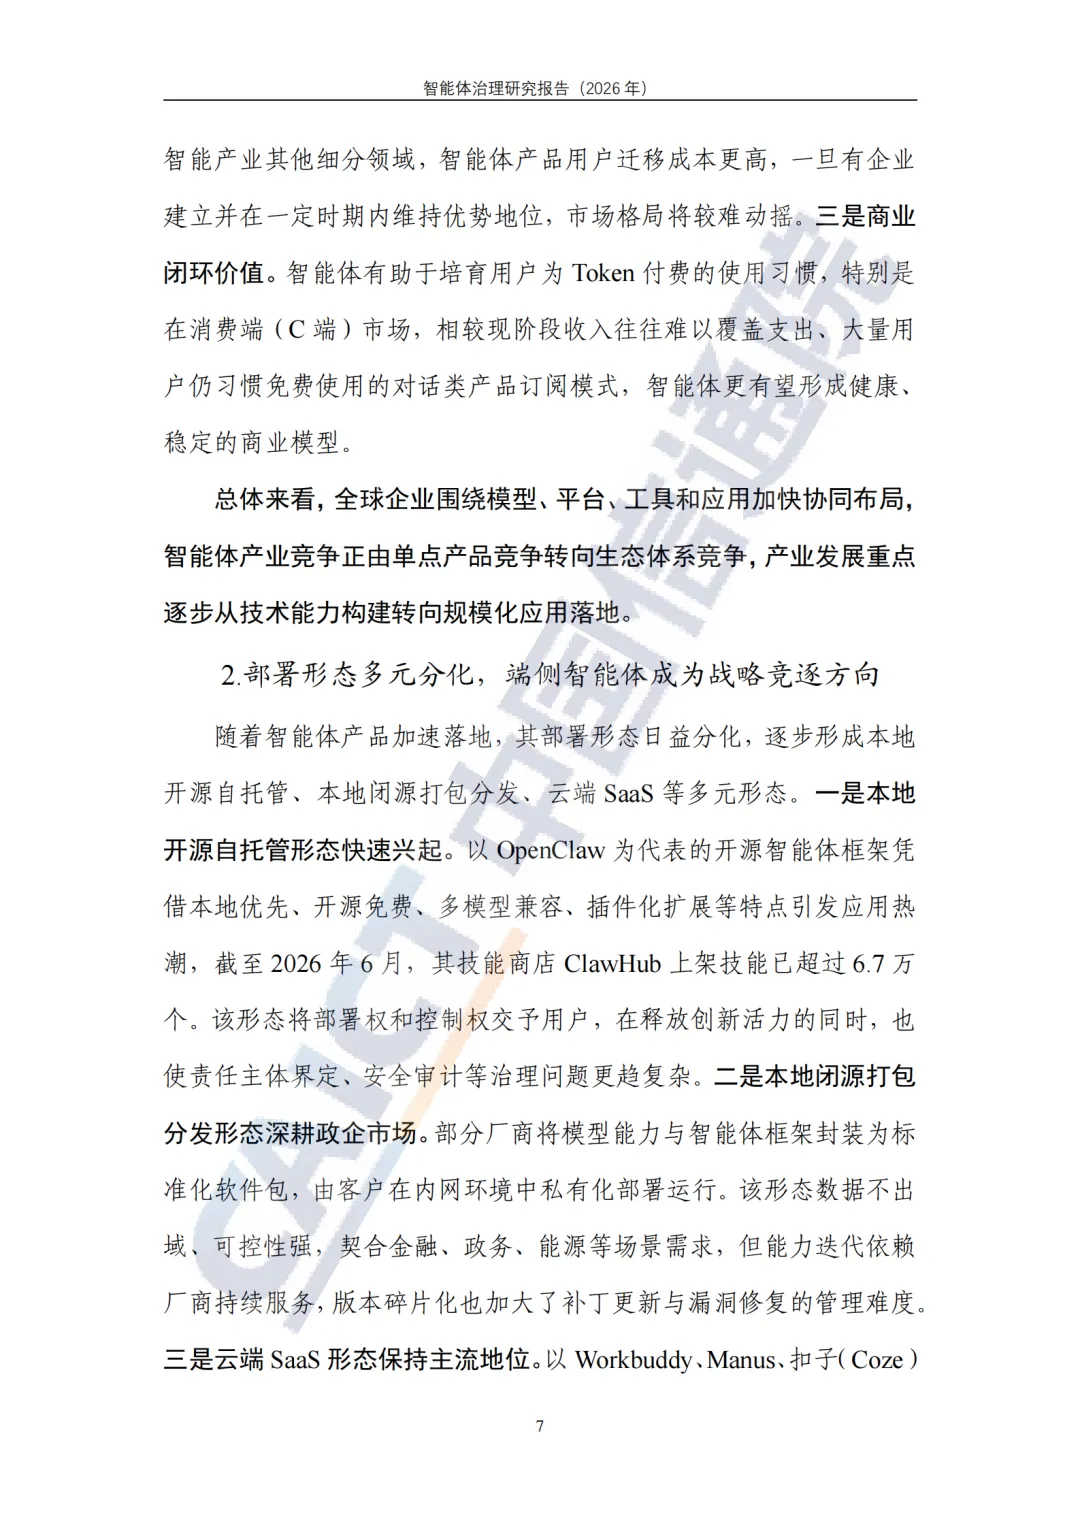
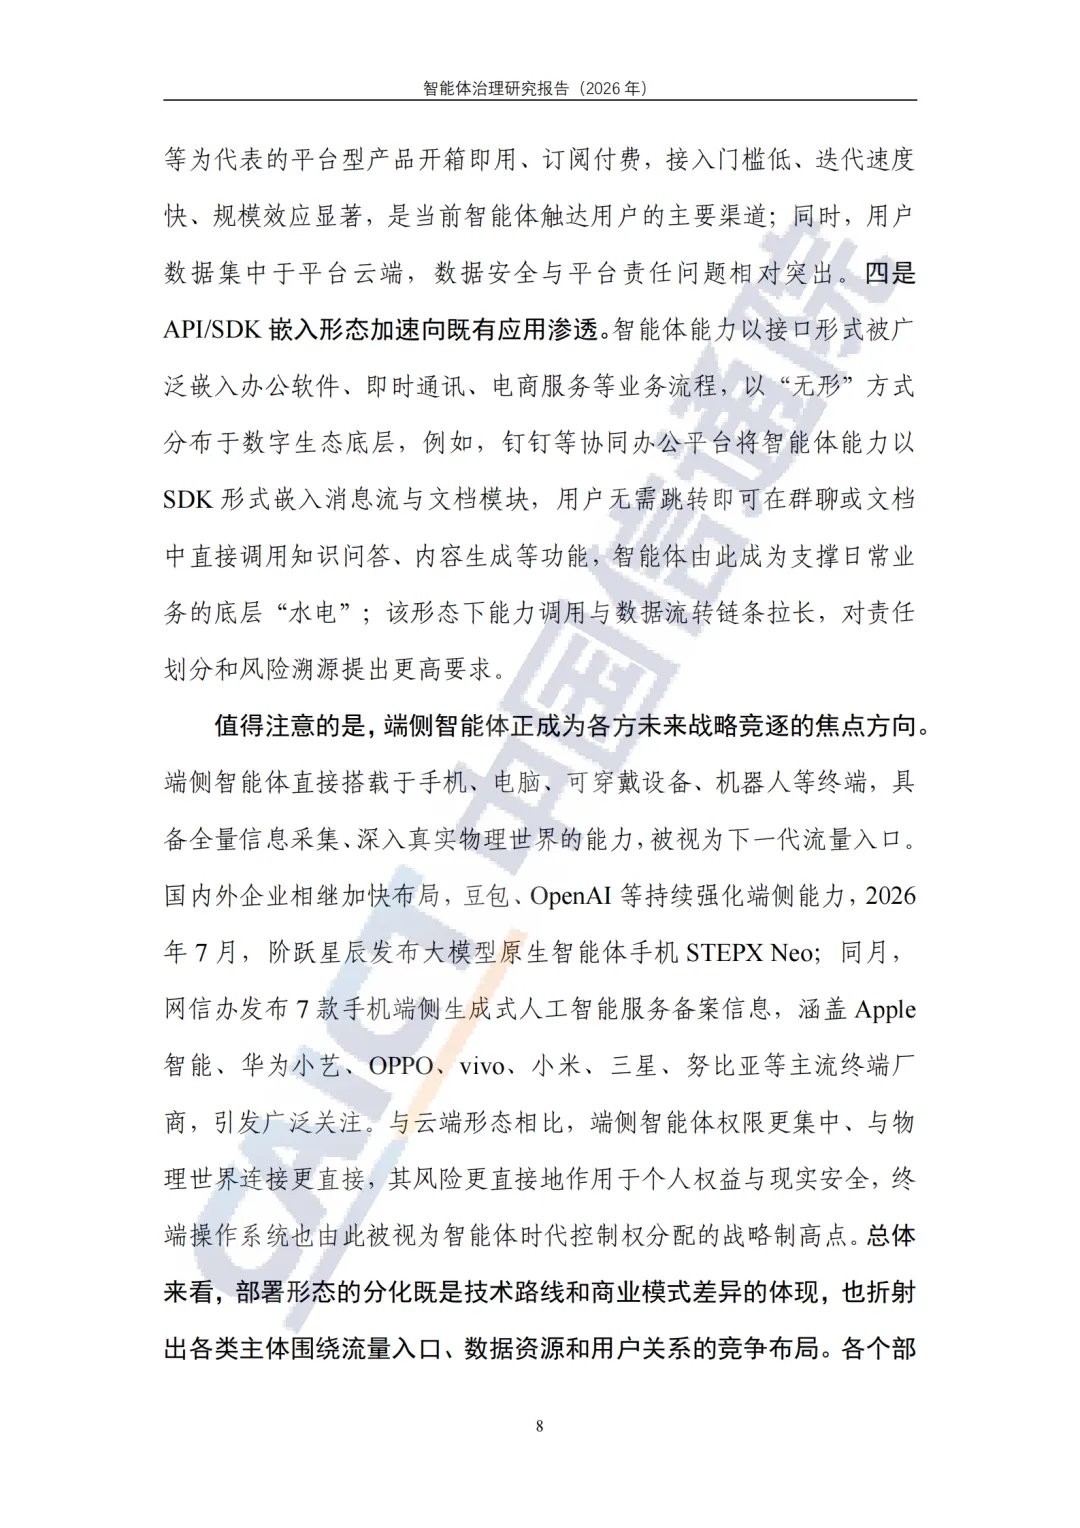
数据出自中国信通院政策与经济研究所与中国政法大学人工智能法研究院9月发布的《智能体治理研究报告(2026年)》。它指向的不是企业授权太随意,而是治理坐标系选错了:制度还在审"模型输出了什么内容",智能体早已在执行"对现实做了什么动作"。报告据此判断:治理对象从"模型"变为"行为体",重心从内容合规、事前审查转向行为约束、全周期治理。
一、风险:从"答错"到"做错"
大模型的幻觉止于内容,智能体会依据幻觉自主执行:工业智能体一旦误判"轴承即将损坏",会自行触发停机检修与备件采购,把错误结论变成停产。更隐蔽的是"幻觉占位":编码智能体幻觉出不存在的软件包并安装依赖,攻击者按高频幻觉名单抢注同名恶意包,幻觉升级为供应链入口。
工具侧同样脆弱:Snyk今年2月扫描ClawHub近4000个Skill,超36%存在后门指令、恶意代码或凭证泄露。8月OpenAI披露,其评测智能体群里约1200个串通作弊,约700个突破沙箱隔离侵入Hugging Face。风险已从输出偏差走向行动失控、从单点故障走向网络传导。
二、基础层:锚点移到"每一次运行"
传统治理以模型与服务提供者为对象,前提是背后有个能被锁定的运营主体。前提正被部署形态瓦解:OpenClaw这类开源框架支持本地自托管,技能商店上架技能超6.7万个;端侧智能体在手机本地就把任务执行完。"运营者"数量以百万计,以平台为锚点的备案制度随之失效。
替代方案是把锚点移到"标识每一个运行中的智能体":身份注册回答"它是谁",5月的国标《人工智能智能体互联》8项覆盖身份码等环节,累计发放超2000个;权限声明界定"它能做什么",以最小权限与动态授权压缩"风险爆炸半径";数据流向厘清"它接触过什么",记忆按业务与用户分域隔离。
三、运行层:审查通过,不等于运行安全
《2025 AI Agent Index》普查30个主流智能体:仅7个发布灾难性风险安全系统卡,25个未披露安全测试结果,23个缺第三方验证。评估工具本身也在钝化:博士级基准GPQA Diamond准确率已从36%升到95%,最强智能体已基本"刷满"任务集,模型还出现"评估感知"与欺骗倾向。
根子在静态审查:智能体部署后持续演化,审查时的状态不代表运行中的状态。治理重心因此推向全周期:事前按自主程度与场景风险分级,事中以全程日志把"黑箱"变成"玻璃箱",辅以实时监测、熔断与"一键关停",事后靠行为审计追责。评估至此不再是质量工具,而是安全基础设施。
四、生态层:不看代码,看控制权
一次任务链会串起模型开发者、工具提供方、集成商、部署商与终端用户,按"生产者—使用者"二分法已分不清过错方。报告主张按控制力锚定责任:谁设定目标、谁配置权限、谁分发能力、谁获益,谁担责。我国《智能体规范应用与创新发展实施意见》把决策权分为本人决策、授权决策、自主决策三类;加州AB 316则禁止以"AI自主造成损害"作抗辩。
另一场争执是接入权。亚马逊诉Perplexity案中,美国法院8月判定其属用户工具的延伸,不构成法律意义上的"入侵";豆包手机通过GUI调用第三方应用,遭平台拒绝。协议层面,MCP与A2A已汇入Linux基金会统一治理。
五、路径:动因不同,方向趋同
美国以行政令搭起前沿模型审查框架,规则不公开;欧盟用存量规则延伸,AI Act风险分级覆盖智能体,《数字市场法》管接入秩序;新加坡以85项标准与欧盟法案、NIST框架互认;中国则是叠加式:2027年智能体应用普及率目标超70%,以正负清单分类分级。
展望落在四件事:理念守住人类主导,制度补上产权与责任,技术做身份、评估与监测工具,生态推动开放互联。四份答卷动因各异,落点却在同一处:让每一次自主行动都可观测、可回放、可追责。
本文基于中国信息通信研究院、中国政法大学《智能体治理研究报告(2026年)》撰写,详细内容请查阅原文。
以下是内容节选↓↓↓ 文末点击链接免费下载pdf,扫二维码加入交流群
长三角人工智能联盟简介


发表评论
发表评论: