
 研报速递
券商谈 AI 策略交易,对外话术往往很顺:有数据、有算力、有量化团队,再加上大模型,好像离「智能交易」只差一层接口。
真正进过机构交易链路的人都清楚:演示能跑,和策略能进生产,中间隔着好几道门。门不在模型本身,而在数据能不能用、审批能不能过、仿真能不能信、人机怎么分工、以及出事时责任落在谁身上。
本文从机构落地视角,梳理几处最常见、也最容易被对外材料略过的卡点。不荐股、不谈具体标的,只谈把 AI 嵌进策略交易时,系统与组织会撞上什么。
一、数据不是「有」,而是「能合法地用」
很多方案默认:行情、委托、成交、持仓、客户画像都在库里,喂给模型就行。
机构里更真实的情况是:
权限按条线切碎。 研究、自营、资管、经纪、风控各有数据边界,跨条线聚合常常要单独立项。 用途要可追溯。 同样一段成交明细,用于报表和用于训练策略模型,合规口径往往不同。 特征工程比算法更耗时。 缺失值、复权、停牌、涨跌停、交易成本、滑点假设,任何一处偷懒,仿真会好看、实盘会打脸。
所以第一道卡点不是「有没有 GPU」,而是:这批数据,以这个用途,能不能进模型训练与推理链路,并且事后审计能说清楚。
二、模型上线不像发一个微服务
互联网产品习惯「灰度—观测—全量」。策略交易侧多了一层:模型输出会直接影响下单意图或风控阈值。
常见卡关包括:
模型变更等同业务变更。 换特征、换窗口、换目标函数,都可能触发策略评审,而不是研发发版。 可解释性要求不对称。 业务和风控要的是「为什么今天偏多/偏空或为什么提高阈值」,纯黑盒分数很难过会。 回撤与异常场景要先想清楚。 极端行情、数据延迟、行情源切换时,模型是降级、熔断,还是切回规则策略?没有预案,上线会停在评审会。
落地成熟的团队,通常会把「模型版本」当成和「策略版本」同等管理的对象:输入契约、输出契约、回测基线、监控指标、回滚路径,缺一不可。
三、仿真漂亮,不等于实盘可交易
这是 AI 策略里被低估最深的一环。仿真环境常见偏差有:
成交假设过于乐观(忽略排队、部分成交、拒单)。 成本模型偏薄(佣金、冲击成本、融券成本未完整计入)。 信息时点错位(用了实盘当时拿不到的字段,或对齐了未来函数)。 容量未压力测试(小资金曲线好看,放大后流动性不够)。
AI 模型还会放大这类偏差:它更擅长在历史分布里找规律,对制度变更、流动性结构变化、交易机制调整更敏感。因此机构真正在问的不是「回测夏普多少」,而是:仿真到实盘的衰减,能不能被解释、被监控、被及时停掉。
四、人机协同:AI 是建议、是半自动,还是准自动?
同一套模型,落到交易台可以有三种完全不同的产品形态:
辅助决策: 输出信号与理由,人确认后下单。 约束自动: 在限额、名单、时段内自动执行,越界即人工。 高自治: 人设目标与边界,系统在边界内连续决策。
卡点往往出在组织没先选形态。研发按「自动交易」做,风控按「投顾建议」审,前台按「工具」用——三方预期不一致,项目会反复返工。
更稳妥的路径,通常是先把 AI 放在「可解释的建议层」或「强约束的执行层」,把责任边界写进流程,再谈提高自治度。
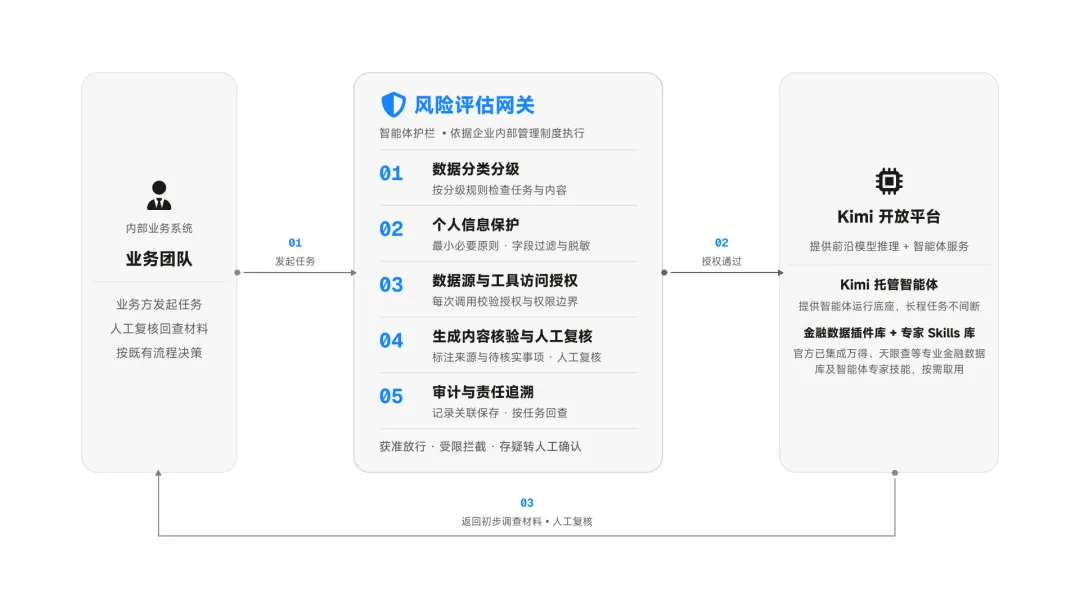
五、工程与风控要一起设计,而不是上线前补课
AI 策略交易落地,最后一定会碰到这些「很土但很硬」的问题:
推理时延是否满足交易窗口; 行情中断、下游拒单时的降级路径; 模型漂移与数据质量监控谁值守; 日志是否足以做事后追责与监管报送; 供应商模型、开源权重、自研模型的知识产权与安全边界。
这些不是模型论文附录,而是生产系统的默认配置。缺了它们,「AI 策略」只是实验室里的曲线。
写在后面
券商把 AI 用进策略交易,真正的分水岭不在演示效果,而在能否同时回答四句话:
数据用得合法吗?变更审得清楚吗?仿真信得过吗?出了问题停得住、说得清吗?
能把这四句答成可执行的制度与系统能力,AI 才从概念走进交易链路。答不清楚之前,模型再新,也只是挂在链路上的试验件。
发表评论
发表评论: