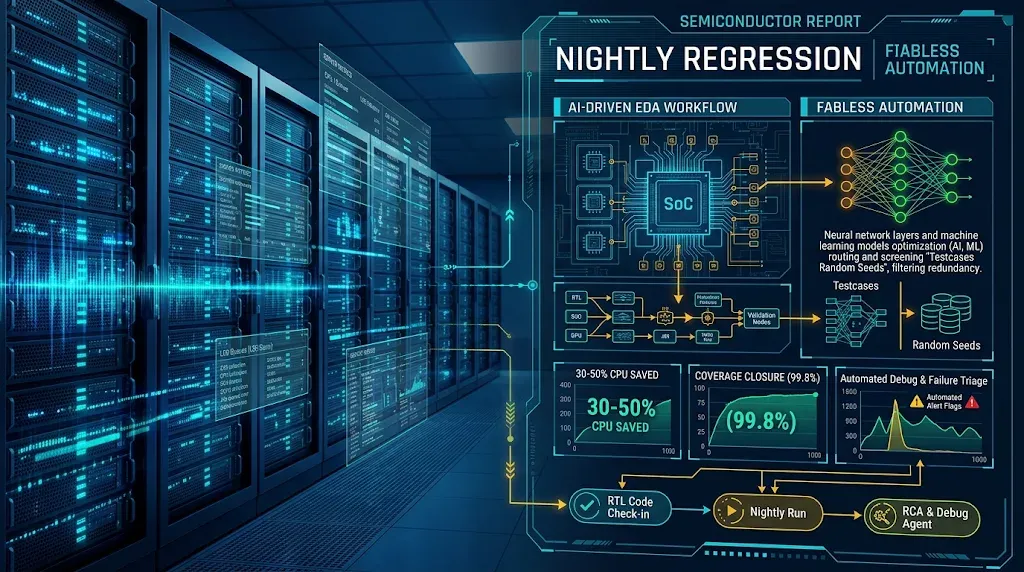
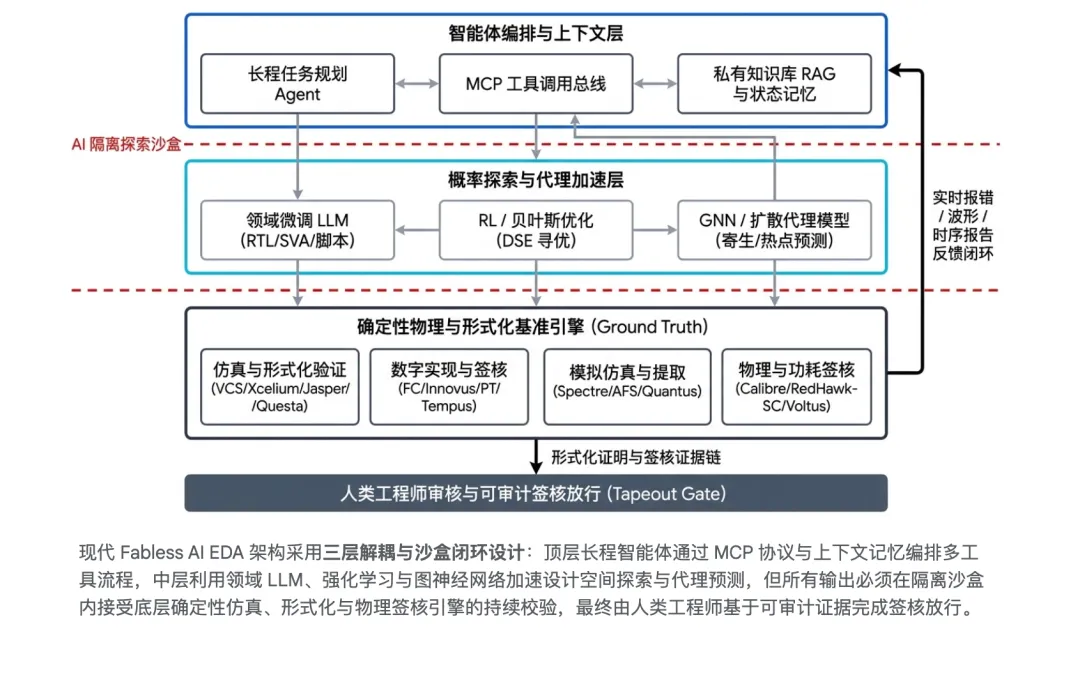
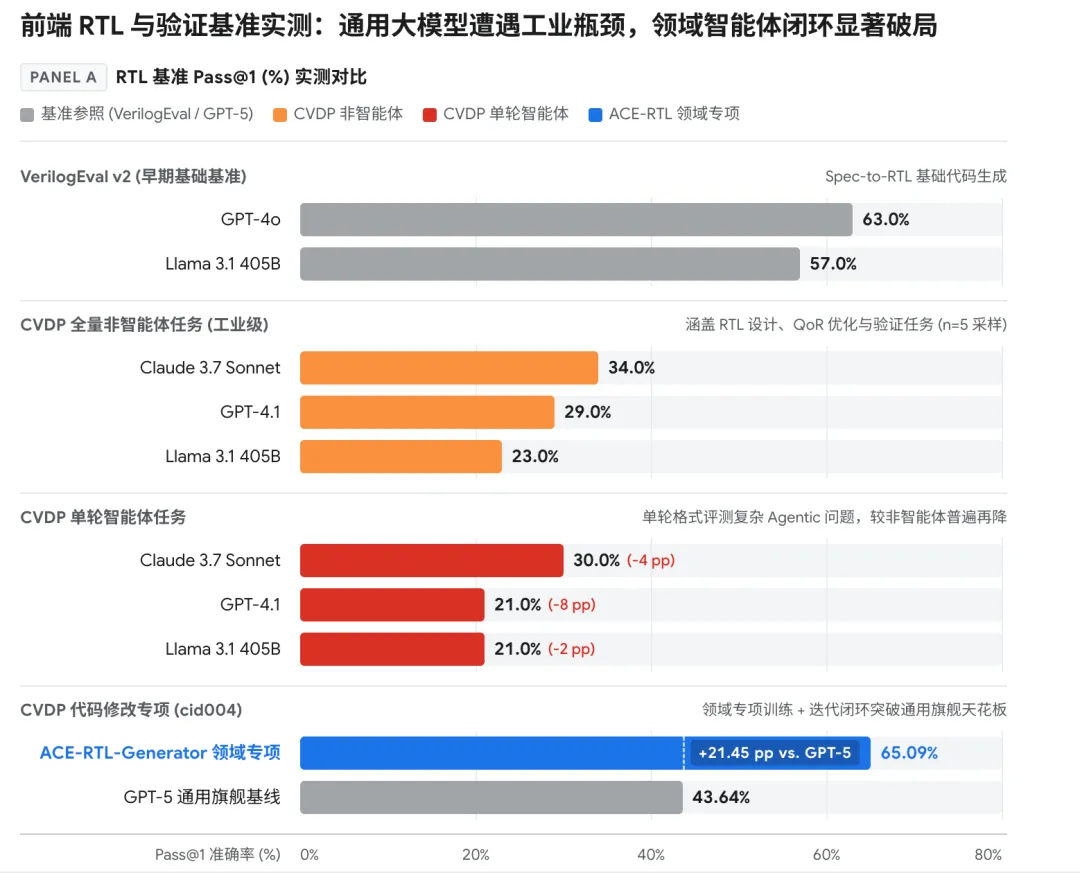
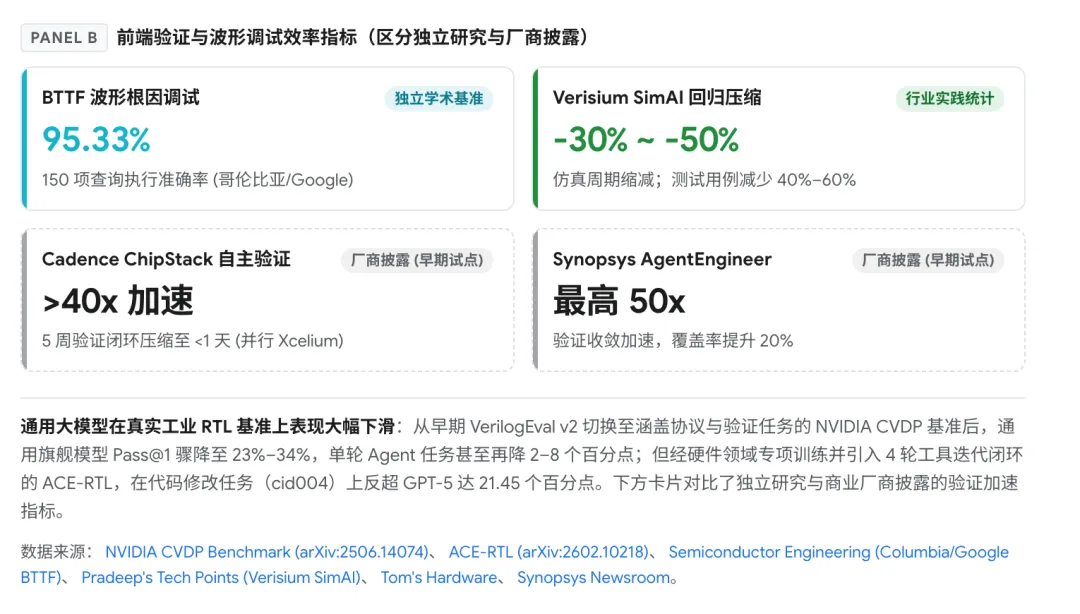
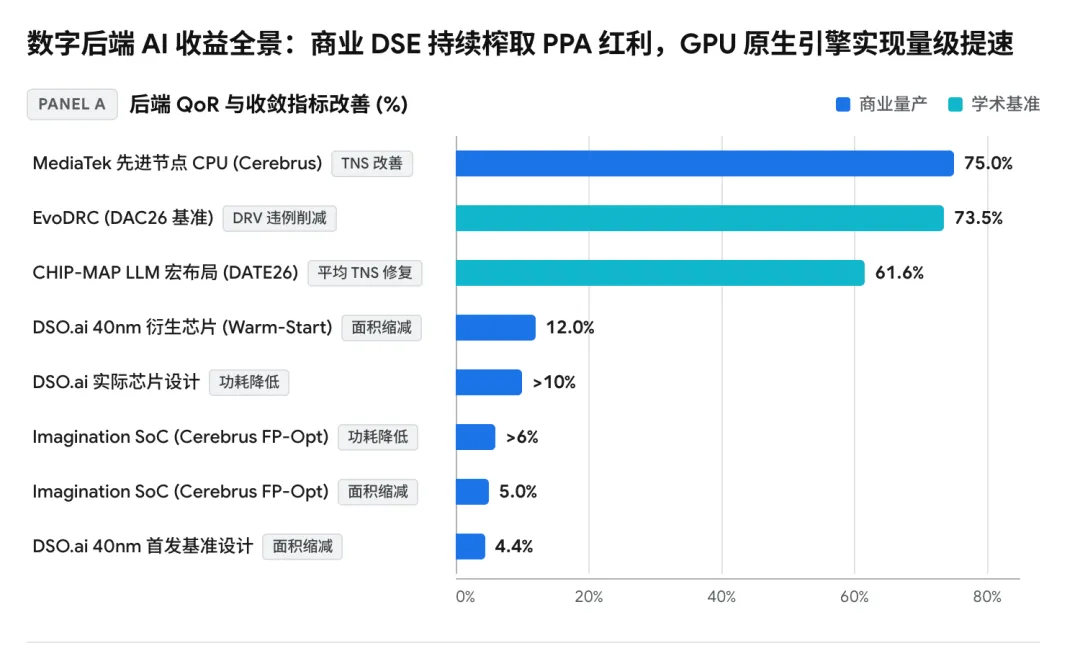
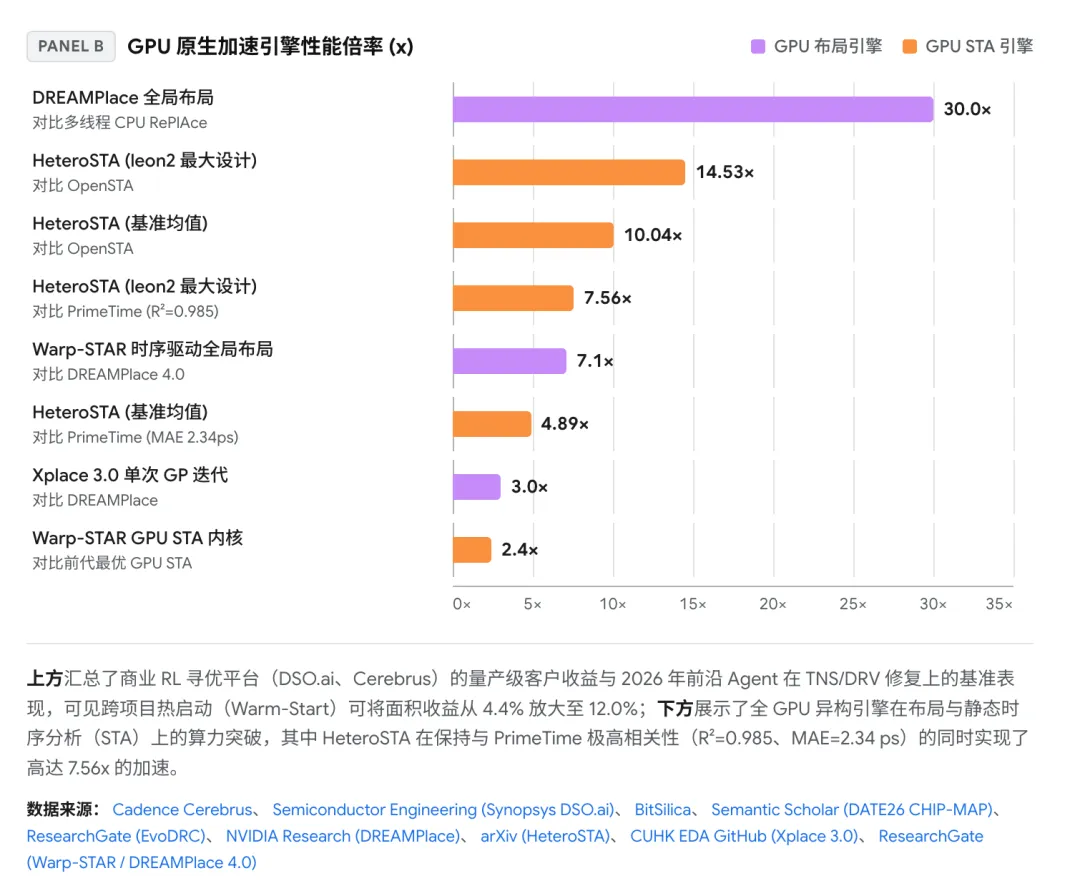
芯片设计AI EDA工具落地调研报告(一):综述及数字芯片产品设计篇最近利用公开数据及论文对AI EDA 在芯片设计领域的发展情况进行了一个调研,并结合自己亲身参与的一些与Cadence,Synopsys工具关联的前期工程落地测试,做了个总结报告。初步计划分为三大篇来发:数字设计模拟设计AI PDK一. 综述在AI agent 对软件工程领域火箭式发展赋能的今年,半导体业内外人士对于AI agent的落地也是诸多关注,目前总的来说有发展,且速度很快。但是远没达到软件工程领域的那种冲击,主要原因还是二者的设计物料不一样,芯片设计领域很难做到纯文本形式,且越往后数据量极大,如验证,物理实现阶段,动辄数GB, TB级,中间还掺杂了较多的“经验式”,“运气式”的东西,俗称“玄学”,尤其是模拟设计领域,玄学极多。还有最重要的一点就是经济账很烂,设计流程跨工具情况较普遍,算子命中率非常低,license及token极其浪费,导致算力代价极其高昂。但是AI落地理论基础是充分的,我觉得只是时间问题。截至 2026 年第四季度,AI 在电子设计自动化(EDA)领域已跨越早期的“单点参数寻优”与“对话式脚本助手”阶段,正式步入以长程智能体(Long-Horizon Agentic EDA)和确定性引擎闭环校验(Evidence-Driven Automation)为核心的第三代技术范式。从 Fabless 芯片设计企业的实战落地来看,当前 AI EDA 呈现明显的分层成熟格局:落地验证在数字后端设计空间探索(DSE)、验证回归压缩,以及模拟高西格玛(High-Sigma)变差验证与工艺迁移等环节,基于强化学习(RL)、贝叶斯优化(BO)与增量学习(Additive Learning)的商业方案已完成规模化量产验证——例如 Synopsys DSO.ai 累计突破 100 次商业流片,Cadence Virtuoso AI 流程覆盖 80 余个生产级项目并延伸至 3nm/2nm GAA 认证流程——具备可量化的 PPA 与 TAT 回报;试点阶段最有价值产生的部分都在试点,短期落地还有较大阻碍。比如全自动 Spec-to-RTL 生成、复杂 UVM 验证环境构建及模拟版图零样本生成等领域,尽管 Synopsys(Autopilot/AgentEngineer)、Cadence(AgentStack/ChipStack/ViraStack)与 Siemens EDA(Fuse EDA AI Agent)在 2026 年密集发布自主智能体平台,但独立学术基准(如 NVIDIA CVDP)与行业观察均表明,此类方案仍处于早期客户试点与隔离沙盒辅助阶段,尚不能脱离确定性 Golden Signoff 引擎独立承担签核责任。从本人参与的模拟类试点来看,电路设计有了较大的突破,在PDK完整支持的前提下,电路构架及调参效率非常的高,个人觉得有短期突破的态势。而模拟版图设计方面基本很难,demo演示都很难重现, 就算在无限token的前提下,突破期还非常的漫长。本调研在数据口径上严格区分经流片检验的量产案例、开放学术基准(如 CVDP、ORFS-agent、HeteroSTA)与EDA 厂商披露的宣称指标。截至 2026 年秋,三大厂商针对 Agentic 工作流普遍宣称 10x–50x 的局部验证或迭代加速,但行业尚缺乏跨商业工具链的第三方独立端到端生产评测基准,多数智能体产品仍处于早期客户接入(Early Access)或特定模块试点期,其真实的 Token 消耗、并行 License 占用以及跨工具边界的语义漂移风险,是 Fabless 团队在引入时必须重点评估的工程红线。范式演进:从单点优化到“证据驱动”的智能体闭环架构过去六年,AI EDA 经历了三代清晰的技术演进。第一代(2020–2022)以 Synopsys DSO.ai 与 Cadence Cerebrus 为代表,核心是将强化学习(RL)与机器学习(ML)引入 RTL-to-GDSII 后端流程,在海量工具选项与约束组合中进行黑盒或灰盒超参搜索。第二代(2023–2024)以 Synopsys.ai Copilot 与 NVIDIA 内研的 ChipNeMo 为代表,依托大语言模型(LLM)与检索增强生成(RAG)提供文档问答、Tcl/SKILL 脚本编写与单轮代码补全。自 2025 年下半年至 2026 年,行业迈入第三代 Agentic EDA 范式:不再依赖 LLM 单轮“裸写”硬件代码,而是将任务拆解、规划与反思能力封装进工程闭环,借助如 Model Context Protocol(MCP)等标准化编排层,由智能体自主调用底层仿真、综合、形式化验证及签核引擎,实时解析报错日志、覆盖率报告与波形数据并循环迭代修复。这一代架构在 2026 年形成了名为“证据驱动自动化(Evidence-Driven Automation)”的工程共识。由于概率型 AI 模型(LLM、扩散模型、图神经网络)天然存在幻觉与跨设计分布偏移(Distribution Shift)风险,Fabless 量产流程严禁由 AI 直接作出 Signoff 放行决策。现代生产级 AI EDA 参考架构将系统严格解耦为三层:顶层的智能体编排与上下文记忆层(负责跨工具流程调度与设计意图延续);中层的概率探索与代理加速层(负责压缩设计空间、生成候选补丁及预测寄生与热点);底层的确定性物理与形式化引擎层(作为不可妥协的 Ground Truth,在沙盒闭环内持续校验每一次 AI 提案,并输出可审计的形式化证明与签核证据链)。这种架构本质上是在攻克超大规模 SoC 流程中的“跨工具交接损耗(Handoff Loss)”与“对账税(Reconciliation Tax)”。现代芯片流片横跨架构、RTL、Lint、CDC、综合、PnR、STA、EM/IR 及物理验证等数十个点工具,不同工具缺乏统一语义模型,导致综合阶段的局部最优网表往往在后端引发严重拥塞或 Hold 违例,工程师不得不消耗大量工时手工对齐约束、豁免项(Waiver)与覆盖率排除列表。2026 年三大 EDA 厂商同步推出平台级底座——Synopsys Autopilot、Cadence AgentStack(依托 JedAI 数据与 AI 平台)及 Siemens Fuse EDA AI(依托多模态 EDA 数据湖与 MCP 编排)——核心诉求正是通过保留跨阶段的语义连续性(Semantic Continuity)来压缩工具边界的损耗。二. 数字芯片设计与验证:Fabless 落地的主战场数字 IC 流程具备高度离散化与标准化的数据接口(SystemVerilog、SDC、DEF/LEF、SPEF、Liberty),使其成为 Fabless 内部 AI 技术渗透率最高、工具生态最完整的环节。按工程流向,数字侧的 AI 演进可分为前端设计与验证、数字后端实现与 GPU 原生引擎、以及签核与 ECO 收敛三个核心战场。前端 RTL 设计、验证与 Debug:智能体破局与基准实测行业普遍统计显示,功能验证消耗了芯片设计项目 50%–70% 的工程人力。2025–2026 年,数字前端 AI 工具沿着两条主线并行推进:一是面向动态仿真回归的 ML 覆盖率收敛(已大规模量产);二是面向 Spec-to-RTL、SVA/UVM 生成与 Root-Cause Analysis(RCA)的智能体工作流(快速商业化试点)。在动态验证加速(ML-Driven Verification)方面,Synopsys VSO.ai 与 Cadence Verisium SimAI 已广泛融入 Fabless 的夜间回归农场。两者均无需修改既有 RTL 或 UVM Testbench 代码:VSO.ai 深度嵌入 VCS 仿真器内部,从约束求解器(Constraint Solver)、测试用例与测试选项三个层级协同优化,支持按回归 CPU 时间、仿真周期数等目标函数自动调度,并对未命中覆盖率 Bin 执行根因诊断,厂商宣称最高可实现 10x 验证生产力提升;Verisium SimAI 则利用 Xcelium 历史回归数据训练机器学习模型,挖掘最小随机种子集以复现并扩展覆盖率空间,据验证从业者技术实践汇总,此类 ML 回归优化通常可缩减 30%–50% 的仿真周期,并在减少 40%–60% 测试用例的情况下维持同等的功能与代码覆盖率。在智能体前端设计与验证方面,2026 年商业发布极为密集。Cadence 将收购并深度整合 Xcelium 与 Jasper 的 ChipStack AI Super Agent 推向客户部署,并在 Computex 2026 宣称升级至“L5 级自主虚拟设计工程师”,结合 2026 年第四季度启动早鸟测试的自研领域微调模型 Maestro(厂商宣称相比通用模型质量最高提升 30%、Token 效率最高提升 5x),通过并行调用数百个动态仿真与形式化任务,宣称将典型 5 周的 RTL 验证闭环压缩至 1 天以内(>40x 加速),早期试用客户包括 NVIDIA、Qualcomm 与 Altera。Synopsys 于 2026 年 9 月发布 Verification AgentEngineer(基于 Autopilot 平台,计划 2026 年底全面商用,并引入与 OpenAI 合作的专属模型 GPT-Synopsys),打通规范解析、RTL/SVA/Wrapper 生成、测试计划、测试平台构建与根因修复,厂商宣称在头部客户试点中实现最高 50x 验证收敛加速、20% 覆盖率提升以及 10%–30% 的 RTL 编码生产力提升。Siemens EDA 于 2025 年推出 Questa One(含多芯粒 DFT 仿真领先引擎 Questa One Sim 与无激励形式化验证),并于 DAC 2026 联合 NVIDIA 发布“自验证长程智能体(Self-Verifying Agents)”,强制要求每步 Agent 决策在运行期即接受确定性物理/形式化引擎校验。垂直初创侧,ChipAgents(Alpha Design AI,2026 年 7 月将 A 轮融资扩充至 1.34 亿美元)聚焦架构探索、RTL、形式化/功能验证与调试,已披露协助晶心科技(Andes Technology)加速定制处理器设计验证,并与 NVIDIA 于 2026 年 10 月联合推出端到端基准 Build-A-Chip-Bench。面对商业宣传中的数十倍加速宣称,Fabless 工程团队需结合独立学术基准进行冷静校准。早期的 VerilogEval v2 与 RTLLM 基准因模块规模小、任务孤立已趋于饱和(GPT-4o 在 VerilogEval v2 上 Pass@1 已达 63%)。为此,NVIDIA 团队于 2025 年 6 月发布并在 2026 年 6 月迭代至 v1.1.0 的 CVDP(Comprehensive Verilog Design Problems) 工业级基准,覆盖算术单元、片上协议、存储层次、DSP 核、代码重构、Lint/QoR 优化及验证激励/断言生成等真实复杂任务。实测数据显示,通用大模型直接面对工业复杂度时性能断崖式回落,唯有结合硬件领域专项微调与多轮工具闭环迭代,才能跨过工程可用门槛。CVDP 基准暴露出的结构性失效模式对 Fabless 验证团队极具警示意义:尽管 Testbench 与 RTL 同为 SystemVerilog 编写,但前沿 LLM 在测试激励/Checker 生成(cid12–13)与 SVA 断言生成(cid14)上的通过率显著低于 RTL 代码生成,甚至频繁产出语法无效的验证平台代码。根源在于 RTL 偏向声明式硬件连接,而验证代码具有强过程化(Procedural/Imperative)与复杂时序交互特征。在 SVA 自动化生成中,若过度依赖 RTL 代码反推属性,更易触发“实现覆盖意图(Implementation Overriding Intent)”陷阱——即把 RTL 本身的逻辑缺陷合法化为断言。针对上述瓶颈,2026 年最具实战价值的前端技术突破集中在三方面。首先是领域专项微调与上下文演进闭环:NVIDIA 团队关联提出的 ACE-RTL 表明,基于高质量特征增补数据训练的专属 RTL 生成模型(ACE-RTL-Generator),结合平均仅需 4 轮工具闭环的上下文演进框架,在 CVDP 上相对 14 个强基线取得了最高 44.87% 的 Agentic Pass Rate(APR)提升,且整体优于直接套壳 Claude 4 的变体;同期推出的大规模基准 RTL-BenchLS(2026 年 6 月,含超 10,000 个经 LEC/SEC 形式化等价性验证的 Verilog 设计,代码规模达 495 行)正推动评测从脆弱的人工 Testbench 转向严格的形式化证明。其次是覆盖率反馈驱动的验证闭环:DATE 2026 多项前沿研究印证了该路径的潜力,其中一项面向 20 个复杂 RTL 设计的 AI 验证工作报告了 1.46x 的 Toggle 覆盖率、2.28x 的 Line 覆盖率及 24.23% 的功能覆盖率提升,而 CoverAssert 等框架则专门利用功能覆盖率空洞反向引导 LLM 生成高价值 SVA。第三是结构化波形/日志多模态根因调试(RCA):实证研究表明,对长达数十万至上百万行的 EDA 综合/仿真日志直接套用常规 RAG 往往召回率低且误报率高,必须结合规则切片与结构化波形中间表示(Waveform IR);哥伦比亚大学与 Google 于 2026 年 10 月发表的 BTTF 波形分析智能体在 150 项查询基准上实现了 95.33% 的执行准确率,商业工具侧 AMIQ 与 Cadence 也已落地将仿真日志、波形追踪与源码联动的 RCA 智能体,并强制采用“隔离沙盒快照 -> 自动回归验证 -> 工程师审批合并”的安全护栏。数字后端实现(RTL-to-GDSII):商业 RL 寻优规模化与 GPU 原生引擎演进数字后端是目前 Fabless 内部 AI 投资回报最确定的阵地,其技术演化清晰分化为商业级宏观流程寻优(Flow & DSE Optimization)与底层算法/异构算力重构两个维度。在商业级宏观 DSE 寻优方面,面对 5nm/3nm/2nm 节点数万亿级的综合、Floorplan、布局布线及 CTS 选项组合,三大 EDA 巨头均已将强化学习深度绑定至各自的一体化 RTL-to-GDSII 数据库。Synopsys DSO.ai(深度协同 Fusion Compiler 与 2026 年发布的 Implementation AgentEngineer)已累计完成超 100 次量产流片,并通过三星 SF2 2nm GAA 等工艺认证。行业技术实践总结显示其在实际设计上可实现超过 10% 的功耗优化,并助力 SK Hynix 在零时序裕量容忍度的 DDR5 设计中按期达成极限时序收敛;更具复利效应的是其跨代热启动(Warm-Start / Transfer Learning)能力——在 Synopsys 披露的 40nm 客户案例中,首代设计通过 DSO.ai 取得 4.4% 面积缩减,将学得的优化策略迁移至衍生芯片后,在近乎零人工干预下实现了 12% 的面积缩减。Cadence Cerebrus 与 Cerebrus AI Studio(协同 Genus / Innovus / Joules / InnoStack)主打多模块、多用户并行的智能体 SoC 后端探索,并已随三星第二代 2nm 及 3D Cube-H 流程完成认证。根据 Cadence 官方披露的客户证言与技术分享:Renesas 在先进节点 CPU 设计上借助 Cerebrus 实现了 75% 的总负裕量(TNS)改善;MediaTek 利用 Cerebrus Floorplan 优化(FP-Opt)在 SoC 模块上实现了 5% 的芯片面积缩减与超过 6% 的功耗降低;Imagination Technologies 借助云端 Cerebrus 显著缩短低功耗 GPU/IP 模块的 PPA 收敛迭代次数;Intel、Broadcom、Juniper(N3E 网络芯片)、MaxLinear(DSP 动态功耗优化)与 Phison 等亦均已披露生产级应用(其中 Intel 重点验证了 Warm-Start 与 Relay 流程在 NPU 与显示子系统上的收益)。Siemens Aprisa AI 则于 DAC 2025 推出并深度集成至 Aprisa 数字实现平台,依托 Fuse EDA AI 数据湖及与 Calibre 的紧耦合,切入 RTL-to-GDSII 寻优赛道。在底层算法与算力底座层面,2025–2026 年的三项突破正在打破传统“黑盒调参耗尽算力与 License”的天花板。其一是宏单元布局(Macro Placement)从慢速在线 RL 迈向零样本扩散模型与多智能体协同。早期 Google Brain 的 Circuit Training(GNN + RL)需要针对每个新网表重新在线训练,泛化耗时较长。ICML 2025 提出的 Chip Placement with Diffusion Models 通过在合成电路集上预训练去噪模型并结合引导采样,首次实现了面向未见真实电路的零样本(Zero-Shot)宏单元布局,在 IBM 与 ISPD 基准上大幅降低半周长线长(HPWL)与 RUDY 拥塞;DATE 2026 的多智能体反馈框架 CHIP-MAP 在宏布局任务中取得了最高 1.5% 的面积缩减与平均 61.6% 的 TNS 修复。在开源 RTL-to-GDS 流程(OpenROAD)上,MLCAD 2025 最佳论文 ORFS-agent(2026 年 4 月更新)与后续的 AgenticPD、EvoDRC 展示了冻结大模型编排外部 BO/分析工具的高效性:在 ASAP7 与 SKY130HD 工艺下,ORFS-agent(搭载 Claude Sonnet 4.6)仅用 40% 更少的迭代次数即在线长(WL)、有效时钟周期(ECP)与联合目标上超越 OR-AutoTuner,且开源权重模型 Kimi K2.5 的综合表现与闭源 Sonnet 4.6 差距控制在 0.24% 以内,直接验证了 Fabless 内网离线部署低成本开源调优智能体的可行性;EvoDRC 则依托演化式修复技能库,在 DAC 2026 DRC 基准上将设计规则违例(DRV)整体削减了 73.5%。其二是全链路 GPU 原生异构引擎攻克“CPU STA 瓶颈”。在经典开源 GPU 全局布局器 DREAMPlace(相比多线程 CPU RePlAce 提速超 30x)之后,香港中文大学推出的 Xplace 3.0 将每轮全局布局迭代进一步提速约 3x,并集成了 GPU 定时器与时序驱动布局。但长期以来,时序驱动优化受困于 CPU 端静态时序分析(STA)的通信与计算开销。2025 年 11 月北京大学等团队发布的 HeteroSTA(Rust/C++/CUDA 实现,内置完整 Tcl SDC 解释器并支持全 GPU 内存零拷贝 API),在与 PrimeTime 保持极高相关性(平均 R² = 0.985、MAE 仅 2.34 ps)的前提下,平均比 PrimeTime 快 4.89x(最大基准设计 leon2 上快 7.56x),比 OpenSTA 快 10.04x–14.53x。2026 年 7 月发表的 Warp-STAR 进一步实现 Warp 级并行可微 GPU STA(较前代最优 GPU STA 再提速 2.4x),集成入全局布局后较 DREAMPlace 4.0 实现了 7.1x 的端到端加速。其三是电路基础模型(Circuit Foundation Models)赋能“左移(Shift-Left)”PPA 预测与 CTS 优化。时钟网络通常占据芯片总动态功耗的 30%–40%,且在 5nm 以下受 OCV 与多时钟域约束极深,GNN 联合 RL 的多目标 CTS 预测与优化正加速替代传统启发式搜索。底层通用电路表征从 AIG 信号概率监督的 DeepGate3 / DeepGate4 演进至跨模态电路编码器 CircuitFusion(ICLR 2025)、自监督跨设计版图时序功耗模型 ATLAS(DAC 2025 / TCAD 2026)与应对逻辑综合拓扑变换的 CircuitGate(2026),辅以 CircuitNet 3.0(ICLR 2026)和 ForgeEDA 等多模态数据集,推动前端 RTL 阶段即可获取高保真后端 PPA 反馈。(数据口径勘误提示:依据 Cadence 官方 Cerebrus 客户证言原文排布,上述商业案例中 75% TNS 改善对应的先进节点 CPU 客户实为 Renesas,而使用 Cerebrus FP-Opt 实现 5% 面积缩减与 >6% 功耗降低的 SoC 模块客户实为 MediaTek,阅读对比时请以该精确归属为准。)签核(Signoff)、功耗完整性与 ECO 闭环:ML 辅助根因定位与物理底线在流片前的签核关口(STA、EM/IR、DRC/LVS),零误差底线决定了 AI 的角色并非替代物理求解器,而是加速路径级时序分析(PBA)、预测动态压降热点、压缩根因诊断(RCA)周期并自动执行合规 ECO 修复。在功耗完整性(EM/IR)与 In-Design 修复方面,3nm/2nm 节点绕线电阻激增与电源网格(PDN)裕量收窄使动态 IR-Drop 成为签核主要卡点。Cadence Voltus InsightAI 利用深度学习精准识别导致压降的根因 Aggressor 单元,并无缝集成至 Innovus 实现时序与 DRC 感知的 In-Design 自动修复(Google 与 Cadence 已在 CadenceLIVE 2025 联合分享其实战流程)。Synopsys RedHawk-SC RCA Agent(结合 SigmaDVD 动态压降左移分析)能够自主调用签核级引擎定位压降根因并推荐修复方案,将原本依赖资深专家数小时的手工 Debug 压缩至分钟级。学术侧基于图学习与 CNN 的静态/动态 IR-Drop 代理模型亦在部分测试中实现相对 NGSPICE 高达 30x 的估算加速。在时序收敛与物理验证调试方面,Synopsys PrimeTime 已集成 ML 引导的 ECO 优化器,并在 2026 年推出 PrimeTime Vmin Optimization Agent,用于自动挖掘时序/电压裕量、定位限制最低工作电压(Vmin)的关键路径并闭环执行 ECO,同时保持签核级精度。Cadence 则通过 Tempus DSTA(SSV 25.1 架构在大型复杂设计上缩短 30% 运行时间、降低 20%–30% 内存占用)、Certus Closure 与 Conformal SmartECO(Realtek 披露用于抑制传统功能 ECO 补丁规模失控问题)加速多角签核收敛。物理验证侧,Siemens Calibre Vision AI 针对全芯片集成阶段的百万级 DRC 违例提供聚类归因与高效调试,并与 DE Via 等模块协同优化过孔插入以兼顾 IR-Drop 收敛。

 研报速递