研报速递
FIELD NOTES · 场景实验手记
本文来自一次真实的内部仿真验证实验,记录了「一篇 30 页研报」到「可运行应用」的全过程。
今年秋招,多家头部规模化猪企开出高薪,大规模招聘大模型、算法方向人才,把 AI 岗位摆到校招最核心的位置。一边是行业重金渴求既懂养殖业务、又懂人工智能的复合型人才;另一边现实困境并没有改变:懂养猪的老师傅不懂算法,懂 AI 的工程师很难沉到猪场一线。真正值钱的,依旧是资深场长脑子里那套只可意会的现场手感。
设备、传感器、大屏已经铺进大量现代化猪场,但场长一旦休假或者离职,整套生产管理就容易出现波动。行业一直在思考:能不能不依赖大量复合型人才驻场,把沉淀在报告、文档里的行业认知,直接变成一套能干活的数字场长?
带着这个好奇,周五下午四点,我们把一份 30 页的研报丢进 HyperReal,然后去开了个会。
那份报告叫《规模化智慧猪场》,讲中国养猪业怎么从散户走向规模化。里面全是行业黑话:PSY、料肉比、批次化生产、两点式布局。
我们没做任何预处理。没清洗数据,没画流程图,没写需求文档,也没找任何一位养猪专家开过会。
四小时后回来,HyperReal 给了我们三样东西:一份行业结构图、一份本体草案、几个可运行的应用。但这套东西的第一版并不合格。我们动手改了三处,改动不到一页纸——而恰恰是这三处,决定了它能不能真的进猪场。
先搞清楚:这行里谁在赚钱、靠什么赚钱
HyperReal 做的第一件事不是写代码,是把这篇报告拆成四类东西:玩家、流程、数据、堵点。
▍玩家层面,它把牧原、温氏和一大批中型场分开了。分法不是按规模,是按赚钱方式:
●牧原走的是极致成本——自繁自养、重资产,把每一头猪的采食和增重都变成数据;
●温氏走的是"公司+农户"——轻资产、扩张快,代价是过程数据拿不到;
●中型场的处境最尴尬:规模上去了,管理还靠人,数据留在饲养员的笔记本里。
▍流程层面,它把猪场拆成三条主线:饲喂、环控、防疫。每条线下面挂着具体动作和参数——日龄、体重、采食量、料肉比、舍温、湿度、氨气浓度。
▍堵点层面,它标了两个。
第一是「数据孤岛」:环控系统、饲喂系统、生产管理系统各说各话。氨气已经超标了,饲喂系统并不知道,照旧按原曲线投料。
第二是「决策依赖人」:什么时候加料、什么时候开风机、这批猪要不要提前出栏,全靠场长十几年的手感。场长休假,整个场就"降智"。
三段拆完,引擎停下来,问了我们一个没想到的问题。
 它没急着造应用,先问了一个问题
"如何动态调整饲喂?"
后来我们才知道,这在方法论里有个名字,叫 Competency Question(能力问题)——你要造的这个系统,到底要能回答什么问题。听起来学术,其实很朴素。
你不会先想"我要一个什么样的 App",你会先想"我这行最难的那个判断是什么"。
养猪这行,最难的就是:这头猪今天该吃多少。
难在哪?因为答案不是常数。同一栏猪,日龄不同、体重不同、季节不同、猪舍朝向不同,答案都不一样。而且它是个连续动作——今天多喂 200 克,三周后料肉比就变形。
HyperReal 顺着这个问题往回倒推:要回答"该吃多少",系统必须认识哪些东西?
它把答案列了出来:
1猪栏——决策的最小单元。不是"猪场",也不是"单头猪",是栏;
2批次——决定饲喂曲线的基准。同一栏里日龄可能差七天;
3传感器读数——舍温、湿度、氨气。环境一变,采食量就变;
4饲料配方——同一个"一公斤",不同配方成本能差三成;
5日龄、体重、采食量——算料肉比的三件套。
这就是它分析建成的本体(Ontology)。
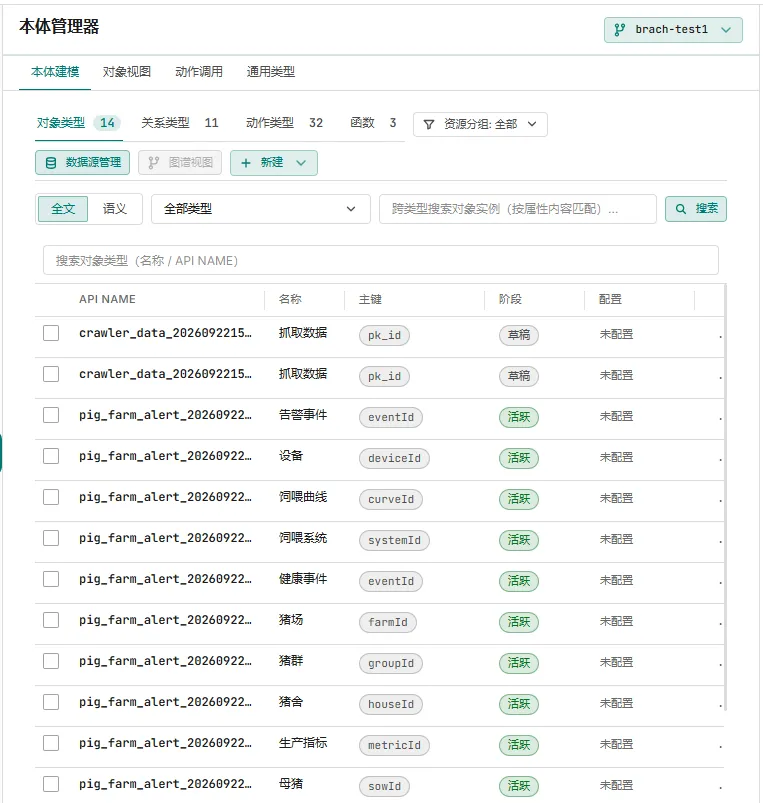
说白了它不神秘,它就是把这个行业里"谁跟谁有关系、动一个东西会牵动什么",写成机器能读的结构。
大多数 AI 项目死在哪儿?不是模型不行,是这一步被跳过了。你扔给它一堆数据,它分不清哪个是对象、哪个是参数、哪个是结果,于是只能生成一份看起来很聪明的报告。
 把五样东西连起来,它开始会做判断
有了对象,下一步是连线:对象 → 关系 → 动作。
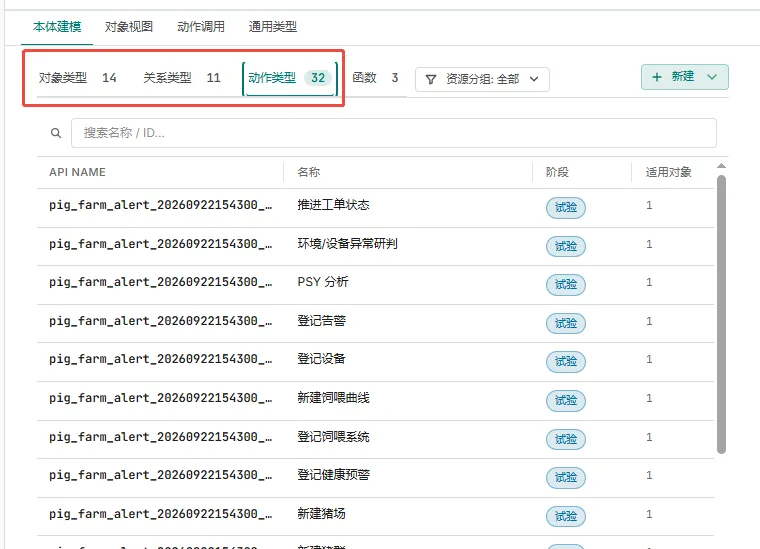
我们认为这是整件事里最像"经验"的部分。它生成的一条规则如下(已做简化,仅为实验草案):
RULE · 生成的规则草案
当某栏七日平均采食量下降超过 12%、舍温高于 28℃、且无体温异常等疾病指征 → 判定为热应激,而非疾病。
动作:投料时段挪到早晚凉爽时段,下调饲喂曲线 5%,开启水帘,48 小时后复评。不触发兽医工单。
这条规则里最值钱的,不是"开个水帘",而是"不触发兽医工单"。
传统猪场的流程是:采食量掉了 → 系统报警 → 饲养员跑过去看 → 叫兽医 → 兽医到场发现只是天热 → 白跑一趟。
一年下来,这种"白跑"能吃掉技术员大量的时间。而白跑多了,人就学会忽略报警。
这才是猪场智能设备真正的死因:不是不准,是没人信。
一个本体做对了,省下来的不是电费,是"报警的可信度"。
 纸上说的通,栏里也跑得通
草案写得再漂亮,落不了地就只是一份文档。
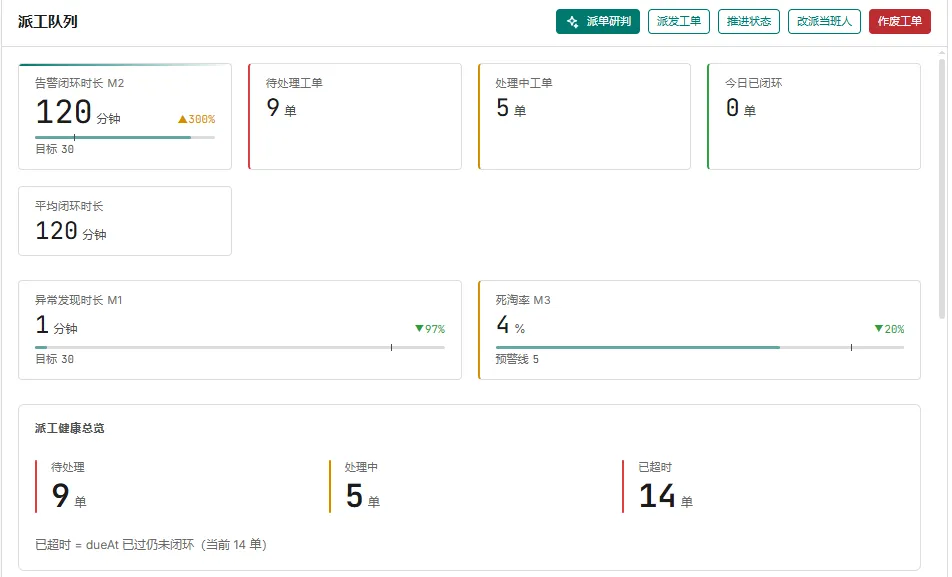
第四步是把它落进 HyperReal,生成多个可运行的应用。
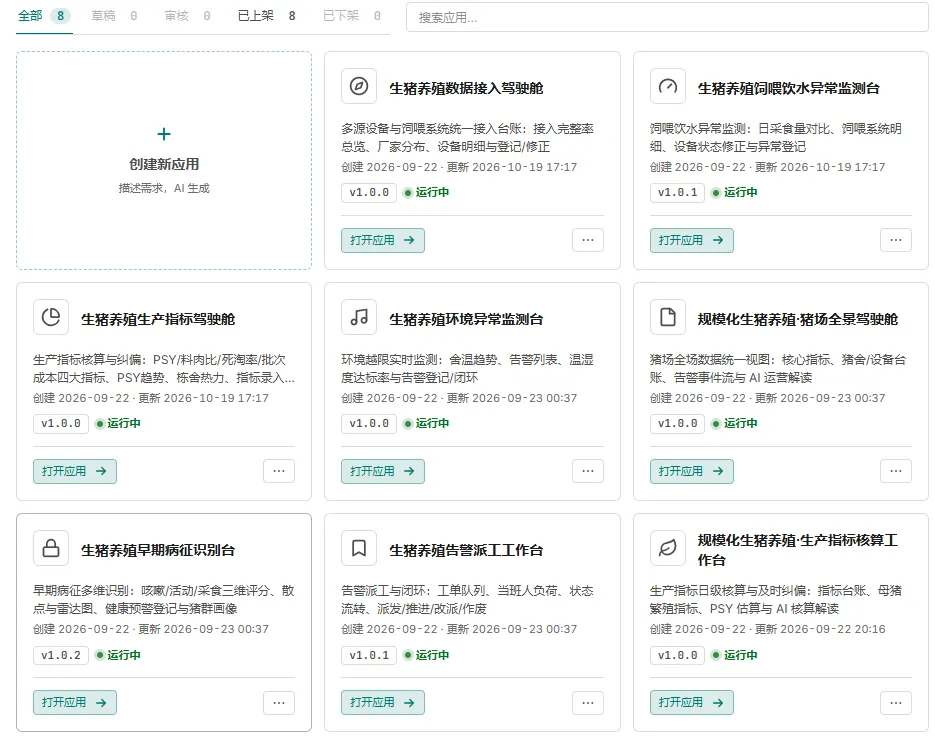
跑起来之后它具备四类能力雏形:
① 实时接数据——环控、饲喂、生产系统的数据能进来,且不用改造原有系统;
② 给建议——按栏、按批次输出当天该喂多少,附一句人话解释;
③ 反控设备——建议被采纳后直接下发给饲喂器和风机,不用人再去点;
④ 异常推送——只推真正需要人处理的那几条,剩下的自己消化掉。
第三条是关键分水岭。
Demo 和产品的区别,就在"能不能把话说完之后,把事也做了"。能接入、能决策、能回写,才叫闭环。只会聊天的,叫玩具。
我们动手改了三处,加起来不到一页纸
说实话:它第一版出来,我们动手改了。
改了三处对象关系
▸把"栏"和"批次"从一对一改成一对多,因为实际生产里会并栏;
▸补了一个"称重记录"对象。报告里没提,但没有它,采食量就没有基准;
▸把"饲料配方"从属性改成独立对象,因为同一个配方会被多个批次复用。
改了一条饲喂规则
▸原本是"体重低于标准 5% 就加料",改成了"连续三天低于标准才加料"。机器给的是瞬时判断,但单日体重波动在生产里太正常了,按瞬时值调,会把猪喂坏。
改了一个异常阈值
▸氨气报警线从 25ppm 收紧到 20ppm。报告里写的是行业标准值,但这家场的通风条件达不到,得提前干预。
一共改了不到一页纸。
这就是 HyperReal 坚持"不做一键全自动"的原因。机器出的草案能覆盖八成,但那两成恰恰是要命的地方——是并栏、是单日波动、是这家场跟别人不一样的那一点点。
改完之后,这份本体就成了这家场自己的资产。下一个场,改的还是这一页纸,不是从零再建一遍。
过去十年,猪场数字化的主体工作是"把数据采上来、把报表做出来"。传感器、环控、饲喂系统各自把数据存好,管理者的工作是在几张报表之间做交叉判断——系统负责记录,人负责判断。
这里的尝试,是把判断本身也写进结构里:不是再做一个看板,而是让系统回答"这栏猪今天该吃多少",并且为这个答案负责——包括负责不下发那条不该下发的兽医工单。
更根本的差别在交付形态。它不是一套部署三个月、上线即固化的软件,而是一份可以持续修改的资产。
这件事的意义,其实并不只在猪场
四小时,一篇行业研报,变成可运行的应用。听起来像个 Demo。
但把它抽象一层,你会发现猪场、晶圆厂、县医院、货运站,结构是一模一样的:
都是一群对象:猪栏、晶圆批次、病床、车次;
都是一套规则:饲喂曲线、工艺窗口、床位周转、装载率;
都是一个要做的决定:今天喂多少、这批能不能放行、这个病人收不收、这车怎么拼。
过去造这套东西,要一个团队驻场两三个月,报价七位数。所以只有巨头玩得起,剩下的人只能看着案例激动、看着报价冷静。
借助 HyperReal,现在它变成了一次"读一篇文章、改一页纸"的事。
我们真正想做的,不是让 AI 更聪明,是让"懂行"这件事,便宜到每个行业都买得起。
下一期,你想看我们造哪个行业?
留言区写下来,点赞最高的那个,我们下期当着你的面造一遍。你只需要告诉我们你的痛点,一句话,一篇文档都可以。
点击左下方「阅读原文」文字链接即可体验