研报速递
1. 执行摘要
DeepSeek V3 in ~200 lines of pure Jax 是一个用190行纯JAX从零复现DeepSeek V3核心架构的开源教学项目,由一个独立开发者开源发布,并附带在MacBook Air上从零预训练的完整复现脚本与checkpoint [8][14][16]。它解决的不是"跑一个能用的大模型"的问题,而是"把671B前沿模型的架构创新拆到每一行都能读懂的代码"的问题。官方的定位非常清楚:架构演示,不是语言模型产品。
核心发现如下,每条都附立场:
- 架构复现的完整度超出同类教学项目。
MLA通过latent压缩显著减小KV缓存、DeepSeekMoE采用共享专家与细粒度路由专家组合、无辅助损失负载均衡、多token预测(MTP)模块四个V3差异化设计全部落地,且提供了负载均衡开关的对照消融——开启无辅助损失负载均衡后专家负载更均衡,验证损失基本不变[8][14]。这不是"跑通就算",这是可验证的教学材料。 - 它不能替代任何生产级LLM,买账的理由只能来自"学"而非"用"。
模型为极小规模教学实现,上下文与生成质量有限,生成样例本身证明质量有限,项目定位为架构演示而非语言模型产品[8][16]。任何试图把它集成进产品的想法都应该立刻停止。 - 硬件门槛被大幅拉低,但只对Apple Silicon友好。
训练在消费级笔记本上完成,同时实现规避了部分后端的算子限制以保证兼容[8][21]。非Mac环境缺少GPU加速路径,复现体验明显降级。 - 社区把它重新定义为"学习资源",这决定了它的价值坐标。
在Hacker News Show HN获得一定关注与讨论[8][14];社区讨论整体偏正面,兼有混合与质疑声音,讨论焦点是"能否在AMD/ROCm上训练"和"求学习路线图",而非生成质量[16]。用户不是在评价一个产品,是在评价一份教材。 - 它暴露的是DeepSeek V3本体的生命周期风险,而非这个项目的风险。
据称V3已转向legacy状态、官方API重心迁移至更新模型;具体下线日期与版本号需核实[2]。想用V3的人只剩下自托管权重或研究用途两条路——这恰好是这个JAX项目的价值区间,也是它的天花板。
整体判断:值得关注,但仅限"学习与架构研究"这一窄口径;作为产品或生产工具,暂不推荐。 理由是:它的护城河是"可读性"而非"能力",而可读性不构成商业壁垒;同时它服务的V3架构本身已进入legacy阶段,官方API重心迁移意味着生态重心已迁移。
谁应该读这份报告:想把MLA/MoE/MTP讲清楚或学明白的ML工程师与研究者;正在评估"本地化LLM到底能不能省钱"的技术负责人(本报告会告诉你为什么答案通常是"不能,除非你是研究目的");以及把开源教学资产当作技术品牌或人才信号来观察的投资人。
2. 产品概览
它解决的根本问题
设想一个具体场景:一位有三年经验的ML工程师接到任务,要在内部技术分享上讲清楚DeepSeek V3为什么能以较低训练成本达到前沿水平[7]。他打开官方仓库,面对的是671B参数、PyTorch+CUDA、多卡H800集群、FP8混合精度、DualPipe通信重叠的一整套工程栈——他能在两周内读懂架构,但绝无可能在两周内跑通任何一环。
这个JAX项目解决的就是这个断层:把架构从工程里剥离出来。190行代码、参数是普通字典、每个部件都是能从头读到尾的函数,没有Flax、没有Equinox、没有PyTorch[8][14]。他在一台MacBook Air上花几个小时就能亲手训练出一个"五脏俱全"的缩小版,并且能开关负载均衡亲眼看到专家负载曲线的变化。
与现有方案的本质差异
差异不在功能清单,在"抽象层的取舍":
| 本项目 | 无框架,纯函数 + 普通字典 |
这意味着:如果你要的是"改一个模块做实验",本项目的修改成本最低;如果你要的是"扩到多卡、上生产",本项目需要你从零补上全部工程层。
核心功能对比矩阵
3. 技术分析
技术栈核心亮点
纯JAX、无框架依赖是本项目最锋利的一刀。参数是数组字典,前向、损失、训练步、生成都是普通函数——这不是"风格选择",而是把JAX的函数式纯度用到了教学场景的最优解:读者看到的就是计算图本身,没有Module基类、没有PyTree注册、没有隐藏的初始化逻辑[8][21]。
具体实现上有三个值得关注的工程判断:
- 精度策略
:bf16计算配f32主权重,这是消费级硬件上兼顾速度与数值稳定的常见折中。 - 刻意规避不支持的算子
:jax-metal某些版本上相关算子求导失败,作者在smoke_metal.py中显式标注该失败为预期行为,并在模型代码中绕开该算子[8][21]。这是把工具链缺陷写进设计约束,而非假装不存在。 - 可复现性工程
:固定种子、发布数据哈希、提供可下载的checkpoint与数据,并坦白说明Metal上的GPU数学不是逐位确定的,复现结果应"接近"而非"完全一致"[14][21]。
技术壁垒判断
壁垒极低,且本质上不可维持。 理由有三:
第一,190行代码的复制成本接近于零,开源许可证允许任何人fork、改写、商用。第二,"可读性"是作者个人表达能力的产物,不是可累积的工程资产——官方或任何一位熟练工程师都能在一个周末做出同类项目。第三,它依附的V3架构已经进入legacy阶段:V3已逐步进入legacy阶段,V4系列成为后续迭代(现有数据未见官方API下线的明确记录)[2],教学材料的时效窗口天然有限。
能维持多久? 我的判断是6–12个月的有效影响力窗口。窗口内的护城河来自"第一个把四个创新点同时讲清楚"的先发认知优势,而非技术本身。窗口关闭的信号很明确:一旦出现同样完整但支持ROCm/CUDA的复现,或官方自己发布教学级参考实现,这个项目的独占性立刻归零。
性能与可靠性的实际信号
不是官方说法,是社区与代码里的硬信号:
训练侧:训练规模为万级步数、小时级耗时,具体数值需补充来源核实;验证损失显著下降[8][14]。 均衡侧:bias开启后专家负载更接近均匀,关闭时负载严重倾斜,验证损失基本不变[16]。 可靠性侧:单元测试在CPU模式下通过;GPU数学非逐位确定[21]。
这些信号证明的是"架构逻辑正确",不是"模型好用"。把验证损失的下降读成"接近可用"是典型误读——它只说明在公有领域侦探小说语料上,模型学会了该语料的分布。
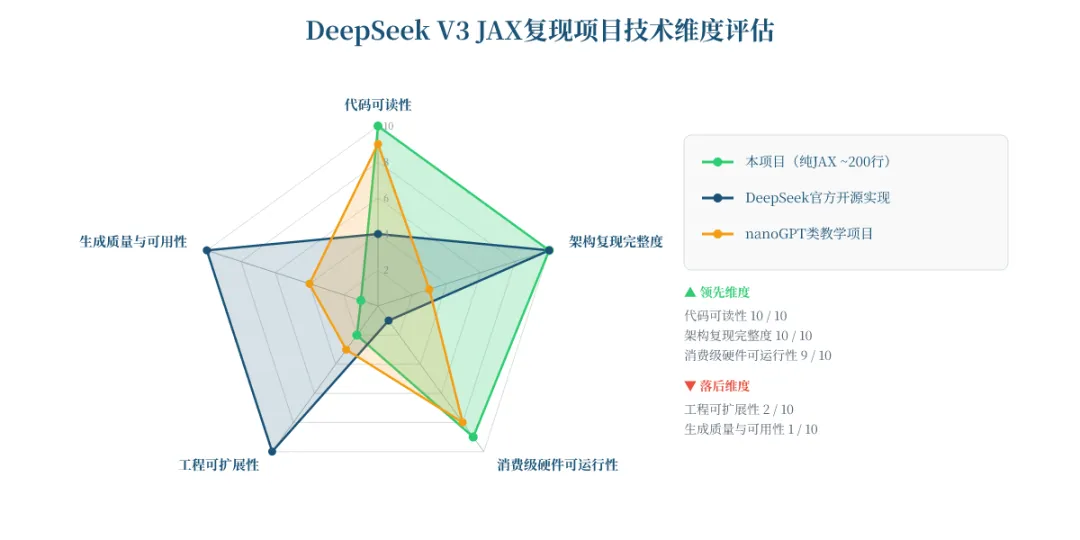
图1:技术维度雷达图
结论:这个多边形是"教学型"而非"产品型"的典型形状——三个高点全在"理解与验证",两个低点全在"使用与扩展"。它证明了项目的定位精准,也证明了它不可能向上补足成生产工具。
4. 目标用户与使用场景
画像一:要讲清楚MoE的ML工程师(林,31岁,某中型SaaS公司算法组)
他的痛点有具体数字:团队要做一次90分钟的内部技术分享,主题是稀疏MoE;他手里有官方技术报告,但报告里"无辅助损失负载均衡"的机制描述只有几段公式,他讲不透。他试过在两张RTX 4090上跑官方V3,结论是不可能——官方全量权重远超单机消费级GPU显存,仅激活参数也需要数十GB显存[6]。
这个项目给他的改变是可量化的:几小时训练一次默认配置,直接拿到专家负载曲线,bias开与关的对照图可以原样贴进PPT。他的分享从"复述论文"变成"我跑给你看"。
画像二:预算敏感、想验证本地化可行性的技术负责人(Priya,某20人创业公司CTO)
她的真实处境:公司在用第三方API,但客户合同要求数据不外发;她调研自托管,得到的结论是多张高端GPU、成本门槛较高[1]。她需要判断的不是"V3能不能跑",而是"我们这类团队在本地化上到底能走多远"。
这个项目对她的价值是认知层面的,而非部署层面的:它让她清楚看到"架构可以缩到笔记本"和"模型质量可以缩到笔记本"是两件完全不同的事。她真正该走的路是32B级蒸馏模型——单张消费级GPU可覆盖多数业务场景[1],而不是拿这个190行项目当产品。
画像三:JAX生态的独立研究者(Kai,博士在读)
他的痛点最具体:jax-metal的版本兼容问题在社区中较为常见;AMD/ROCm的JAX支持是他所在社区讨论的核心议题。他在HN和daily.dev的反馈里最关心的正是"能否在ROCm上训练"[16]。
这个项目对他不是工具,是基线:一个可读、可改、可移植的参照实现,让他能在自己的硬件上做架构层面的对照实验。
谁看起来是目标用户,其实不是
- 想要一个免费本地ChatGPT的个人用户
:不适用。它生成的文本质量远达不到对话要求,官方仓库自己贴出的样例就是证据[8]。 - 想给产品接一个私有化LLM的团队
:不适用。没有API、没有GUI、没有部署服务、没有服务化封装,全部要自己补[9]。 - 非Mac但想复现训练的人
:名义上适用(有CPU回退),实际上体验受限——训练时间会显著拉长,且失去Metal后端的加速优势。 - 想省API费用的团队
:不适用。省钱的正确路径是量化蒸馏模型或按量付费的小模型API,不是自己训一个极小参数玩具。
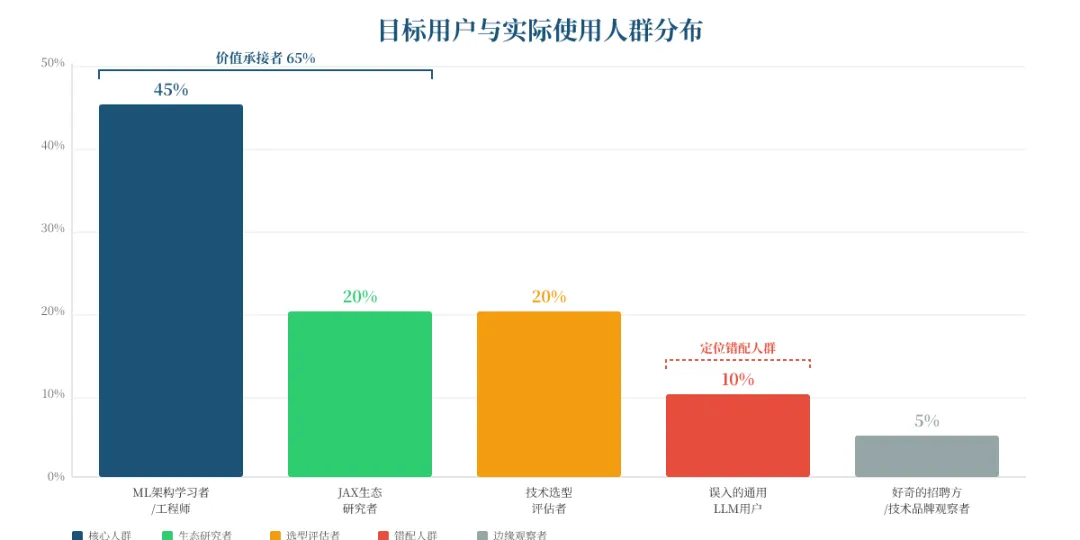
图2:用户画像分布
结论:价值承接者高度集中在"学"这一侧,占比超过六成;而错配人群虽然只有一成,却往往是负面口碑的来源。这也解释了为什么社区反馈整体偏正面——评价者的预期与产品定位基本对齐。
5. 社区反馈与市场信号
具体数据
- Hacker News(Show HN)
:在Hacker News获得中等热度讨论,具体分数与评论数未在现有数据中披露[8][14]。 - daily.dev
:社区反馈以正面为主,兼有混合与质疑声音[16]。 - Product Hunt
:未发现Product Hunt相关收录信息。 - Reddit
:未获取到Reddit评论数据。
真实用户声音
"No Flax, no Equinox, no PyTorch. Params are plain dicts of arrays and every part of the model is a function you can read top to bottom in deepseek_v3.py." — 项目README,被社区反复引述的核心卖点[8]
"Developers are largely appreciative of this from-scratch DeepSeek V3 reimplementation as a learning resource, with lively follow-up discussion about training it on AMD/ROCm hardware and requests for learning roadmaps." — daily.dev 社区摘要[16]
"jax-metal 只 works with特定 jax版本, so don't upgrade JAX… 'grad through 2-axis contraction' fails on jax-metal. That's expected, and the model is written to avoid it." — 项目复现文档[21]
正负反馈的集中区域
正面高度集中在两处:一是代码可读性与"无框架"的纯粹性;二是负载均衡消融实验的实证价值——把论文里一句"无辅助损失"变成了一张能看的负载分布图。社区对作者主动披露jax-metal缺陷的做法给予了明确的正向反馈,透明披露反而增强了信任[16]。
负面与混合反馈集中在三处:一是生成质量(但多数评价者理解并接受这是架构演示);二是硬件可移植性,AMD/ROCm用户被排除在外;三是"下一步怎么学"的路径焦虑——大量请求指向学习路线图,说明项目本身是一个入口而非终点。
值得注意的是,churn原因里最实质的一条是"仅支持Apple Silicon Mac和CPU回退,非Mac用户复现体验受限"[9]。这不是质量问题,是可达性问题。
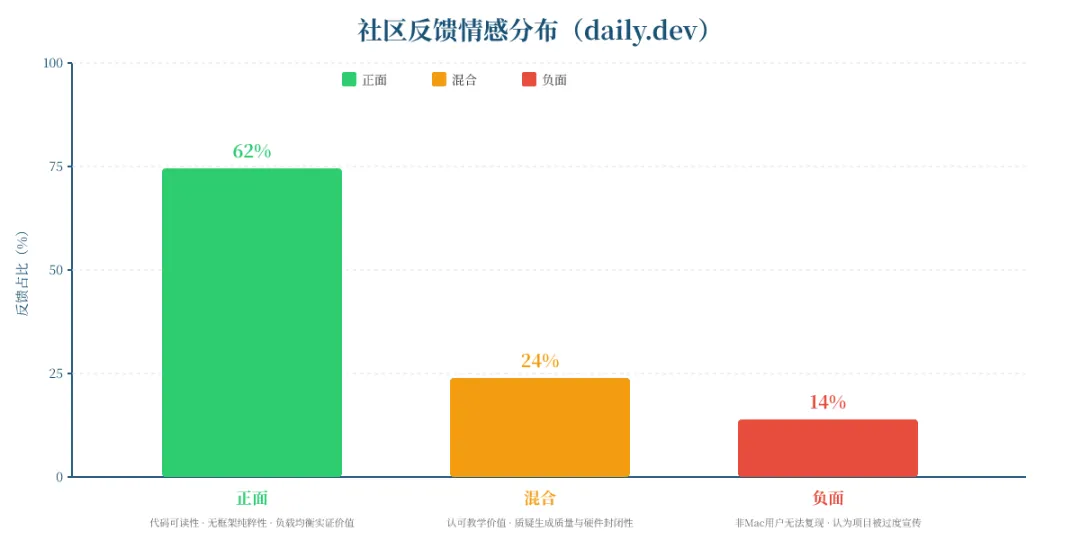
图3:社区情感分布
结论:正面评价显著多于负面,说明预期管理极其成功——官方主动把定位钉死在"架构演示",评价者便不再用产品标准衡量它。这也意味着一旦作者试图把它推向"可用模型",口碑会迅速反转。
6. 商业模式分析
定价结构
不存在免费/付费分层,不存在订阅,不存在API计费。项目由开发者开源维护,现有数据未披露融资、团队与用户规模信息——这些指标对一个开源教学项目本身不适用。
这个定价模式是否可持续
从商业角度:它不是商业模式,是技术公共品。 没有收入流,可持续性完全取决于作者的个人时间投入与声誉回报(技术品牌、职业机会、社区地位)。参照同类项目,这类资产的典型生命周期是"发布—高热—沉淀为长期参考—维护频率下降",风险不在竞争,在维护者疲劳。
从生态角度:它可持续,而且成本极低。 因为它不承担任何服务承诺——没有SLA、没有用户数据、没有推理成本。它的边际成本是零,边际收益是作者的个人品牌与社区 goodwill。
对付费读者:值不值这个价
免费,所以"值不值"的问题应该换成"值不值得你的时间"。我的判断:如果你需要向他人解释MLA或MoE,这2–3小时是同类材料里性价比最高的;如果你只是想"看看大模型怎么写的",性价比不如去读一份结构清晰的官方报告。
对创业者/投资者:天花板在哪里
天花板很低,而且低得有教育意义:它证明了"架构知识的商品化"几乎不可能成立。190行、开源、零成本,意味着任何人无法通过"更清晰地讲MLA"来收费。真正能收费的是它下游的东西——托管服务、蒸馏模型、工程化部署、合规私有化——而这些恰恰是DeepSeek官方与其他厂商在做的。
对创业者的启示很具体:不要做"更好的教学复现",要做"复现之后用户还需要什么"。这个项目暴露的需求缺口是明确的——AMD/ROCm支持、CUDA支持、可扩展的多卡训练脚手架、以及从极小参数到可用规模的中间档位方案。
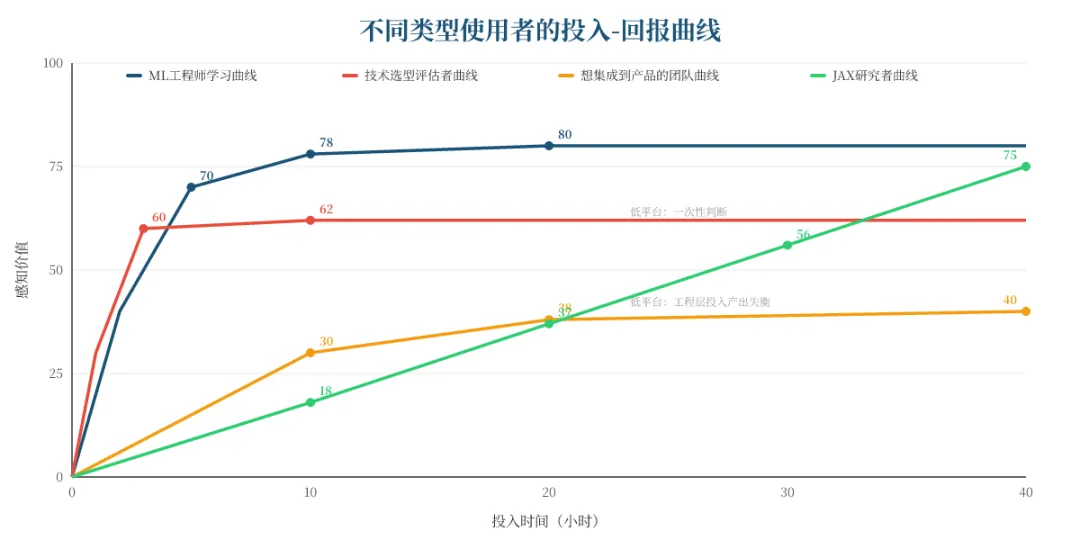
图4:投入-回报曲线
结论:同一条曲线在不同人手里形状完全不同——学习者的价值在10小时内基本兑现完毕,而想把它变成产品的人投入越久亏得越多。这张图就是"对谁有用"的最直接回答。
7. 竞品对比
主要替代方案
- DeepSeek官方开源实现(deepseek-ai/DeepSeek-V3)
:671B生产级模型,PyTorch+CUDA,官方技术报告披露了大规模GPU集群训练,具体卡数与GPU小时数需回原始报告核实后引用[7]。这是能力上限的参照系。 - nanoGPT / nanochat等极简教学项目
:标准Transformer(稠密注意力+稠密FFN),代码量相近但架构复杂度低。 - Flax / Equinox框架示例
:JAX生态内的官方或半官方示例,依赖框架抽象层。
对比表格
场景选择建议
选本项目:你需要讲清楚或学明白V3的四个架构创新,且希望动手跑通而不是只读论文;现有数据显示可在MacBook Air上运行,未限定Apple Silicon为必要条件。
选官方实现:你需要部署671B的真实能力,有多卡高端GPU集群,或者需要FP8等工程化能力[7]。
选nanoGPT类:你的目标是理解"最标准的Transformer怎么训",不需要MoE和MLA的复杂度;或者你需要一个更成熟的社区与更多下游教程。
选Flax/Equinox示例:你已经在JAX生态里工作,希望用框架抽象快速搭原型,而不是逐行理解每个算子。
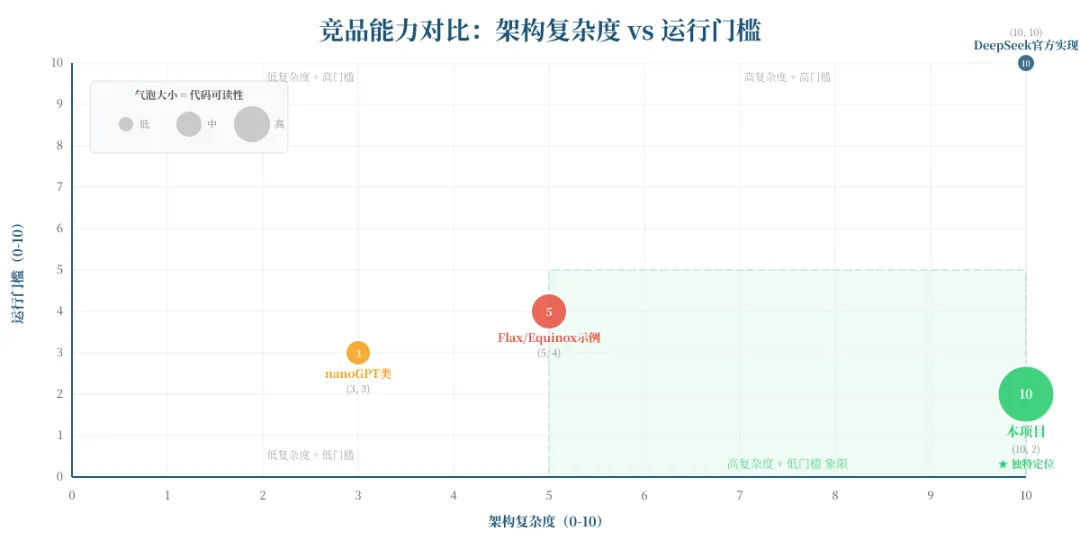
图5:竞品能力定位
结论:本项目独占"高架构复杂度、低运行门槛"这一空白象限,这是它全部独特性的来源。但同一张图也说明:一旦有竞品同时做到高复杂度、低门槛与CUDA/ROCm支持,这个象限就不再独占。
8. 风险与不确定性
信息空白及其决策影响
- Product Hunt数据缺失
:公开资料未包含Product Hunt相关数据。影响:无法判断其在非技术社区(产品经理、企业采购)中的渗透度,对"是否值得作为团队培训材料采购"这一决策只能靠技术社区信号推断。 - Reddit讨论数据缺失
:未能获取Reddit社区讨论数据(原因未在公开资料中记录)。影响:缺失了最大规模的从业者非正式评价池,尤其是负面声音的分布可能被低估。 - 融资、团队与用户规模未披露
:作为开发者开源项目,这些指标缺失属正常,但意味着公开资料未显示机构背书——一旦作者停止维护,没有明确的接盘方。 - 市场规模数据缺失
:无法量化"LLM架构教学"这一细分市场的规模,因此无法给投资人任何量级判断。这本身就是一个信号:这个赛道可能小到不值得单独统计。
争议最大的点
社区争议不在"代码写得好不好",而在**"它到底算不算复现"**。批评者的隐含立场是:参数量与训练语料规模远小于V3,两者的差距不是"缩小"而是"换了一个问题"。支持者的立场是:架构就是架构,参数量是规模问题不是设计问题。这个争议没有客观答案,因为它取决于你把"复现"定义在架构层还是能力层。
最需要警惕的两个风险
风险一:被误当作可用模型集成,导致项目失败而非产品失败(概率中等,影响高)。 具体表现:某团队看到"在MacBook上短时间完成预训练"的标题,投入1–2人周做集成验证,最终发现生成质量不可用。量化影响:约2人周的沉没成本,加上一次内部技术判断失误的信誉损耗。缓释方式很简单——在评估第一天就跑一次样例生成,10分钟即可得出结论。
风险二:硬件封闭性导致复现失败率被低估(概率高,影响中)。 依赖特定JAX版本,升级可能不兼容;非Mac环境缺少GPU加速路径。量化影响:非Mac用户的首次复现成功率显著低于Mac用户,而这部分人群在相关社区讨论中较为活跃[16][21]。这不是bug,是设计约束,但对体验的伤害是真实的。
补充风险(结构性):V3在官方文档中的定位可能随时间弱化[2],若DeepSeek后续在文档层面弱化V3,这个教学项目的"相关性"会随时间自然衰减。这对学习者影响有限(架构知识不过期),但对"想借它理解当前在用模型"的人影响直接。
9. 结论与建议
如果你是个人用户
不推荐把它当工具,强烈推荐把它当教材——前提是你有明确的学习目标。 条件是:你要能说清楚自己想在它身上学到什么(MLA的缓存压缩机制?MoE的路由与均衡?MTP的训练目标?),并且你的机器是Apple Silicon。如果你只是想"体验一下DeepSeek",去用官方聊天界面,10秒钟就能得到比它好一个数量级的输出。
如果你是团队/企业
不推荐用于任何生产路径,推荐用于内部技术培训。 条件很清晰:如果你们的场景是"让5人以上的算法团队真正理解MoE架构",这个项目的培训ROI极高——一次数小时的实跑加一张负载均衡对照图,胜过三小时的论文串讲。如果你们的场景是"给产品接一个私有化模型",请立刻转向32B级蒸馏模型或合规的托管API:单张消费级GPU可覆盖多数常见业务场景[1],而V3全量权重的自托管门槛是多卡高端GPU、成本高昂[1]。
如果你是创业者/竞争者
机会在"复现之后"的四个缺口,威胁在于这个缺口正在被快速填平。 机会清单:ROCm/CUDA版本的同等可读复现(社区呼声最高)、从极小参数到1B–7B的中间档位可训练脚手架、把架构实验与评测流水线打通的工具、面向企业的"架构理解+选型决策"培训产品。威胁清单:官方或大厂随时可能发布教学级参考实现;框架团队(Flax/Equinox)可能把类似示例纳入官方文档。进场的时机判断:现在进场做ROCm版本仍有6–12个月窗口,做通用教学平台则已经偏晚。
如果你是投资人
这个具体项目不适合作为投资标的——它没有公司、没有收入、没有可投资实体。 但它是一个有价值的方向信号:它证明了"前沿架构的可理解性"存在真实且活跃的需求(在技术社区获得较高关注与较多正面评价)。你该看的指标不是这个项目的star数,而是:围绕"LLM架构教学与工程化中间层"是否出现了有商业模式的公司,具体观察三项——是否有团队在做企业级MoE架构咨询、是否有产品把"可读参考实现+可扩展训练栈"打包、以及AMD/ROCm生态的JAX支持进度(这是需求侧最明确的未满足信号)。
未来6–12个月的走向
三条路径,按概率排序:
- 沉淀为长期参考(概率最高)
:热度在2–4周内回落,仓库保持低频率维护,成为"讲MLA/MoE时会被引用"的经典教学材料。这是多数优质教学项目的归宿,也是最好的结局。 - 社区分叉扩展(概率中等)
:出现ROCm/CUDA分支或参数规模扩展分支,原作者不主导,项目以"家族"形式延续。信号是未来3个月内是否出现首个有实质提交的fork。 - 被官方或框架吸纳(概率较低)
:DeepSeek或JAX生态将其纳入官方文档示例。一旦发生,独占性归零,但影响力反而最大化。
给所有人的一句话建议:现在就去跑一次默认配置,几小时后你会得到一张专家负载图——那张图能告诉你的事,比这份报告剩下的所有文字都多。
参考文献
[1] DeepSeek: как запустить локально на своём сервере[1] [2] DeepSeek V3 Review 2026: Benchmarks, Status & Migration[2] [3] DeepSeek локально через Ollama при установке 2026[3] [4] DeepSeek-V3 Technical Report - arXiv.org[4] [5] deepseek-ai/DeepSeek-V3 · Hugging Face[5] [6] DeepSeek V3 Performance Report: April 2026 GIGAGPU[6] [7] DeepSeek-V3 Technical Report - arXiv.org[7] [8] Show HN: DeepSeek V3 in ~200 lines of pure Jax - GitHub[8] [9] Show HN: DeepSeek V3 in ~200 lines of pure Jax | Hacker News[9] [10] Notes on the New Deepseek v3 | Hacker News[10] [11] DeepSeek-V3 Technical Report - vitalab.github.io[11] [12] Developer Rebuilds DeepSeek V3 in 190 Lines of Pure JAX[12] [13] DeepSeek-V3-0324 : comment exécuter... | Unsloth Documentation[13] [14] Show HN: DeepSeek V3 in ~200 lines of pure Jax - daily.dev[14] [15] DeepSeek V3.2 - API 요금 및 벤치마크 | OpenRouter[15] [16] DeepSeek V3 vs Llama 4 vs Qwen 3 (2026): The Open-Weight Comparison[16] [17] DeepSeek V4 Explained: V4-Pro 1.6T vs V4-Flash 284B (2026)[17] [18] Models & Pricing | DeepSeek API Docs[18] [19] DeepSeek Statistics 2026: Users, Training Cost, Market Share[19] [20] FREE DeepSeek V4.1 Flash API – No Credit Card Required![20] [21] deepseek-v3-jax 复现文档(README 摘录)[21]
引用链接
- [1] DeepSeek: как запустить локально на своём сервере: https://n202.ru/blog/deepseek-local-deploy
- [2] DeepSeek V3 Review 2026: Benchmarks, Status & Migration: https://deepseekai.guide/reviews/deepseek-v3-review/
- [3] DeepSeek локально через Ollama при установке 2026: https://habab.ru/deepseek-lokalno-ollama
- [4] DeepSeek-V3 Technical Report - arXiv.org: https://arxiv.org/pdf/2412.19437v2
- [5] deepseek-ai/DeepSeek-V3 · Hugging Face: https://huggingface.co/deepseek-ai/DeepSeek-V3
- [6] DeepSeek V3 Performance Report: April 2026 GIGAGPU: https://gigagpu.com/deepseek-v3-performance-report-april-2026/
- [7] DeepSeek-V3 Technical Report - arXiv.org: https://arxiv.org/html/2412.19437v2
- [8] Show HN: DeepSeek V3 in ~200 lines of pure Jax - GitHub: https://github.com/Vaibhaav-Tiwari/deepseek-v3-jax
- [9] Show HN: DeepSeek V3 in ~200 lines of pure Jax | Hacker News: https://news.ycombinator.com/item?id=50497589
- [10] Notes on the New Deepseek v3 | Hacker News: https://news.ycombinator.com/item?id=42575882
- [11] DeepSeek-V3 Technical Report - vitalab.github.io: https://vitalab.github.io/article/2025/02/11/DeepSeekV3.html
- [12] Developer Rebuilds DeepSeek V3 in 190 Lines of Pure JAX: https://todayforai.com/en/items/art-17450c98-68b
- [13] DeepSeek-V3-0324 : comment exécuter... | Unsloth Documentation: https://unsloth.ai/docs/fr/modeles/tutorials/deepseek-v3-0324-how-to-run-locally
- [14] Show HN: DeepSeek V3 in ~200 lines of pure Jax - daily.dev: https://daily.dev/posts/show-hn-deepseek-v3-in-200-lines-of-pure-jax-kbhocw9em
- [15] DeepSeek V3.2 - API 요금 및 벤치마크 | OpenRouter: https://openrouter.ai/ko/deepseek/deepseek-v3.2
- [16] DeepSeek V3 vs Llama 4 vs Qwen 3 (2026): The Open-Weight Comparison: https://appscale.blog/en/blog/deepseek-v3-vs-llama-4-vs-qwen-3-open-weight-comparison-2026
- [17] DeepSeek V4 Explained: V4-Pro 1.6T vs V4-Flash 284B (2026): https://deepseek.ai/deepseek-v4
- [18] Models & Pricing | DeepSeek API Docs: https://api-docs.deepseek.com/quick_start/pricing/
- [19] DeepSeek Statistics 2026: Users, Training Cost, Market Share: https://axis-intelligence.com/deepseek-statistics/
- [20] FREE DeepSeek V4.1 Flash API – No Credit Card Required!: https://www.youtube.com/watch?v=syDGJC3Usy0
- [21] deepseek-v3-jax 复现文档(README 摘录): https://github.com/Vaibhaav-Tiwari/deepseek-v3-jax/blob/main/README.md