
 研报速递
主流深度学习模型类别调研报告(2024–2026)· 上篇
——类别全景与分类深析(第1–8章)
报告日期:2026年9月21日 调研窗口:2024年9月—2026年9月
摘要
本报告以 2024 年 9 月(OpenAI 发布 o1,推理时计算成为继参数与数据之后的第三扩展轴)至 2026 年 9 月为观察窗口,将主流深度学习模型划分为通用大语言模型(LLM)、推理模型、向量嵌入、多模态大模型、图像生成、视频生成、语音、世界模型与联合嵌入预测架构(JEPA)、端侧小模型、代码/Agent 共十大类别,并横向覆盖架构演进与算力技术栈。方法上采用”十二维度并行深度调研+跨维度交叉验证”两阶段流程,全部定量论断执行 High/Medium/Low/Conflict Zone 四级置信度分级,来源冲突项按裁定口径显式标注。
核心发现可归纳为五点。其一,混合专家(Mixture-of-Experts,MoE)稀疏化与推理时计算是贯穿全局的两大架构主线:旗舰总参数从 671B 激进增长至 2.8T(Kimi K3,2026 年)而激活参数固定于 3B–104B,激活率压缩至 3%–5%;推理优化模型流量份额两年内从近乎零升至过半(单一平台数据集口径)。其二,训练成本约 2.4 倍/年上涨与推理价格 50–200 倍/年坍塌形成”剪刀差”,利润上移至 Agent 编排与应用层。其三,中国开源生态以算法-系统协同的效率创新对冲算力封锁,OpenRouter 上中国厂商 token 份额达 46.4%,在 OpenRouter 平台口径下已近半壁江山(该平台样本偏开发者与价格敏感用户,不代表全市场)。其四,统一 omni 架构系统性吞噬专用模型,幸存者仅限经济学或延迟结构性占优的品类。其五,端云杠铃分化:万亿总参云端旗舰与 1B–14B 端侧家族两端强化,中间尺寸稠密模型被掏空。
各类别 Top3 速览(评选依据见第 2 章表 2):通用 LLM——GPT-5.2、Gemini 3 Pro、Claude Opus 4.5 三分天下;推理模型——o 系列开创品类,DeepSeek-R1 以 29.4 万美元 RL 边际成本开源复现,QwQ-32B 以小博大;向量嵌入——Qwen3-Embedding 开源登顶、Gemini Embedding 2 闭源标杆、BGE-M3 生态之王;多模态——Gemini 3 Pro、GPT-4o/GPT-5、Qwen3-VL 领跑原生 omni;图像生成——FLUX、Nano Banana、GPT Image 三强并立;视频生成——可灵、Veo 3、Sora 2,其中 Sora 已因单位经济崩溃于 2026 年 3 月宣布关停;语音——GPT-4o Realtime、ElevenLabs v3、豆包实时语音;世界模型/JEPA——V-JEPA 2、Genie 3、Cosmos;端侧小模型——Gemma 3/3n、Phi-4、Qwen3 小尺寸;代码/Agent——Claude 编程线、Codex 与开源阵营(Kimi K2.x/DeepSeek-V4/Qwen3-Coder)。
关键词:深度学习;大语言模型;向量嵌入;世界模型;JEPA;混合专家;推理时计算
1. 调研范围、方法与数据来源
1.1 调研范围
1.1.1 时间窗口2024-09至2026-09;覆盖十大模型类别+横向技术栈维度
本报告观察窗口为2024年9月至2026年9月。起点具有明确行业意义:2024年9月12日OpenAI发布o1模型,推理时计算(test-time compute)成为继参数与数据之后的第三条能力扩展轴,重塑了此后两年的技术路线与成本结构;终点为调研截止时点。
调研覆盖十大模型类别:通用大语言模型(LLM)、推理模型、向量嵌入(Embedding)模型、多模态视觉语言模型(VLM)、图像生成、视频生成、语音、世界模型与联合嵌入预测架构(JEPA)、端侧小模型、代码-Agent模型;另设”技术栈与算力”横向维度,考察作用于所有类别的框架、推理引擎与芯片算力共性变量。十大类别构成本报告第3至12章的分章对象。
1.1.2 评估维度定义:流行程度、模型规模、计算速度、训练难度、技术特征、技术栈、Top3代表
为保证类别间可比,每个类别按七个统一维度评估。流行程度以可量化采用度指标度量,包括活跃用户、Hugging Face下载量、API token份额与年化收入,并显式标注统计口径(周活跃WAU与月活跃MAU不可互比)。模型规模以总参数与激活参数双口径记录,单位为B(十亿参数),混合专家(MoE)模型二者缺一不可,如DeepSeek-V3为671B总参、37B激活。计算速度以端到端延迟(毫秒)或吞吐(token/s)度量。训练难度以算力消耗(GPU小时)与边际训练成本(美元)刻画,如DeepSeek-V3末次训练消耗2.788M H800 GPU小时。技术特征概括架构与训练方法的核心创新;技术栈记录配套框架与部署生态;Top3代表给出该类别窗口内综合最强的三个模型及关键指标。
1.2 方法
1.2.1 十二维度并行深度调研+交叉验证(四级置信度分级:High/Medium/Low/Conflict Zone)
调研采用”分维度并行挖掘+跨维度交叉验证”两阶段方法。第一阶段按十大类别加技术栈共12个维度(dim01–dim12)分别形成维度简报;第二阶段对全部定量论断执行交叉验证,按证据链强度实施四级置信度分级:High为至少两条相互独立的来源链一致;Medium为单一权威来源链(官方披露、一手论文、平台方数据)无第二来源复核;Low为弱来源;Conflict Zone为来源间数字或结论直接冲突。正文定量论断均以[^dimNN-N^]格式标注原始出处(NN为维度文件号,N为该文件内来源编号),并按裁定置信度表述;未特别标注者默认不低于Medium。此约定适用于全文各章。
1.2.2 来源分级(T1:官方/arXiv/财报/权威研究;T2:主流媒体;拒绝内容农场)与20条显式冲突项的处理原则(官方vs实测、口径差异须注明)
来源按两级采信:T1级含厂商官方公告与技术博客、arXiv一手论文、上市公司财报、权威研究机构(Epoch AI、SemiAnalysis、METR等)原始研究;T2级为主流媒体的转引报道;内容农场与无署名聚合站一律不予采信。交叉验证共识别20条显式冲突项,处理遵循两条原则:其一,官方宣称与第三方实测冲突时优先采信实测并保留争议注记,如NVIDIA宣称Blackwell推理提升30倍而SemiAnalysis等精度对比实测约18倍,本报告采信后者并注明前者含FP4量化与机架级互联红利;其二,口径差异导致的表面冲突不强行调和,引用时显式注明口径。所有Conflict Zone项在正文按其裁定口径表述并标注冲突背景,供读者复核。
2. 深度学习模型分类学总览
本章为全报告的导航性总览:先给出将窗口期(2024-09 至 2026-09)内主流深度学习模型划分为十大类别的分类框架及其技术血缘,再以两张速查表呈现全景,最后讨论类别层面的生灭动态。各类别的细节论证分别留待第 3–12 章。
2.1 分类框架
2.1.1 按任务模态与训练范式的二维分类法
本报告沿”任务模态”(输入与输出信号的形态)与”训练范式”(模型学习目标的数学形式)两个轴,将十大类别归为三大簇。理解类以符号化理解为产出目标,包括通用大语言模型(Large Language Model,LLM)、推理模型(Reasoning Model)、向量嵌入模型(Embedding Model)与多模态大模型(Vision-Language Model / Omni Model)四者:前两者以文本 token 为输入输出,嵌入模型把任意输入压缩为稠密向量,多模态模型则在统一架构内理解文本、图像、音频与视频。生成类以高维连续信号为产出,包括图像生成、视频生成与语音模型三类,其共同特征是输出空间的维度与信息量远高于文本,推理成本随之结构性放大——10 秒 720p 视频生成需 80GB 以上显存,成本比文本高数个数量级。表征-规划类即世界模型与联合嵌入预测架构(Joint-Embedding Predictive Architecture,JEPA),既不以符号作答也不生成可观测信号,而是在潜空间(latent space)预测世界状态演化以支持规划与控制,V-JEPA 2 以 1.2B 参数实现单动作 16 秒的规划(对比生成式 Cosmos 的 4 分钟)是该范式的标志。
端侧小模型(Small Language Model,SLM)与代码/Agent 模型是按部署约束与任务垂直度划出的两个横切类别:前者的底座是理解类模型经蒸馏与量化下沉至 1B–14B 黄金区间,后者是 LLM 在软件工程垂直场景的强化学习特化。二者在底座技术上均隶属理解类,但其经济学与工程约束足以构成独立类别。
2.1.2 类别间的技术血缘
十大类别共享同一条技术主干。其一,Transformer 注意力架构是全部类别的公共底座,且混合专家(Mixture-of-Experts,MoE)稀疏化在窗口期内从 LLM 技巧演变为贯穿文本、视觉、语音、代码、检索、端侧六条产品线的通用扩容定律——旗舰总参数激进增长至 1.04T(Kimi K2,2025 年;2026 年 Kimi K3 已推进至 2.8T、激活约 104B)而激活参数固定在 3B–104B,激活率从约 10% 压缩到 3%–5%。其二,生成与建模任务收敛为三大范式:自回归(LLM、GPT-4o 图像生成、语音 codec token 化)、扩散/流匹配(图像生成的 DiT/MMDiT + Rectified Flow、视频生成的 DiT + Flow Matching)与潜空间预测(JEPA 路线)。其三,类别间存在明确的”借壳”血缘:嵌入模型的最高水平全部由生成式 LLM 蒸馏改造而来(Qwen3-Embedding、Gemini Embedding);推理模型是 LLM 叠加可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards,RLVR)后训练的产物;代码模型则是 LLM 的垂直化分支。因此本报告的类别边界是产品与经济边界,而非架构边界。
2.2 全景速览
2.2.1 表 1:十大类别 × 关键维度总览
表 1 十大模型类别关键维度总览(2024-09 至 2026-09)
类别 | 典型规模(参数) | 单位成本量级 | 训练难度评级 | 成熟度 |
通用 LLM | 开源旗舰 671B–1.04T 总参 / 32.6–37B 激活(1.04T 为 2025 年最大开放权重;2026 年 Kimi K3 已推进至 2.8T、激活约 104B);闭源未披露 | API $1.25–$14 / 百万 token(GPT-5→GPT-5.2) | 极高:前沿训练成本 2.4×/年增长,2027 年单次破 $10 亿 | 成熟(消费+企业双市场) |
推理模型 | 与 LLM 同源(R1 为 671B/37B;QwQ-32B 为 32B 稠密) | 推理开销为普通查询 5–50×;R1 API $0.55/$2.19 约为 o1 的 1/27 | 高:RLVR 后训练;R1 的 RL 边际训练仅 $29.4 万 | 快速成熟(推理流量份额超 50%,单数据集口径) |
向量嵌入 | 0.1B–8B,比 LLM 小 1–3 个数量级 | Gemini Embedding $0.20 / 百万 token;自托管边际近零 | 低:对比学习+大模型蒸馏,成本远低于 LLM | 成熟(RAG 基础设施) |
多模态 VLM/Omni | 视觉编码器 0.3B–6B + LLM 底座(开源旗舰 235B-A22B) | 与 LLM 同量级;视觉 token 占序列 50–80% 为主要瓶颈 | 高:原生多模态需万亿 token 级混合训练 | 成长后期(GPT-4o 确立范式) |
图像生成 | 8B(SD3.5)→12B(FLUX.1)→32B(FLUX.2) | 单图分币级;步数蒸馏后 4 步 ≤0.5 秒 | 中:千卡级算力、周至月级周期 | 成熟,商业模式分化 |
视频生成 | 闭源旗舰未披露,外部估算矛盾,采信”数十亿量级”(低置信) | Veo 3 降价后 $0.15–$0.40 / 秒;Sora 单条 10 秒约 $1.3(分析师估算) | 高:千卡 H100、月级周期;注意力随时长平方放大 | 成长早期,单位经济多数未打平 |
语音 | 0.5B–8B;Whisper large-v3 为 1.55B | 端到端对话延迟 232–320ms(对比级联管线 1–2 秒) | 中:训练数据已达千万小时级 | ASR 成熟,端到端语音对话(S2S)成长中 |
世界模型 / JEPA | 1.2B(V-JEPA 2)至 14B(Cosmos);Genie 3 约 11B 为单一来源估算 | 规划 16 秒/动作,约为生成式路线的 1/15(论文口径) | 高:百万小时级视频自监督预训练 | 早期($10 亿级融资驱动) |
端侧小模型 | 黄金区间 1B–14B,最小 270M | 端侧推理零边际成本;2GB 内存可跑多模态 | 低至中:蒸馏+量化为主,“密度定律”下同等智能参数量每约 3.5 个月减半 | 成熟(Qwen 家族累计下载 30 亿+,全渠道口径) |
代码 / Agent | 旗舰衍生;开源专用旗舰 480B-A35B(Qwen3-Coder) | 约 $13 / 开发者 / 活跃日、$150–250 / 月 | 高:RLVR + 软件工程环境强化学习 | 商业化最成功的垂直(Claude Code 年化 $25 亿) |
表 1 揭示的结构性规律有三。第一,规模与成本并非单调相关:嵌入与端侧模型以 0.1B–14B 的小规模服务最高频的负载,而万亿级 MoE 的总参数只决定显存占用、激活参数才决定算力消耗,“激活参数定算力、总参数定显存”成为跨类别通用的部署第一性原理。第二,训练难度与成熟度明显倒挂:训练最”便宜”的嵌入与端侧类别反而最成熟,训练最昂贵的视频生成与世界模型商业化最不确定——Sora 因单位经济崩溃于 2026-03 宣布关停,与可灵推理毛利打平形成鲜明对照。第三,成熟度最高的三个类别(LLM、嵌入、代码)恰好都落在理解类,印证了符号化输出的单位经济学天然优于高维连续信号输出。
2.2.2 表 2:各类别 Top3 代表模型速查
表 2 十大类别 Top3 代表模型速查表(评选依据:榜单头部 × 采用度 × 技术代表性,详见第 3–12 章)
类别 | 模型 | 机构 | 发布时间 | 开源性 | 关键指标 |
通用 LLM | GPT-5.2 | OpenAI | 2025-12-11 | 闭源 | SWE-bench Verified 80.0%;ChatGPT 约 10 亿 WAU(官方口径) |
通用 LLM | Gemini 3 Pro | 2025-11-18 | 闭源 | LMArena 1501 Elo(首个破 1500);GPQA 91.9% | |
通用 LLM | Claude Opus 4.5 | Anthropic | 2025-11-24 | 闭源 | SWE-bench Verified 80.9%,首个破 80% |
推理模型 | o 系列 / GPT-5 Thinking | OpenAI | 2024-09-12 起 | 闭源 | 品类开创者;GPT-5 AIME 2025 无工具 94.6% |
推理模型 | DeepSeek-R1 | DeepSeek | 2025-01-20 | 开源(MIT) | AIME’24 79.8%;RL 成本 $29.4 万(Nature 封面) |
推理模型 | Qwen3-Thinking / QwQ-32B | 阿里巴巴 | 2025-03 / 2025-04 | 开源(Apache 2.0) | QwQ-32B 以 32B 达 AIME’24 79.5,逼近 671B 的 R1 |
向量嵌入 | Qwen3-Embedding | 阿里巴巴 | 2025-06 | 开源(Apache 2.0) | MTEB 多语言 70.58,开源第一 |
向量嵌入 | Gemini Embedding / 2 | 2025-03 / 2026-03 | 闭源 API | 三榜登顶(68.32);二代为首个五模态统一向量模型 | |
向量嵌入 | BGE-M3 及新一代 | 智源 BAAI | 窗口前基座 + 窗口内迭代 | 开源(MIT) | HF 累计下载 1.32 亿+,自托管生态之王 |
多模态 VLM/Omni | Gemini 3 Pro | 2025-11-18 | 闭源 | MMMU-Pro 81%,原生全模态标杆 | |
多模态 VLM/Omni | GPT-4o → GPT-5 | OpenAI | 2024-05 / 2025-08 | 闭源 | 确立原生 omni 产品范式;MMMU 84.2% |
多模态 VLM/Omni | Qwen3-VL | 阿里巴巴 | 2025-09/10 | 开源(Apache 2.0) | 开源最强 VLM,dense 2B–32B + MoE 235B-A22B 全尺寸 |
图像生成 | FLUX.1 / FLUX.2 | Black Forest Labs | 2024-08 / 2025-11 | dev 版开源 | 12B→32B;LMArena 文生图前十独占三席 |
图像生成 | Nano Banana 系列 | 2025-08-26 起 | 闭源 | 编辑榜 171 分 Elo 历史最大领先;数月 50 亿+ 作品 | |
图像生成 | GPT-4o 图像 / GPT Image | OpenAI | 2025-03-25 起 | 闭源 | 上线首周 1.3 亿用户生成 7 亿+ 张图 |
视频生成 | 可灵 Kling(1.0→3.0) | 快手 | 2024 起持续迭代 | 闭源(部分开源) | 用户 1 亿+;ARR 近 $5 亿;推理毛利打平 |
视频生成 | Veo 3 / 3.1 | Google DeepMind | 2025-05-20 | 闭源 | 首创原生音画同步;Flow 五个月 2.75 亿条视频 |
视频生成 | Sora / Sora 2 | OpenAI | 2024-12 / 2025-09-30 | 闭源 | 范式定义者;2026-03-24 宣布关停 |
语音 | GPT-4o Realtime | OpenAI | 2024-05 / 2025-08 GA | 闭源 | 音频响应最低 232ms、平均 320ms |
语音 | ElevenLabs v3 | ElevenLabs | 2025-06 | 闭源 | ARR $5 亿;41% 财富 500 强采用 |
语音 | 豆包实时语音 / Seeduplex | 字节跳动 | 2025-01 / 2026-04 | 部分开源(7B 研究版) | 全双工 210–320ms;打断准确率 97.3% |
世界模型 / JEPA | V-JEPA 2 / 2.1 | Meta | 2025-06-11 | 开源 | 1.2B 参数;零样本机器人抓取成功率 65–80% |
世界模型 / JEPA | Genie 3 | Google DeepMind | 2025-08-05 | 闭源 | 首个实时交互通用世界模型,720p/24fps |
世界模型 / JEPA | Cosmos | NVIDIA | 2025-01-06 起 | 开放权重 | 2000 万小时视频训练;4B–14B;1X/Figure/XPENG 采用 |
端侧小模型 | Gemma 3 / 3n | 2025-03-12 起 | 开放权重 | 270M–27B 全覆盖;2GB 内存跑多模态 | |
端侧小模型 | Phi-4 家族 | Microsoft | 2024-12-12 起 | 开源(MIT) | 14B 以 MMLU 84.8 比肩 70B 级 |
端侧小模型 | Qwen3 小尺寸系列 | 阿里巴巴 | 2025-04-28/29 | 开源(Apache 2.0) | 0.6B–8B 全系同尺寸 SOTA |
代码 / Agent | Claude 编程线(Claude Code + Opus 4.5→5) | Anthropic | 2025-05 起 | 闭源 | Claude Code 年化 $25 亿;约占 GitHub 公开提交 4% |
代码 / Agent | Codex + GPT-5.x-Codex | OpenAI | 2025-05 / 2025-09 | 闭源 | 同等任务 token 消耗约为 Claude Code 的 1/4 |
代码 / Agent | Kimi K2.x / DeepSeek-V4 / Qwen3-Coder | Moonshot / DeepSeek / 阿里 | 2025-07 起 | 开放权重 | DeepSeek-V4-Pro SWE-bench 80.6% 为开源最高,API 价为闭源 1/30 |
表 2 的横向阅读可得出三点观察。其一,机构集中度极高:30 个席位由 10 家机构占据,OpenAI、Google、阿里巴巴各占 5 席以上,且阿里巴巴是唯一能横跨 5 个类别 Top3 的开源厂商。其二,开源性呈梯度分布:嵌入、端侧、推理与世界模型(JEPA 侧)以开源为主力,而视频、语音对话与 omni 旗舰仍由闭源主导,开源梯度与类别的推理成本结构高度相关。其三,时间列直观呈现了品类的”年龄差”:推理模型的全部代表均晚于 2024-09,而语音与嵌入的头部仍包含窗口前基座的迭代延续,说明新品类的头部名单稳定性尚低。需要说明的是,BGE-M3、FLUX.1 等个别模型的初版略早于窗口起点,因其在窗口内的持续统治地位(下载量、榜单、生态)经各维度调研综合判定予以保留,评选理由详见相应章节。
2.2.3 类别的生灭动态
窗口期内类别边界本身处于剧烈变动中,呈现”吞噬”与”诞生”两个方向。
吞噬侧,统一 omni 架构系统性地兼并专用模型:OpenAI 正式退役 DALL-E 系列,图像生成并入 GPT-4o 的自回归统一架构;DeepSeek 放弃独立 Coder 产品线,代码能力并入主系列;端到端语音对话以 232–320ms 延迟蚕食传统级联管线(1–2 秒);Gemini Embedding 2 将五种模态统一进单一向量空间。幸存下来的专用品类均满足两个条件之一:成本或延迟结构性更低(嵌入模型单次前向编码、TTS 首包延迟),或单位经济学独立成立(Midjourney 约 $5 亿年收入、ElevenLabs ARR $5 亿)。
诞生侧,两个新类别在窗口内成形。推理模型以 o1 的发布(2024-09-12)为明确诞生日,两年内推理优化模型在 OpenRouter 流量中的份额从近乎零升至 50% 以上(同一平台数据集口径,存在单点依赖)。世界模型则由资本与路线之争共同推热:LeCun 阵营的 AMI Labs 以 $10.3 亿种子轮(估值 $35 亿)押注 JEPA 路线,World Labs 融资 $10 亿,与生成式路线(Genie 3、Cosmos)形成 $10 亿级对赌;但诚实基准 IntPhys 2 上所有模型仍接近随机水平,提示该类别距”理解世界”尚远,其成熟度评级因此为十大类别中最低。类别生灭的主要判据并非能力曲线,而是推理成本曲线与单位经济学——这一规律将在第 14、15 章展开。
3. 通用大语言模型(LLM)
通用大语言模型是本报告分析的第一个、也是体量最大的模型类别。本章建立”流行程度→模型规模→计算速度与成本→训练难度→技术特征与技术栈→Top3 代表模型”的类别分析模板,后续各章沿用同一框架。分析窗口为 2024 年 9 月至 2026 年 9 月;所有定量论断均标注来源,官方声明与第三方实测分别注明,存在口径冲突之处按交叉验证裁定表述。
3.1 流行程度
3.1.1 消费端与企业端的双轨格局
消费端,OpenAI 的 ChatGPT 仍是全球用户规模最大的 LLM 产品:2025 年 10 月 DevDay 官宣周活跃用户(WAU, Weekly Active Users)超 8 亿、API 吞吐达每分钟 60 亿 token;2026 年 2 月官宣超 9 亿 WAU,2026 年 7 月达约 10 亿 WAU。需要说明的是,另有来源称 2025 年 3 月 ChatGPT 周活”首超 1.5 亿”,与官方口径存在量级冲突;交叉验证判定该数字系功能口径或区域口径误植,本章采信官方 8 亿→9 亿→10 亿的演进序列(官方自报,未经独立审计)。Google Gemini 应用月活跃用户(MAU, Monthly Active Users)从 2025 年中的约 4 亿增至 2026 年 5 月 Google I/O 时的 9 亿以上,Google 全系产品月 token 处理量同期达约 3.2 千万亿(quadrillion),同比约 7 倍。需注意 ChatGPT 的 WAU 与 Gemini 的 MAU 统计口径不同,二者不可直接比较。中国厂商中,字节跳动豆包大模型日均 token 调用量 2025 年 12 月超 50 万亿、2026 年 3 月突破 120 万亿,为官方披露口径下的全球第三。
企业端呈现不同的竞争格局。Anthropic 走企业级路线,在企业 LLM API 市场取得约 32% 的使用率份额(2023 年约 12%),领先 OpenAI(25%)与 Google(20%);其年化收入从 2025 年初约 10 亿美元增至 2026 年 4 月的 300 亿美元以上,其中 Claude Code 年化收入超 25 亿美元。该份额数据为单一学术二手引用链,置信度低于参数与日期类数据,引用时应附来源限定。
3.1.2 开源侧:中国厂商拿下近半壁江山
开源生态的权力中心在窗口内发生转移。2025 年,阿里 Qwen 取代 Meta Llama 成为 HuggingFace 下载量最大的模型家族,仅 Qwen2.5 系列(0.6B–7B)当年合计下载即超 7.5 亿次,中国模型占头部开源模型下载量的 45% 以上。第三方路由平台 OpenRouter 的实测 token 流量提供了另一视角:中国开源模型份额从 2024 年底约 1.2% 升至 2025 年部分周的近 30%(全年均值约 13%);至 2026 年 6 月,中国厂商(DeepSeek、小米、MiniMax、腾讯、Qwen)合计占平台周 token 量的 46.4%,其中 DeepSeek 单家占近五分之一,超过美国三家厂商(Anthropic、Google、OpenAI)合计的 35.7%。两点口径警示:其一,OpenRouter 样本偏向开发者与价格敏感用户,不代表全市场;其二,另有”豆包占中国公有云大模型调用量 46.4%“的统计口径(火山引擎披露),与本文 46.4%(OpenRouter 中国厂商份额)指标的样本、市场、时点均不同,两个 46.4% 为数字巧合,不可互引。单品层面,Kimi K2 发布当日登顶 Chatbot Arena 开源模型榜首,至 2026 年 5 月 HuggingFace 累计下载超 230 万次。
3.2 模型规模
3.2.1 MoE 主流化与激活率 3–5% 范式
混合专家(MoE, Mixture-of-Experts)架构在窗口内从可选项变为旗舰标配:DeepSeek-V3(671B 总参数/37B 激活,每层 1 共享专家+256 路由专家、每 token 激活 8 个)、Kimi K2(1.04T 总参数/32.6B 激活,384 专家选 8)、Qwen3-235B-A22B(235B/22B)、GLM-4.5(355B/32B)、Llama 4 Scout/Maverick(109B/400B 总参、均 17B 激活) 全部采用稀疏 MoE;GPT-5.x、Claude 4.x、Gemini 3 等闭源旗舰普遍被认为同为 MoE,但厂商均未披露参数量。MoE 的核心收益是容量与每 token 计算成本的解耦:总参数决定知识容量与显存占用,激活参数决定推理算力。窗口内激活率(激活参数/总参数)从约 10% 压缩至 3–5% 区间——Kimi K2 约 3.1%、Llama 4 Scout 约 15.6% 而 Maverick 约 4.3%、DeepSeek-V3 约 5.5%——“更低激活率=更优每 FLOP 质量”已被逐家验证。Kimi K2(1.04T)为 2025 年最大的开放权重模型,2026 年 Kimi K3 已将该纪录推进至 2.8T(激活约 104B),而 Meta 预告的约 2T 参数 Llama 4 Behemoth 始终未发布。
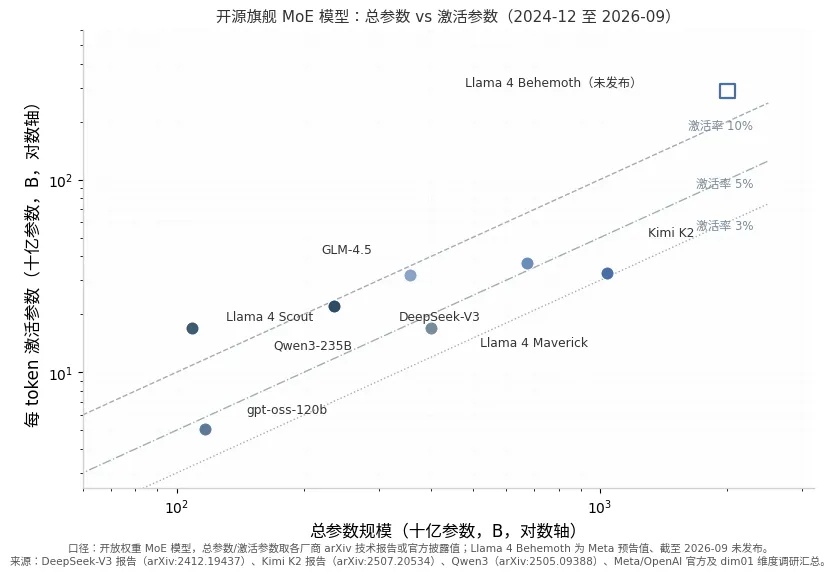
图3-1 开源旗舰 MoE 模型总参数与激活参数散点
图 3-1 以双对数坐标展示主要开源 MoE 模型的”总参数—激活参数”分布:数据点整体向右下方迁移(总参数激增至万亿级、激活参数收敛于 17B–37B),直观呈现激活率 3–5% 范式的形成;空心方块标记的 Llama 4 Behemoth 为 Meta 预告值,其跳票亦反映超大规模 MoE 训练的工程门槛。
3.2.2 上下文窗口竞赛
上下文窗口在两年内完成”128K→1M→10M”三级跳:2025–2026 年主流前沿规格为 GPT-5/5.2 的 400K(API)、Claude 系列标准 200K(Sonnet 4 起提供 1M beta)、Gemini 2.5/3 Pro 的 1M、Grok 4 的 256K(4.1 起 2M);开源侧 Qwen3-Next 原生 262K 可扩至 1M,Llama 4 Scout 宣称 10M。需注意 Scout 的 10M 被社区普遍认为属”纸面指标”,其超长程检索质量未经充分验证;窗口数字的快速膨胀部分依赖稀疏注意力与位置编码外推等工程手段,有效上下文与标称上下文之间存在差距。
3.3 计算速度与成本
3.3.1 API 定价通缩与吞吐实测
表 3-1 汇总窗口期末旗舰模型的官方 API 牌价与第三方推理吞吐实测。整体呈现”能力上行、单价下行”的剪刀差:Claude Opus 4.5 较前代 Opus 4.1($15/$75)降价约 67%,而 DeepSeek、GLM 等开源系 API 定价仅为闭源旗舰的 1/10 至 1/30。
表 3-1 旗舰 LLM API 定价(美元/百万 token)与第三方吞吐实测
模型 | 输入价 | 输出价 | 上下文 | 备注 |
GPT-5 | $1.25 | $10.00 | 400K | mini 档 $0.25/$2 |
GPT-5.2 | $1.75 | $14.00 | 400K | 较 5.1 提价 1.4×(罕见涨价) |
Claude Opus 4.5 | $5.00 | $25.00 | 200K | 较 Opus 4.1 降价约 67% |
Gemini 3 Pro | ~$2.00 | ~$12.00 | 1M | 分档定价,>200K 加价 |
Grok 4 | $3.00 | $15.00 | 256K | >128K 升至 $6/$30 |
Kimi K2.6 | $0.73 | $3.49 | 256K | 2026 年挂牌价 |
DeepSeek-V3.x | ~$0.27 | ~$1.10 | 128K | OpenRouter 挂牌 |
GLM-4.5 | $0.08 | $0.24 | 128K | 智谱官方低价策略 |
注:表 3-1 定价与上下文数据来源见本节正文引用。
价格通缩的幅度由三家独立机构交叉印证:a16z 测算 GPT-3 级质量单价三年下降约 1000 倍($60→$0.06/百万 token);Stanford HAI《AI Index 2025》测得 GPT-3.5 级质量 18 个月下降 280 倍($20→$0.07);Epoch AI 测得跨基准中位年降约 50 倍、2024 年 1 月后加速至约 200 倍/年,此即”LLMflation”现象。但 Jevons 悖论同时显现:2026 年 token 单价同比降约 50% 而总消耗量同比增约 450%,企业 LLM API 支出半年内从 35 亿美元翻倍至 84 亿美元。表 3-1 还揭示定价策略分化:闭源旗舰以”分层定价+effort 参数”调节算力消耗,开源系则以接近成本线的定价换取份额——价格本身已成为竞争武器而非单纯成本加成。
3.3.2 推理框架与硬件代际
吞吐侧,第三方 2026 年基准显示:H100 上运行 Llama-3.1-70B FP8(张量并行 TP=4),vLLM 约 2,800 token/s、SGLang 约 2,900 token/s、TensorRT-LLM 约 3,400 token/s,后者峰值领先约 10–25%(不同基准版本间幅度有波动,方向一致);SGLang 的 RadixAttention 前缀复用机制在共享前缀负载下较 vLLM 快约 29%(Llama-3.1-8B:16,200 vs 12,500 token/s);DeepSeek-R1 671B 在 8×H100(专家并行 EP=8、FP8、SGLang)上约 1,100 token/s。硬件代际的影响更为显著:SemiAnalysis InferenceX 实测(DeepSeek-R1、FP8)GB200 NVL72 单芯片 6,310 token/s、每百万 token 成本 $0.08,对比 H100 的 554 token/s、$0.59,成本下降约 86%;NVIDIA 官方则宣称 GB300 NVL72 推理成本低至 $0.12/百万 token、较 Hopper 代际降 35 倍——官方口径含 FP4 量化与机架级互联红利,与 SemiAnalysis 公平精度对比的约 18 倍(H200→GB200)须分别标注。
3.4 训练难度
3.4.1 训练成本量级:边际成本与全口径的鸿沟
DeepSeek-V3 技术报告披露其全部训练(预训练+上下文扩展+后训练)仅耗 278.8 万 H800 GPU 小时,按 $2/GPU 小时租金约合 558 万美元,2048 卡 H800 集群预训练 14.8 万亿 token 用时不足两个月。该数字仅为末次成功训练的边际成本,官方明确不含前期研究与消融;SemiAnalysis 解构估计 DeepSeek 实际服务器资本开支约 16 亿美元、持有约 5 万颗 Hopper 级 GPU。对照之下,GPT-4 级训练成本的业界估计存在口径分层:Epoch AI 摊销硬件口径约 7,800 万美元,而含研发人力与失败实验的全口径估计为 1–2 亿美元。Epoch AI 同时测算前沿模型训练成本以约 2.4 倍/年的速度增长,预计最大单次训练 2027 年突破 10 亿美元 ——供给侧门槛的抬高正把”前沿俱乐部”压缩至个位数厂商。工程效率方面,模型算力利用率(MFU, Model FLOPs Utilization)经验值为:7B 稠密模型 45–55%、70B 40–50%、MoE 模型因 all-to-all 通信拖累降至 30–40%;昇腾 910C 集群训练 MFU 约 30%,对比 H100 集群约 55%。
3.4.2 数据规模与后训练范式
预训练数据规模同步膨胀:Llama 3 用 15 万亿 token(2024)、Llama 4 增至约 40 万亿(2025);DeepSeek-V3 用 14.8 万亿;Qwen3 用约 36 万亿(覆盖 119 种语言);Kimi K2 用 15.5 万亿但强调 token 效率——其 Muon 优化器的 token 效率约为 AdamW 的 2 倍,并借 MuonClip(Muon+QK-Clip 注意力 logit 裁剪)实现 15.5 万亿 token 全程零 loss spike,被视为万亿参数 MoE 训练的工程里程碑。后训练范式则从”SFT(监督微调)+RLHF(基于人类反馈的强化学习)“两段式演进为三段式:SFT 冷启动→RLHF/DPO 偏好对齐→RLVR(可验证奖励强化学习)。DeepSeek-R1(2025-01-20)证明纯 RL 即可涌现推理能力,其 GRPO(组相对策略优化)算法省去奖励模型与 critic 网络,成为 2025 年最具影响力的后训练创新;据 Nature 发表的同行评审版本披露,R1 的 RL 训练仅花费约 29.4 万美元。至 2026 年,GRPO/RLVR 已成为标配,Kimi K2 等进一步将 RLVR 与大规模智能体(agentic)数据合成管线结合。
3.5 技术特征与技术栈
3.5.1 架构收敛与工程栈分层
架构层面,Transformer 解码器仍是绝对主干,叠加三个结构性变化:其一,MoE 普及(见 3.2.1);其二,注意力变体分化——DeepSeek 系采用 MLA(多头潜在注意力,低秩 KV 联合压缩,KV cache 较 MHA 压缩约 93% 而质量持平),Qwen/Llama 采用 GQA(分组查询注意力),DeepSeek-V3.2-Exp 进一步引入稀疏注意力 DSA 以降低长上下文成本;其三,混合推理路由成为标配——GPT-5 的”路由+Thinking”双模式、Qwen3 的 thinking/non-thinking 切换、Claude 的 extended thinking 与 effort 参数,本质上都是把”推理时计算量”变成可调旋钮。
训练栈呈分层分工:NVIDIA Megatron-Core 以张量/流水线/专家/上下文多维并行成为超大模型生产首选;微软 DeepSpeed 以 ZeRO 显存分片与 ZeRO-Infinity 卸载见长;PyTorch FSDP/FSDP2 是 7B–70B 微调的默认选择;万卡级厂商普遍走向自研(DeepSeek HAI-LLM、字节豆包自研栈);对齐环节常用 veRL、OpenRLHF、HF TRL。推理栈则收敛为 vLLM(硬件与模型覆盖最广的生产默认)、SGLang(前缀复用与大规模 MoE 最优)、TensorRT-LLM(NVIDIA 独享的峰值吞吐)三强,HuggingFace TGI 已于 2025 年 12 月转入维护模式。硬件主力从 H100(989 BF16 TFLOPS)经 H200 演进至 Blackwell B200/GB200(192GB HBM3e、机柜级 NVL72),Google 则以 TPU v6/v7 构筑第二极。
3.6 Top3 代表模型
3.6.1 闭源三强与开源代表
选取依据:榜单头部位置(LMArena、Artificial Analysis 智能指数、SWE-bench Verified)、采用度(用户/API/下载)与技术代表性三维度综合。
表 3-2 通用 LLM Top3 代表模型(截至 2026-09)
排名 | 模型(机构) | 发布时间 | 关键指标 | 上下文 | API 价(输入/输出,$/1M token) |
1 | GPT-5.2(OpenAI) | 2025-12-11 | SWE-bench Verified 80.0%、SWE-bench Pro 55.6%(发布时 SOTA)、GPQA Diamond 93.2%(Pro) | 400K | $1.75/$14 |
2 | Gemini 3 Pro(Google) | 2025-11-18 | LMArena 1501 Elo(首个破 1500)、GPQA 91.9%、HLE 37.5%(无工具)、AA 智能指数 73 | 1M | $2/$12 |
3 | Claude Opus 4.5(Anthropic) | 2025-11-24 | SWE-bench Verified 80.9%(首个破 80%)、AA 智能指数 70、Aider Polyglot 89.4% | 200K(1M beta) | $5/$25 |
三强的差异化定位清晰可见:GPT-5.2 是在 Gemini 3 竞争压力下以”code red”节奏加速发布的回应之作,胜在生态规模(ChatGPT 约 10 亿 WAU)与编程基准的全面性;Gemini 3 Pro 凭原生多模态与 1M 上下文在 LMArena 成为首个突破 1500 Elo 的模型,Artificial Analysis 智能指数 73 分发布时居首;Claude Opus 4.5 则以 SWE-bench Verified 80.9% 成为首个突破 80% 的模型,叠加企业 API 份额第一与 Claude Code 的商业化势能,确立了”编程与企业级”的生态位。需提示基准通胀背景:LMArena Elo 已明显通膨,其与 LiveBench 排名相关性为 0.91,任何单一榜单分数都不足以支撑全面优劣结论。
开源侧并列推荐两家:DeepSeek-V3/R1/V3.2 谱系以 671B/37B MoE+MLA、约 558 万美元边际训练成本与 MIT 协议重塑了开源成本曲线,R1 证明纯 RL 涌现推理并登上 Nature,OpenRouter 实测单家 token 份额近五分之一居首;Kimi K2 系列以 1.04T/32.6B 成为全球首个开放权重万亿参数模型,MuonClip 优化器实现 15.5 万亿 token 零 loss spike,SWE-bench Verified 65.8% 为非思考模式开源 SOTA,后续 K2 Thinking(256K 上下文)与 K2.5(原生多模态)延续迭代。开源阵营与闭源旗舰的榜单差距在窗口内已缩小至个位数百分点,构成对闭源定价体系的结构性压力。
4. 推理模型(Reasoning)
第3章所述的通用大语言模型以”预训练规模+后训练对齐”为能力主轴;本章考察的推理模型(Reasoning Model)则开辟了一条新的扩展轴——推理时计算(test-time compute),即模型在作答前显式生成内部长思维链(Chain-of-Thought, CoT),以更多的推理时算力换取准确率。这一类别在2024-09至2026-09的两年窗口内完成了从单一产品到行业默认配置的全部演化。
4.1 品类诞生与流行程度
4.1.1 o1开创品类与流量占比的爆发
2024-09-12,OpenAI发布o1-preview与o1-mini,首次将”先思考后回答”做成主流产品,标志着推理模型品类诞生。o1的意义不仅是分数:在AIME 2024数学竞赛上,GPT-4o仅约12%–13.4%,o1单次采样即达74%,64采样多数投票达83%,千采样重排达93%(超过美国数学奥赛USAMO入围线)。同期Snell等人的理论研究证明,最优分配的推理时计算可以比单纯扩大模型参数更有效,为该路线提供了学理支撑。
流行程度方面,最硬的量化证据来自OpenRouter联合a16z发表的100万亿token真实流量研究(2026-01):路由到”推理优化模型”的token份额从2025年初的可忽略不计上升到超过50%,研究结论称”推理导向模型正在成为真实工作负载的默认路径”。需特别标注:该>50%结论为单点依赖——底层仅是OpenRouter单一平台数据,其用户偏开发者与性价比敏感群体,且与本报告第3章引用的”中国厂商token份额46.4%“共享同一数据集,引用时须携带来源限定。供给侧证据同样充分:2025年内GPT-5、Claude 4.5、Gemini 3等旗舰全部内置思考能力,Google更宣布未来所有Gemini模型均将内置思考;需求侧,DeepSeek-R1开源一个月Hugging Face下载量即破1090万次。
4.2 技术特征与训练难度
4.2.1 推理时计算:新扩展轴与RLVR范式
o1报告了两条扩展律:性能既随强化学习(Reinforcement Learning, RL)训练时计算量提升,也随推理时计算量提升,且准确率与推理时计算量的对数成正比。这一扩展轴的物理载体是思维链长度:DeepSeek-R1-Zero的RL训练中思考长度在无显式长度奖励的情况下自发增长,模型自行学会”分配更多思考时间”;Qwen3技术报告证实增加思考token预算可持续提升多任务性能。训练范式上,该品类依赖可验证奖励强化学习(Reinforcement Learning with Verifiable Rewards, RLVR)——以单元测试、答案校验等确定性外部验证器替代学习型奖励模型,主导算法为无需critic网络的组相对策略优化(GRPO)。R1-Zero证明了纯RL路径的可行性:从基座模型直接施加GRPO(仅准确性+格式奖励、无任何推理监督微调),AIME 2024 pass@1从15.6%自发升至71.0%,并涌现出自我验证、反思与”aha moment”等元认知行为。
4.2.2 训练难点:熵崩塌、修复配方与开源栈
RLVR训练远非”接上奖励即可”。核心障碍是熵崩塌(entropy collapse):朴素GRPO/PPO训练中策略熵骤降、采样趋同、探索枯竭并陷入局部最优。DAPO论文披露,朴素GRPO在Qwen2.5-32B上AIME仅得30分,远低于DeepSeek报告同规模模型的47分,且明确指出社区复现R1结果普遍困难、原论文可能省略了关键训练细节。字节跳动2025-03提出的DAPO给出修复配方——Clip-Higher非对称裁剪防熵崩塌、动态采样剔除零方差组、token级策略梯度损失消除长度偏置、超长奖励整形去除截断噪声——以50%训练步数在同模型上达AIME 2024 50分;后续VAPO、GSPO等继续演进。可及性方面,Nature 2025-09封面论文(首个经同行评审的主流大模型论文)披露R1的RL训练仅花费29.4万美元(648块H800,R1-Zero约198小时),不含约600万美元的基础模型成本——这一数字权威性高但来源单一。系统层面,RL训练中rollout生成占单轮迭代墙钟时间的70%–85%,催生了veRL(字节,训练/推理同池、671B+规模)、OpenRLHF(Ray微服务解耦、异构集群)与TRL(门槛最低、约30B上限)三大开源框架的分工格局。
4.3 速度与成本权衡
4.3.1 慢30倍、贵30倍的代价与成本崩塌
推理时计算不是免费的午餐。独立测试估计o1比GPT-4o慢约30倍(典型响应10–60秒对1–3秒;第三方测得首token延迟32.3秒对3.2秒);成本上,o1定价为每百万输入/输出token 15/60美元,是GPT-4o的6倍,且隐藏推理token按输出计费(单条响应推理token开销为常规模型的5–50倍),单查询实际成本可达30倍以上。但同一时期内成本以惊人速度崩塌:DeepSeek-R1 API价0.55/2.19美元,仅为o1的约1/27;o3发布价已比o1便宜约80%。最具代表性的曲线是ARC-AGI-1同分数段单任务成本(图4-1):2024-12 o3以1024采样达87.5%的单任务成本约4,560美元,2025-12 GPT-5.2 Pro以11.64美元达90.5%(效率提升约390倍,主要来自采样并行度下降而非算法压缩),2026-08 Grok 4.6以0.30美元复现87.5%——截至Grok 4.6口径两年下降约1.5万倍;同期DeepSeek V4 Flash再以89.0%的成绩把单任务成本压至0.02美元,若计入该点则累计降幅超过20万倍。与此同时,“过度思考”(overthinking)成为公认缺陷:模型对琐碎问题也生成大量冗余推理,研究显示批处理提示可在精度波动小于2.5%的前提下削减74%–76%的推理token。
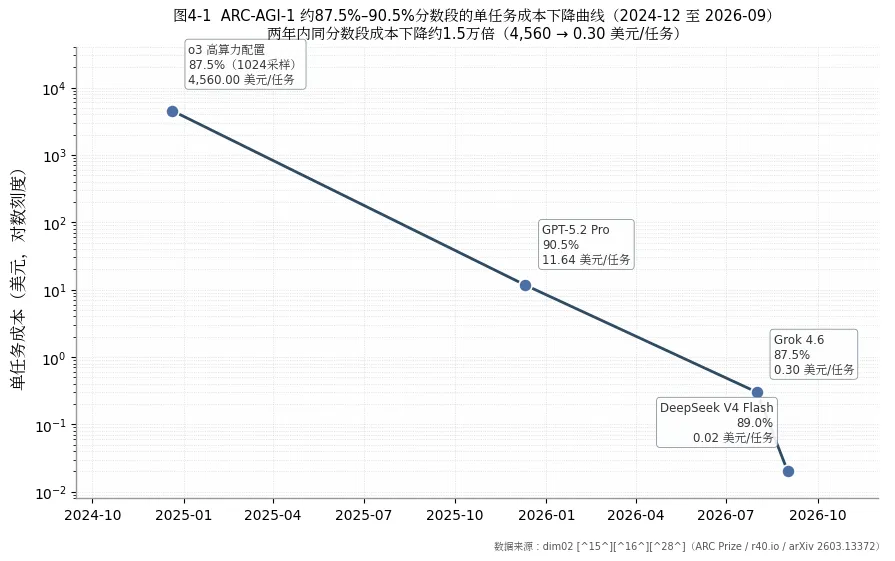
图4-1 ARC-AGI-1约87.5%–90.5%分数段单任务成本下降曲线(2024-12至2026-09)
读图:图4-1显示,两年内同分数段单任务成本跨越约五个数量级,从数千美元降至美分级。这意味着”通关”ARC-AGI-1已从算力堆叠的奢侈试验变为常规推理调用,成本下降主要由推理效率与模型代际进步驱动。
4.4 Top3代表
4.4.1 代表模型与分析
表4-1 推理模型Top3代表(截至2026-09)
排名 | 模型(厂商) | 发布时间 | 定位 | 关键基准成绩 |
1 | o系列/GPT-5-Thinking(OpenAI) | o1:2024-09;o3:2025-04;GPT-5:2025-08 | 品类开创者与前沿标杆 | o3:AIME 2024 96.7%、GPQA 87.7%;GPT-5:AIME 2025无工具94.6%、SWE-bench 74.9% |
2 | DeepSeek-R1(深度求索) | 2025-01-20 | 开源范式定义者(671B MoE,MIT协议) | AIME 2024 79.8%、MATH-500 97.3%、GPQA 71.5%;R1-0528 AIME 2025升至87.5% |
3 | Qwen3-Thinking/QwQ-32B(阿里巴巴) | QwQ-32B:2025-03;Qwen3-Thinking-2507:2025-07 | 开源最强推理线与混合思考模式推广者 | QwQ-32B(32B稠密)AIME 2024 79.5;Qwen3-235B-A22B-Thinking-2507:AIME 2025 92.3、GPQA 81.1 |
三者的入选逻辑互补。OpenAI以o1定义品类,并以GPT-5的”快速模型+推理模型+实时路由器”统一架构把推理能力产品化为默认路径,占据渠道与最难基准的首发突破。DeepSeek-R1的历史贡献在方法论层面:R1-Zero证明纯RL可涌现推理,29.4万美元的RL训练成本与MIT开放权重共同把推理模型训练从头部实验室特权变为全球可复现的工程,直接催生了GRPO/DAPO/veRL开源生态与1.5B–70B蒸馏潮。Qwen线则证明”规模不代表必要”——32B稠密的QwQ-32B在AIME 2024上逼近671B的R1(79.5对79.8),其thinking/non-thinking混合模式已成为行业标配做法。基准解读需谨慎:AIME 2025与GPQA已接近饱和(头部90%以上),仍具区分度的FrontierMath存在典型”官方vs复测”冲突——OpenAI宣称o3达25.2%(2024-12),但基准治理方Epoch AI对公开版o3的独立复测仅约10%(2025-04,差异可归因于内部脚手架、更高推理算力与不同题目子集),且OpenAI曾资助该基准并可接触大部分题目,引发披露争议;按本报告交叉验证裁定口径,采信约10%的复测值并保留争议注记。此后FrontierMath快速推进,GPT-5.2 Thinking于2025-12达40.3%,2026年榜首约50%。
5. 向量嵌入模型(Embedding)
向量嵌入模型(Embedding Model)是指把文本、图像等输入编码为固定维度稠密向量、使语义相似的输入在向量空间中距离相近的一类模型。与生成式大语言模型(LLM)逐 token 自回归输出不同,嵌入模型只做单次前向编码,输出一个可供余弦相似度或内积比较的低维向量(典型 512–4096 维)。这一特性决定了它的生态位:文档向量可以预先离线计算并建立索引,查询时毫秒级完成百万级语料的语义召回,因此嵌入模型是检索增强生成(Retrieval-Augmented Generation, RAG)、语义搜索与推荐系统的”检索底座”——RAG 系统回答质量的上限,首先取决于嵌入模型能否把相关知识从语料库中捞出来。
5.1 流行程度与生态位
5.1.1 榜单演进与采用度:从 MTEB 到 RTEB
衡量嵌入模型流行程度有两条证据链。其一是基准榜单。大规模文本嵌入基准(Massive Text Embedding Benchmark, MTEB)及其多语言扩展 MMTEB(131 项任务、覆盖 250 余种语言,按 Borda count 排名)是事实标准。窗口期内榜首分数快速爬升:Google Gemini Embedding 于 2025 年 3 月以 Task Mean 68.32 同时登顶多语言、英文与代码三榜;阿里 Qwen3-Embedding-8B 于 2025 年 6 月以 70.58 夺回多语言榜开源第一;2025 年第四季度腾讯 KaLM-Embedding-Gemma3-12B 以 72.32 居官方 MMTEB Borda 榜首。由于 MTEB 公开数据集逐渐被厂商过拟合,Hugging Face/MTEB 团队于 2025 年 10 月推出引入私有数据集的检索嵌入基准(Retrieval Embedding Benchmark, RTEB,主指标 NDCG@10),格局随即轮动:voyage-4-large(2026-01,首个 MoE 架构嵌入模型)登顶,2026 年 7 月 NVIDIA Nemotron 3 Embed 以 78.5% 刷新榜首。
其二是真实采用度。智源研究院(BAAI)的 BGE-M3 在 Hugging Face 累计下载达 1.32 亿次、单月峰值 3,732 万次,RunPod 基准报告称其为平台用户部署最多的嵌入模型。“BGE-M3 + Milvus/FAISS + bge-reranker-v2-m3”是中文企业 RAG 的事实标准配方;OpenAI text-embedding-3 系列则是 API 调用量最大的闭源存量选项。
5.2 规模、速度与训练难度
5.2.1 规模与速度:小一到四个数量级的”廉价基建”
主流嵌入模型参数集中在 0.1B–8B 区间,比生成式 LLM(70B–1000B 级)小一至三个数量级;即便榜单顶端的 12B–27B 模型也仅相当于中型 LLM。速度方面,RunPod 在 24 款 GPU × 7 款模型上的实测(2026-09)显示,bge-m3 在 512-token 段落批量模式下于 H200 上达到约 1,345 文本/秒,嵌入整个语料库的成本约为每十亿 token 个位数美元;学术系统实测单条编码约 31.2 ms、FAISS top-k 检索仅 6.7 ms。存储成本按”向量数 × 维度 × 4 字节”计,100 万条 1,536 维向量约 5.7 GB。Matryoshka 表示学习(Matryoshka Representation Learning, MRL)已成为 2026 年行业标准:单模型输出向量可从头部截断(如 3,072 维截至 256 维)而精度损失有限——text-embedding-3-large 截断后 MTEB 仅从 64.6 降至 61.0,存储节省 92%。
5.2.2 训练难度:对比学习为主,成本远低于 LLM
嵌入模型训练的核心方法十余年未变主线:InfoNCE 对比学习目标拉近查询与正样本、推远负样本,配合批内负样本与难负样本挖掘(Hard Negative Mining)——后者是效果的核心杠杆,字节 Conan-Embedding 的动态难负样本策略(训练中周期性重新评估并丢弃已”变简单”的负样本)是代表性改进。2024–2026 年的新增范式是”大模型蒸馏 + 合成数据”:Qwen3-Embedding 采用弱监督对比预训练、多任务监督微调、以 Qwen3-Reranker 为教师做 KL 散度蒸馏并模型合并的三阶段流水线;jina-embeddings-v5-text 直接以 Qwen3-Embedding-4B 为教师做余弦蒸馏,677M 参数达到 1B 以下全球第一。训练成本方面,嵌入模型微调通常在单台到数台 GPU、数天量级,比重头在数据构造(难负样本挖掘需全库检索与教师打分)而非算力,较 LLM 预训练低 3–5 个数量级(量级估算,无公开审计数据)。更深层的范式转移是”LLM 骨干化”:E5-Mistral-7B、gte-Qwen2-7B 证明了 decoder-only LLM 改造(双向注意力、末 token 池化、指令微调)优于传统 BERT 系编码器,Qwen3-Embedding 将其推向成熟——表征学习的 SOTA 如今全部由生成模型”借壳”而来。
5.3 技术栈与 Top3
5.3.1 主流技术栈:加载框架 + 向量数据库 + 两阶段检索
工程栈分三层:模型加载与微调层以 sentence-transformers(18,000+ GitHub stars,托管 10,000+ 预训练模型)与智源 FlagEmbedding(BGE 全家桶及带难负样本挖掘的微调脚本)为事实标准;向量索引层包括 FAISS(本地库)、Milvus(分布式)、Pinecone(全托管,10 亿级向量延迟低于 100 ms)、Qdrant、pgvector 等;检索架构普遍采用”双编码器(Bi-Encoder)召回 Top-50/100 + 交叉编码器(Cross-Encoder)Reranker 精排 Top-5”两阶段方案,实测可将 Top-1 准确率从 68% 提升至 89%,且 Reranker 因百万级文档逐对打分不可行而无法替代嵌入模型,二者是互补关系。
5.3.2 Top3 代表模型
表 5-1 2024-09 至 2026-09 窗口内嵌入模型 Top3
排名 | 模型(厂商,发布时间) | 规模与规格 | 关键证据 | 定位 |
1 | Qwen3-Embedding 系列(阿里,2025-06) | 0.6B/4B/8B,32K 上下文,最高 4096 维 + MRL | MTEB 多语言 70.58 开源第一,MTEB Code 80.68 超 Gemini-Embedding;Apache 2.0 | 开源榜单之王 |
2 | Gemini Embedding / 2(Google,2025-03 / 2026-03) | 3072 维 + MRL,闭源 API,$0.20/M tokens | 2025-03 三榜同登顶(68.32);二代为首个文本/图像/视频/音频/PDF 五模态统一向量模型 | 闭源 API 标杆 |
3 | BGE-M3(智源 BAAI,2024-01 起持续迭代) | 568M,1024 维,8192 token,100+ 语言 | HF 累计下载 1.32 亿、单月 3,732 万;单模型同时输出 dense/sparse/multi-vector 三种检索 | 生态采用度之王 |
表 5-1 显示三种截然不同的成功路径。Qwen3-Embedding 证明了”LLM 骨干 + 三阶段蒸馏”路线的榜单统治力,其 0.6B 版本即超越除 Gemini 外所有基线,且全系列 Apache 2.0 开源并衍生出多模态 Qwen3-VL-Embedding(MMEB-V2 77.8 登顶)。Gemini Embedding 2 则代表闭源厂商”从大模型蒸馏统一向量空间”的路线,率先把五种模态纳入同一向量空间,是多模态检索的风向标。BGE-M3 的 MTEB 分数(约 63.0)已非顶尖,但凭借 MIT 协议、混合检索能力与最完整的中文社区工具链占据生态位,说明嵌入模型的竞争不止于榜单分数,“够用 + 免费 + 易集成”同样是护城河。三者共同勾勒出该品类”开源追平闭源、文本扩展至多模态、生态重于单点分数”的竞争格局。
6. 多模态大模型(VLM/Omni)
第 5 章已展示向量检索底座的”LLM 骨干化”——嵌入模型日益直接蒸馏自大语言模型;本章继而考察这一逻辑的下一步:图像、音频、视频等多模态能力不再是外挂模块,而是被并入同一个统一底座,“骨干化”由此升级为”全模态化”。
6.1 流行程度
6.1.1 GPT-4o确立原生omni范式;Gemini 3 Pro(MMMU-Pro 81%)成标杆;MMMU弃用转MMMU-Pro
多模态大模型(视觉语言模型,Vision-Language Model,VLM;以及融合文本、图像、音频、视频的原生全模态”omni”模型)在2024-09至2026-09窗口内从”可选能力”变为旗舰模型的默认形态。范式确立者是OpenAI于2024年5月13日发布的GPT-4o(“omni”):它首次以单一端到端神经网络原生整合文本、图像与音频,而非外挂视觉编码器的拼接方案。2025年3月GPT-4o图像生成升级引发”吉卜力风格”现象级传播,上线首周即触达1.3亿用户、生成逾7亿张图片,多模态由此成为消费端增长引擎。需要特别说明的是,早期有报道称该热潮推动ChatGPT周活跃用户(WAU)“首超1.5亿”,经交叉验证裁定(C-1)该口径有误;本章统一采用官方口径:ChatGPT WAU于2025年10月达8亿,2026年7月增至约10亿。2025年8月7日发布的GPT-5以统一系统路由”快速/深度推理”模式,支持文本+图像输入与40万token上下文,官方公布MMMU 84.2%、VideoMMMU 84.6%。
从产品采用看,Google披露Gemini应用月活跃用户(MAU)于2026年5月超过9亿——需注意MAU与ChatGPT的WAU口径不同,两者不可直接比较。能力标杆则由Google Gemini 3 Pro(2025年11月18日发布)确立:官方数据为MMMU-Pro 81%、Video-MMMU 87.6%、ScreenSpot-Pro 72.7%(上一代2.5 Pro仅11.4%),并以1501 Elo成为首个突破1500分的LMArena榜首模型,多模态能力被公认为超越同期GPT-5.1与Claude Sonnet 4.5。评测体系本身也在同步换代:大规模多任务多模态理解基准MMMU因趋于饱和已被前沿实验室实质弃用,2025年11月后官方榜单新增条目只填报更难的MMMU-Pro;视频侧Video-MME饱和后演进出Video-MME-v2(2026年4月),最强模型Gemini 3 Pro得分49.4,与人类专家水平仍有显著差距。
6.2 规模与计算特征
6.2.1 视觉编码器0.3B–6B+MoE LLM;视觉token占序列50–80%是推理瓶颈;每帧token压缩(Gemini 258→70)
主流VLM的参数构成为”0.3B–6B视觉编码器+MLP投影层+数B至数百B的LLM主体”。典型实例包括:字节Seed1.5-VL为532M SeedViT视觉编码器加20B激活参数的混合专家(Mixture-of-Experts,MoE)语言模型;InternVL3-78B为6B InternViT加72.7B Qwen2.5基座;Qwen3-VL默认采用SigLIP2-SO400M编码器,并提供稠密2B–32B与MoE 30B-A3B、235B-A22B全尺寸矩阵。视觉编码器占比虽小,但其输出决定了推理成本结构:由于自注意力复杂度为O(n²),视觉token通常占输入序列的50%–80%——一张224×224图像经视觉变换器(ViT)编码产生196个patch token,高分辨率切片后可达上千个,构成VLM推理的核心瓶颈。视频场景尤为突出:Gemini 3之前默认每帧258 token(低分辨率66),1小时视频(1fps)加音频约消耗104万token,正好占满100万token上下文窗口;Gemini 3改用变长token化,默认降至70 token/帧。产业界以token压缩为主线应对:MiniCPM-V 4.5用3D-Resampler把6帧448×448视频压成64 token(96倍压缩率),MiniCPM-V 4.6的LLaVA-UHD v4通过ViT内部早期压缩将视觉编码FLOPs降低55.8%。架构层面同样存在降本空间:Qwen2.5-VL的视觉塔在32层中仅保留4层全局注意力、其余在4×4 token窗口内做Window Attention,实现近线性复杂度的视觉编码;单体架构Mono-InternVL省去独立视觉编码器的前向开销,首token延迟较模块化基线降低67%,但以更高的训练成本与稳定性风险为代价。这些优化的收益已可量化到端到端延迟与成本:MiniCPM-V 4.6在3136²高分辨率输入下首token延迟(TTFT)仅75.7毫秒(RTX 4090);推理期无需重训的视觉token剪枝(如CVPR 2026的V²Drop,按视觉token层间变化量渐进剪枝)可实现VLM无损加速1.87倍,额外开销仅为单层注意力计算量的0.022%。压缩与剪枝直接折算为API成本优势:字节Seed1.5-VL官方推理输入价低至0.003元/千token。
6.3 训练难度与技术路线
6.3.1 模块化拼接(LLaVA式低成本)vs原生多模态(万亿token级数据)路线之争;25–50%文本混合回放防灾难性遗忘
训练侧存在两条对立路线。模块化拼接(LLaVA式)把训练成本压至极低:阶段一仅训练投影层(55.8万图文对,8×A100约6小时),阶段二联合微调投影层与LLM(66.5万指令数据,约20小时),视觉编码器全程冻结。但该路线存在结构性缺陷——LLM参数参与多模态训练后发生灾难性遗忘,文本能力(MMLU等)明显下滑,这正是主流多模态模型多以”-VL”后缀独立于语言基座存在的原因。工业界主流对策是数据配比:多模态训练中同步掺入25%–50%高质量纯文本数据做同步回放,辅以”先投影层、再LoRA、后全参”的渐进式解冻。原生多模态路线(Gemini、GPT-4o、Llama 4、豆包Seed、Qwen3.5)则从预训练第一步就混合全部模态,对齐更深、支持跨模态生成,但代价是万亿token级多模态语料、巨大算力预算与”训练成本高、优化不稳定”的难题。折中方案”原生多模态预训练”由InternVL3落地:单一预训练阶段联合习得文本与多模态能力,文本分数反超Qwen2.5基座,78B版本以MMMU 72.2创当时开源纪录(高于GPT-4o的70.7)。数据规模的军备竞赛同步展开:Seed1.5-VL预训练3万亿token、Qwen2.5-VL 4.1万亿、Llama 4达40万亿token(200种语言图文交错),多模态预训练已进入数十万亿token时代。
6.4 Top3代表
6.4.1 Top3表+分析:Gemini 3 Pro、GPT-4o/GPT-5、Qwen3-VL
表6-1 多模态大模型Top3代表(2024-09至2026-09)
排名 | 模型 | 厂商 | 发布时间 | 代表规格与成绩 | 路线定位 |
1 | Gemini 3 Pro | 2025-11-18 | MMMU-Pro 81%、Video-MMMU 87.6%、LMArena 1501 Elo,原生处理文/图/音/视频,1M上下文 | 原生全模态标杆 | |
2 | GPT-4o→GPT-5 | OpenAI | 2024-05 / 2025-08 | 首创原生omni范式;GPT-5 MMMU 84.2%、400K上下文;ChatGPT WAU约10亿(2026-07) | 采用面最广的闭源旗舰 |
3 | Qwen3-VL | 阿里巴巴 | 2025-09/10 | Apache 2.0开源,稠密2B–32B+MoE 235B-A22B,MMStar 78.7紧追Gemini 2.5 Pro,原生256K上下文 | 开源最强VLM全尺寸矩阵 |
表6-1显示,Top3恰好对应三种差异化竞争位置。Gemini 3 Pro凭借原生全模态架构在图像、视频、GUI定位(ScreenSpot-Pro 72.7%)等维度全面领先,代表”能力上限”;GPT-4o/GPT-5系列依托ChatGPT约10亿周活的分发渠道代表”采用广度”,但第三方实测显示其物体计数与精确定位仍有短板;Qwen3-VL则以Apache 2.0许可、全尺寸矩阵和Interleaved-MRoPE、DeepStack等架构创新定义了开源前沿,并通过文本混合回放把”多模态税”压缩到接近零。三者共同推动多模态从附加能力演变为大模型的默认形态;未入选的豆包Seed1.5-VL(60榜38项SOTA、中文场景领先)与InternVL3(原生预训练开源路线代表)构成有力的备选梯队。
对选型而言,三条路径各有适用边界:当任务触及能力上限——需要原生音频/视频输入、GUI精确定位(ScreenSpot-Pro 72.7%)或超长视频理解(Video-MMMU 87.6%)——应选择闭源omni旗舰(Gemini 3 Pro、GPT-5),其端到端原生融合在跨模态深度上仍非开源可及;而当数据须本地部署、需要全参微调定制或成本敏感时,应选开源VL(Qwen3-VL、InternVL3)——Apache 2.0许可的2B–235B全尺寸矩阵允许按算力预算逐档裁剪,配合token压缩与端侧蒸馏路线(MiniCPM-V 96倍压缩、RTX 4090可跑),推理成本可比闭源API低一至两个数量级。
7. 图像生成模型
图像生成模型指以文本提示或参考图为条件、合成像素级图像的一类生成模型。2024-09 至 2026-09 窗口内,该领域经历了自 Stable Diffusion 问世以来最彻底的一次技术与市场重构:架构上从 U-Net 扩散切换到 Transformer 扩散主干,训练目标从噪声预测切换到整流流,产品形态上又遭遇自回归统一多模态模型的正面冲击。本章依次讨论范式迁移、流行度与规模速度指标、技术栈生态,并给出窗口期内的 Top3 代表判定。
7.1 范式迁移
7.1.1 从 U-Net+DDPM 到 DiT/MMDiT+Rectified Flow,及自回归路线的冲击
窗口期内图像生成沿两条正交轴线完成范式迁移。第一条是去噪骨干的替换:扩散 Transformer(Diffusion Transformer, DiT,Peebles & Xie 于 ICCV 2023 提出)以纯 Transformer 取代卷积 U-Net;第二条是训练目标的替换:整流流(Rectified Flow)与流匹配(Flow Matching)以直线常微分方程路径取代去噪扩散概率模型(Denoising Diffusion Probabilistic Model, DDPM)的弯曲加噪轨迹,使采样步数得以大幅压缩。两条线在 Stable Diffusion 3 的多模态扩散 Transformer(Multimodal Diffusion Transformer, MMDiT)上汇合——文本与图像 token 各自持有独立权重、经联合注意力双向交互;其 450M–8B 的缩放研究显示验证损失随参数规模平滑下降且未见饱和。此后 2024–2026 年的主流开源旗舰(SD 3.5、FLUX、Qwen-Image、Hunyuan、Z-Image 等)几乎全部收敛于”DiT 系 + flow matching/rectified flow”组合。
第二条冲击来自自回归(Autoregressive, AR)路线。学术侧,北大团队 VAR(视觉自回归建模,next-scale prediction)获 NeurIPS 2024 最佳论文,GPT 式自回归视觉生成首次在效果、速度与缩放能力上超越同规模扩散模型。工业侧,OpenAI 于 2025 年 3 月上线的 GPT-4o 图像生成官方确认采用 GPT-4o 架构而非 DALL-E 的扩散堆栈(其具体实现为纯 AR 抑或 AR+扩散混合,OpenAI 未披露,第三方逆向分析存在分歧);Google 的 Nano Banana 系列同属原生多模态统一架构。业内争论的焦点在于扩散的多步迭代与可扩展性疑虑对 AR 的误差累积与逐 token 解码延迟,共识倾向”图像生成收敛于统一多模态大模型,扩散退居图像 token 的解码头”。
7.2 流行度、规模与速度
7.2.1 流行度:三条用户量级曲线
消费级市场的渗透速度在窗口期内被反复刷新。独立玩家 Midjourney 注册用户约 1,994 万(2025-12,第三方统计),Discord 服务器成员超 2,100 万,2025 年收入约 5 亿美元(2024 年为 3 亿),在无外部融资、无免费档的条件下以约 107 名员工实现人均创收约 467 万美元;第三方机构估算其全球 AI 图像生成市场份额约 26.8%(份额类数据口径不一,仅作量级参考)。OpenAI 的 GPT-4o 图像生成功能 2025-03-25 上线后一周内,超 1.3 亿用户生成超 7 亿张图(OpenAI COO 口径),峰值时一小时新增百万用户并迫使官方限速,是史上渗透最快的图像功能;DALL-E 2/3 API 于 2026-05-12 正式退役,由 gpt-image 系列全面接替。Google 的 Nano Banana(Gemini 2.5 Flash Image,2025-08-26 发布)在匿名测试期即以 Arena 历史上最大的 171 分 Elo 优势登顶图像编辑榜,仅 Gemini App 内数月即被用于创作超 50 亿个作品(2025-10 官方数据),API 定价约 0.039 美元/图。
7.2.2 规模与速度:参数攀升与亚秒级蒸馏并行
开源旗舰参数量两年内从 2.6B(SDXL)起步持续攀升,其时间次序为:FLUX.1(2024-08,12B,混合双流/单流 DiT)率先越过 10B 门槛;SD 3.5 Large(2024-10,8B,MMDiT+rectified flow,配 CLIP-L/G 与 T5-XXL 三文本编码器)参数规模虽略低,但其 MMDiT 路线随即成为开源主流;Qwen-Image(2025-08,20B,MMDiT + 7B VLM 编码器)接力推进;FLUX.2(2025-11-25,32B,另耦合 Mistral-3 24B 视觉语言模型)将开源上限再次翻倍,整体呈现与大语言模型类似的缩放行为。与此同时,步数蒸馏(step distillation)把单图延迟压入亚秒级:SDXL-Turbo 经对抗扩散蒸馏单步生成 512×512 图像在 A100 上仅需 207 毫秒;FLUX.2 [klein]-4B(2026-01)经步数蒸馏 4 步推理、端到端不超过 0.5 秒,约 13GB 显存即可在消费级 GPU 运行,FP8/NVFP4 量化再提速最高 2.7 倍。闭源服务端,字节 Seedream 4.0 以 1.8 秒生成 2K 图(较 3.0 提速逾 10 倍);API 单图价格已降至 0.02–0.19 美元(gpt-image-1 各档位),FLUX schnell 等开源模型的第三方托管价更低至约 0.003–0.005 美元/图。
7.3 技术栈与 Top3
7.3.1 diffusers、ComfyUI 与 LoRA 长尾生态
开源工具栈呈”库—界面—微调”三层结构。库层,Hugging Face 的 diffusers 是扩散模型事实标准库,FLUX、SD 3.5、Qwen-Image 官方均提供集成(其依托的 HF Hub 平台规模统计与其他维度数据存在口径冲突,本章不采用具体数字,仅作定性引用)。界面层,节点式工作流 ComfyUI 的 GitHub Star 从 2025-12 的 9.87 万增至 2026-08 的 13 万+,取代增长放缓的 AUTOMATIC1111 WebUI(8 万+)成为事实标准。微调层,低秩适应(Low-Rank Adaptation, LoRA)生态以 Civitai 为集散地:该平台托管 20 万–50 万个模型(以 SD/FLUX checkpoint 与 LoRA 为主,第三方估算),注册用户 2025-02 超 300 万,后续第三方口径称累计超千万但无法独立验证,本章采区间表述;蒸馏 LoRA(LCM-LoRA、FLUX-Lightning 等)可在不破坏微调生态的前提下实现 4 步加速。这一长尾生态是开源阵营对抗闭源统一模型的结构性护城河。
7.3.2 Top3 代表模型与分析
表 7-1 2024-09 至 2026-09 窗口内图像生成模型 Top3
排名 | 模型系列(厂商) | 规模与路线 | 关键证据 | 定位 |
1 | FLUX.1/FLUX.2(Black Forest Labs) | 12B→32B,rectified flow DiT,dev 权重开放 | Arena 文生图前十独占三席,FLUX 2 Max Elo 约 1168;klein 4 步 ≤0.5s | 开源/商用双料标杆 |
2 | Nano Banana 系列(Google) | 未公开,原生多模态统一架构 | 编辑榜 171 分 Elo 历史最大领先;数月 50 亿+作品;Nano Banana 2/Pro 居 2026-07 Arena 文生图前二(1284/1281 Elo) | 消费级与编辑标杆 |
3 | GPT-4o 图像/GPT Image 系列(OpenAI) | 未公开,自回归统一多模态 | 首周 1.3 亿用户 7 亿+图;GPT Image 2 以 1277 Elo、83% 胜率入 Arena 前三;DALL-E 正式退役 | 自回归路线引爆者 |
表 7-1 概括了窗口期头部格局的三条竞争主线。FLUX 系列由原 Stable Diffusion 核心团队创立,是 rectified flow 路线的产业旗手,其产品线从 32B 旗舰(配 24B VLM 语义理解)一路覆盖到 4B 亚秒级 klein,并以开放权重维系 LoRA/ComfyUI 生态引力,构成”开源上限”的度量尺。Nano Banana 系列代表 Google 把图像生成内化为大模型原生能力的路线,其胜负手不在单图质量而在指令编辑与多参考图一致性(Pro 版支持 14 张参考图与 4K 输出),叠加 Gemini 入口的分发优势,在 Arena 双榜实现霸榜。GPT Image 系列的意义则超出产品本身:它以一周 7 亿张图的渗透速度证明统一多模态入口的压倒性分发能力,并直接终结了 DALL-E 所代表的专用扩散产品线。候补阵营中,Midjourney V7 以约 5 亿美元年收入证明独立商业模式仍可存活,但闭源且无官方 API、技术透明度低;字节 Seedream 4.0 以 1.8 秒/2K 的速度标杆与 4K 统一生成编辑架构一度登顶 Artificial Analysis 双榜,在中国市场(豆包/即梦/火山引擎)份额领先。整体看,专用图像模型的持久生存条件已清晰可辨:单位经济学独立成立(Midjourney)或掌握开源生态引力(FLUX),其余空间正被统一多模态大模型系统性吞噬。
8. 视频生成模型
8.1 商业化两极
8.1.1 可灵与 Sora 2:同一赛道的两种结局
调研窗口(2024-09 至 2026-09)内,视频生成模型呈现出本报告所有品类中最极端的商业化分化:快手可灵(Kling AI)与 OpenAI Sora 2 构成正反对照。可灵是窗口内唯一实现规模化收入的视频生成产品:截至 2025 年 12 月,其全球用户超 6000 万、累计生成超 6 亿条视频、API 企业客户超 3 万家,年化经常性收入(Annual Recurring Revenue, ARR)达 2.4 亿美元;至 2026 年 3 月 ARR 已近 5 亿美元,约一个季度内接近翻倍。2026 年 6 月可灵用户突破 1 亿(覆盖 224 个国家),企业客户近 5 万家,2026 年第一、二季度单季营收分别超 6.5 亿元(同比 +300%)与 8.5 亿元人民币(同比 +200%)。更关键的是成本侧:快手在财报电话会上披露,可灵”在推理生成视频上已经实现毛利率层面的打平”——即单位收入覆盖单位推理成本,这在消费级视频生成中是首次被验证的可持续单位经济。
Sora 2 则走完了”爆发—衰退—关停”的完整周期。Sora App 于 2025-09-30 上线 iOS,首日 10 万安装、5 天破 100 万下载(快于 ChatGPT 同期),登顶美区 App Store,2025 年 11 月下载量达峰值 333 万。但随后连续下滑,全生命周期下载约 960 万次,消费者总收入仅约 140–210 万美元,而算力成本约 100 万美元/天;2026-03-24 OpenAI 宣布关停,App 与网页端于 2026-04-26 关闭,API 于 2026-09-24 终止,此前披露的迪士尼最高 10 亿美元投资加授权交易随之流产(未签约、未付款)。据分析师估算,单条 10 秒片段的边际算力成本约 0.2–1.5 美元(一说约 1.3 美元、跨多卡 H100 约 40 分钟 GPU 时间),峰值期基础设施成本高达 1500 万美元/天(该成本为第三方估算,非官方审计数据,置信度中等)。两者的对比说明:差距不在技术排名(两者在第三方榜单上接近),而在成本工程与分发渠道——可灵依托快手生态与近 5 万家企业 API 客户摊薄需求,而 Sora 2 依赖低支付意愿的消费级娱乐负载,单位经济结构性崩溃。
8.2 技术特征与成本
8.2.1 统一范式、音画同步与”世界模拟器”叙事的证伪
技术上,窗口内全行业收敛于同一范式:视频经三维变分自编码器(3D VAE)压缩为时空潜空间,切分为时空块(spacetime patches)作为 token,以扩散变换器(Diffusion Transformer, DiT,替代 U-Net)执行去噪,训练目标普遍采用流匹配(Flow Matching)或修正流(Rectified Flow);该架构可统一处理任意时长、分辨率与宽高比。此范式由 OpenAI 2024 年 Sora 技术报告确立,此后阿里 Wan、腾讯 HunyuanVideo、可灵、字节 Seedance、LTX 等全部跟进。参数规模方面,闭源旗舰均未披露参数量;开源模型的参数量集中在 13 亿至 220 亿区间(Wan 2.1/2.2 为 140 亿,LTX-2.3 双流 DiT 为 220 亿),可作行业量级锚点;对 Sora 参数量,外部估算从”约 10 亿”到”至少 200 亿”互相矛盾,本章按交叉验证结论(C-8)采信”数十亿参数量级”的保守表述。
能力侧的两个关键事件:其一,Google Veo 3(2025-05-20 发布)首创原生音画同步——同步生成对白、唇形、环境音与音乐,支持 50 余种语言,定义了”带声音的视频生成”新品类;随后 Sora 2、可灵 2.6、Seedance 2.0(双分支 DiT 架构)与开源 LTX-2.3 在 2025 年底至 2026 年全面跟进。其二,OpenAI 提出的”扩展视频生成模型是通往通用物理世界模拟器的路径”之叙事在窗口内被部分证伪:物理错误、物体恒存失效与因果偏差仍是普遍失败模式,Runway 公开承认存在”成功偏置”;2026 年 OpenAI 将 Sora 团队转向机器人世界模型研究,实质上放弃了”纯视频生成即世界模型”的路线。
8.2.2 成本结构:API 定价、训练算力与注意力的平方放大
推理侧,视频生成成本比文本大语言模型高几个数量级:估计单卡 H100 每小时约生成 5 分钟视频,单条 10 秒视频端到端耗时 2–3 分钟、算力成本约 0.11–0.9 美元。API 定价随之形成梯度:Google 于 2025-09-09 将 Veo 3 降价 30–50%(标准版降至 0.40 美元/秒、Fast 版 0.15 美元/秒,意在价格战放量);Veo 3.1 Lite 低至 0.05–0.08 美元/秒;可灵 3.0 官方 API 约 0.10 美元/秒(720p)至 0.40 美元/秒(1080p 含音频);Sora 2 API 关停前为 0.10–0.70 美元/秒。训练侧,旗舰模型以千卡级 H100 集群月级训练为门槛:外部估计 Sora 需 4200–10500 块 H100 训练一个月;字节 Seaweed-7B 论文披露使用相当于 1000 块 H100 × 27.7 天的算力。成本刚性的根源在于注意力机制的平方复杂度:视频须同时处理 N 帧并保持跨帧一致性,自注意力随 patch 数平方增长——时长加倍则注意力成本升至 4 倍,分辨率加倍约升至 16 倍;显存呈结构性放大,10 秒 720p 视频推理即需 80GB 以上显存,超出单卡 H100 舒适区。
8.3 Top3 代表
8.3.1 Top3 一览与分析
评选标准:技术范式影响力 × 用户规模 × 商业化 × 窗口内持续迭代。
表 8-1 视频生成模型 Top3(2024-09 至 2026-09)
排名 | 模型(厂商) | 关键版本演进(窗口内) | 代表性指标 | 商业化结果 |
1 | 可灵 Kling(快手) | 1.0→3.0 Omni,两年 26 次迭代 | 用户破 1 亿;ARR 近 5 亿美元;Video Arena 前三 | 推理毛利打平,唯一规模化盈利 |
2 | Veo 3 / 3.1(Google DeepMind) | Veo 3(2025-05)→3.1(2025-10) | 首创音画同步;Flow 工具 5 个月生成 2.75 亿条视频 | 降价 50% 打价格战,绑定 Gemini/Workspace 生态 |
3 | Sora / Sora 2(OpenAI) | Sora 2(2025-09-30) | 定义 DiT+时空块范式;App 5 天破百万下载 | 单位经济崩溃,2026-03 宣布关停 |
前三名恰好对应三种产业角色:可灵证明”成本工程+生态分发”路线可使消费级视频生成盈利,其 122 篇论文与 21 个开源项目亦构成技术外溢;Veo 3/3.1 代表平台型巨头的品类定义能力,以音画同步建立差异化,再以降价与 Gemini 入口碾压长尾;Sora 虽商业失败,但其确立的 DiT 范式与”世界模拟器”叙事塑造了整个赛道的技术话语,其兴亡是视频生成算力经济学的最佳样本。候补者中,Runway Gen-4.5(2025-12)以 1247 的 Elo 评分登顶 Artificial Analysis Video Arena 文生视频榜(高于 Veo 3 的 1226 与 Sora 2 Pro 的 1206),走好莱坞专业路线,年化收入约 9000 万美元;字节 Seedance 2.0(2026-02)以双分支 DiT 实现原生音画联合生成、生成成功率从 20% 提升至 90%,依托豆包/即梦/CapCut 分发,是 2026 下半年最强上升势力。

发表评论
发表评论: