
 研报速递
在“百模大战”的今天,我们似乎习惯了AI的“喋喋不休”。但对于大量企业级任务来说,AI能说会道反而是最大的成本负担。
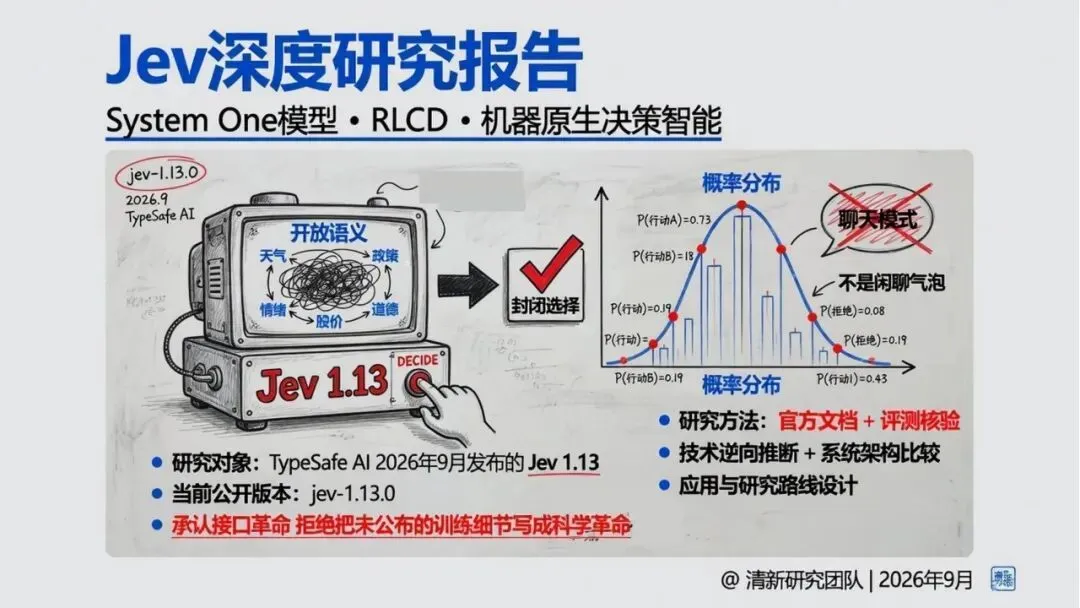
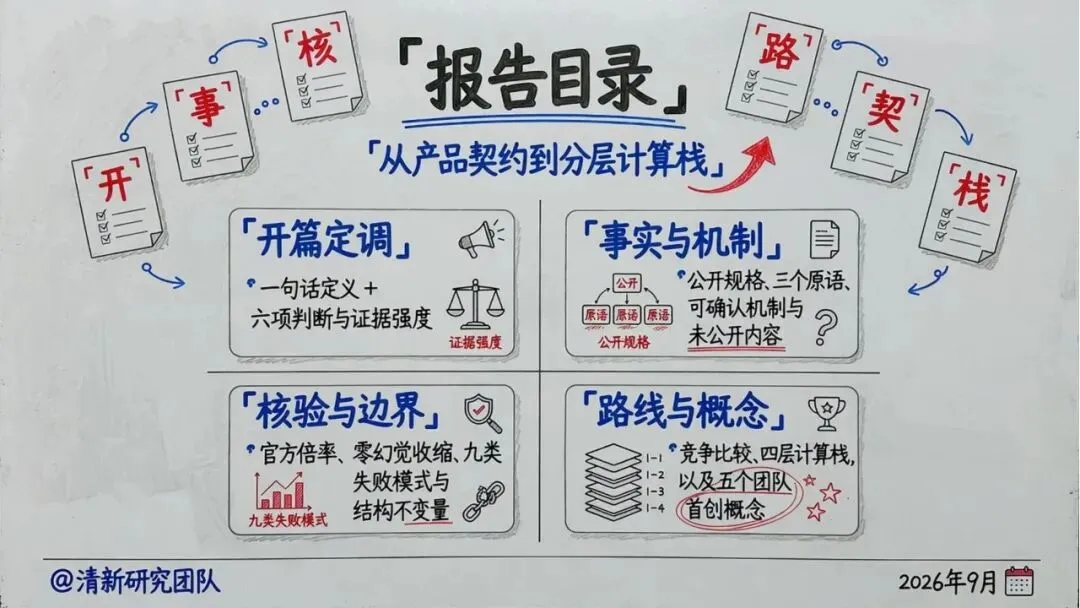
今天,一份名为《Jev深度研究报告-System One与机器原生决策智能》的文档引发关注。这份报告没有鼓吹算力奇迹,而是冷静地指出了一个新趋势:是时候改变AI的产品契约了。
一、 不是“聊天机器人”,是“条件决策算子”
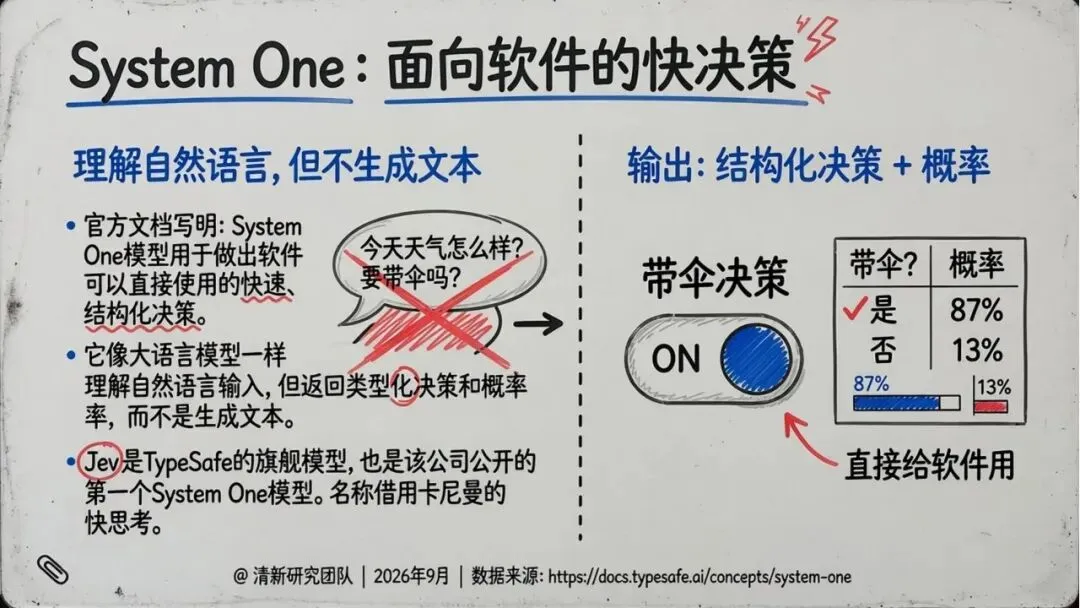
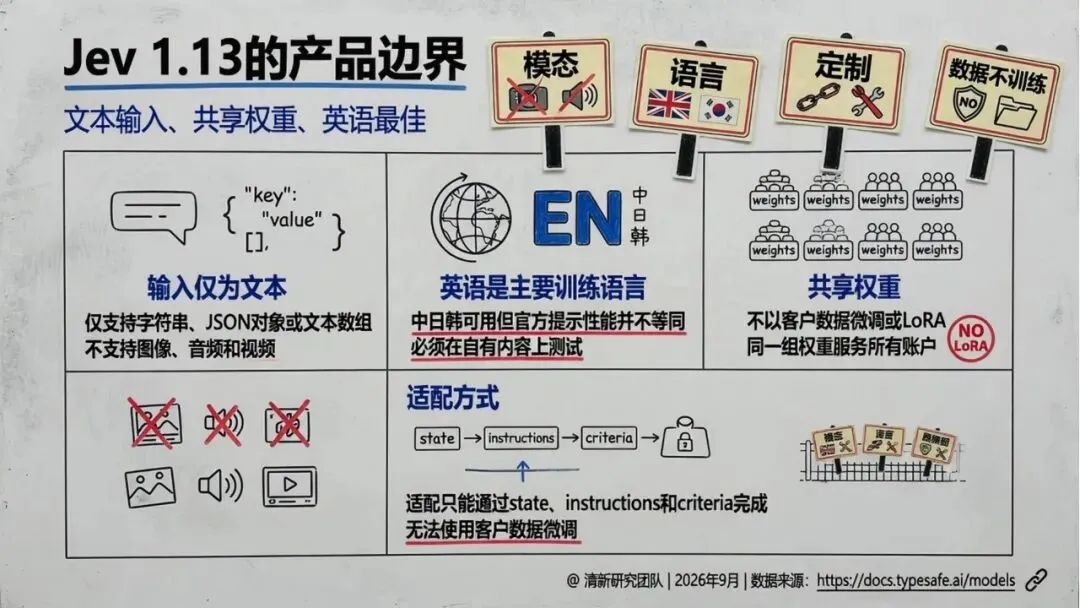
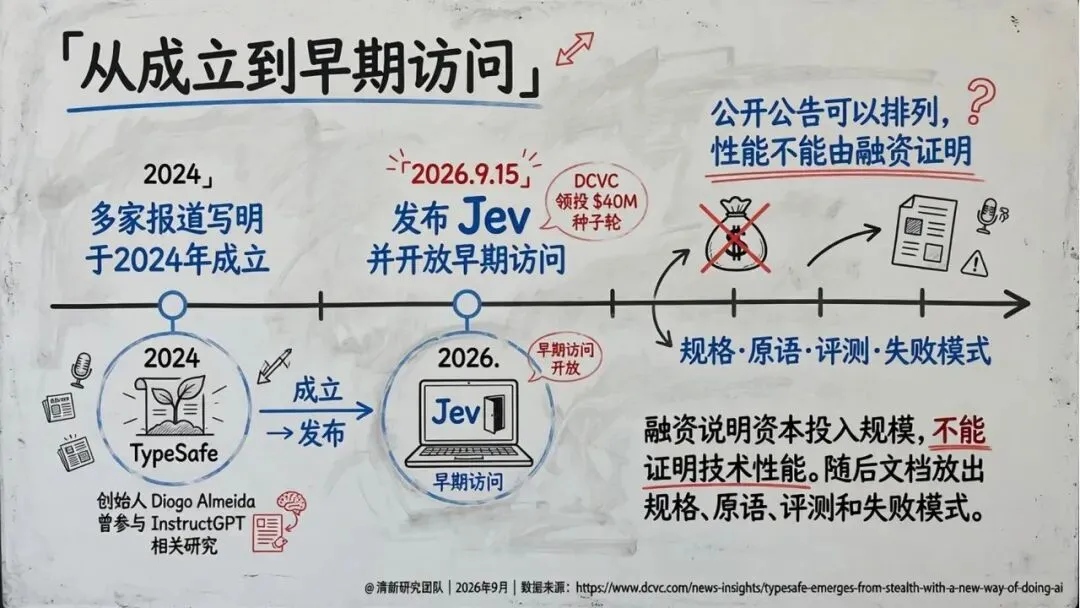
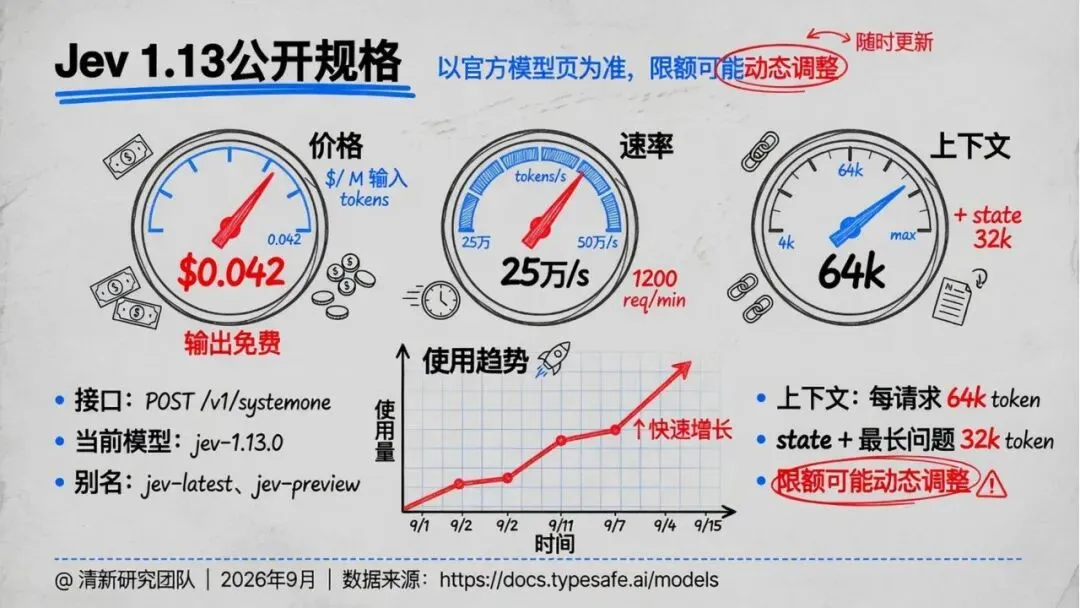
Jev 1.13由TypeSafe AI发布。它和ChatGPT等聊天模型最大的区别在于:它不生成自由文本。
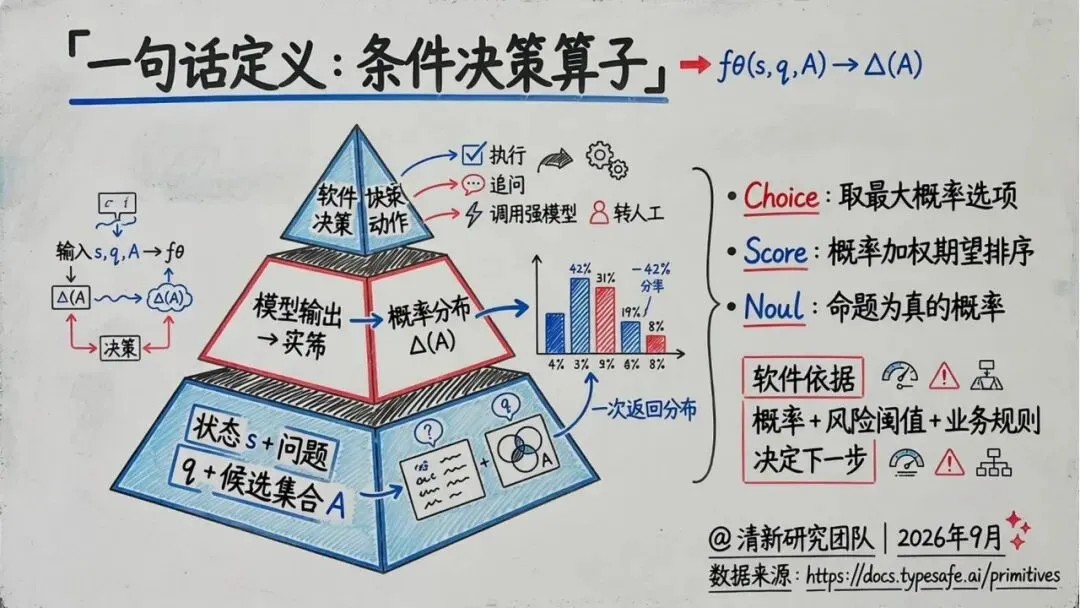
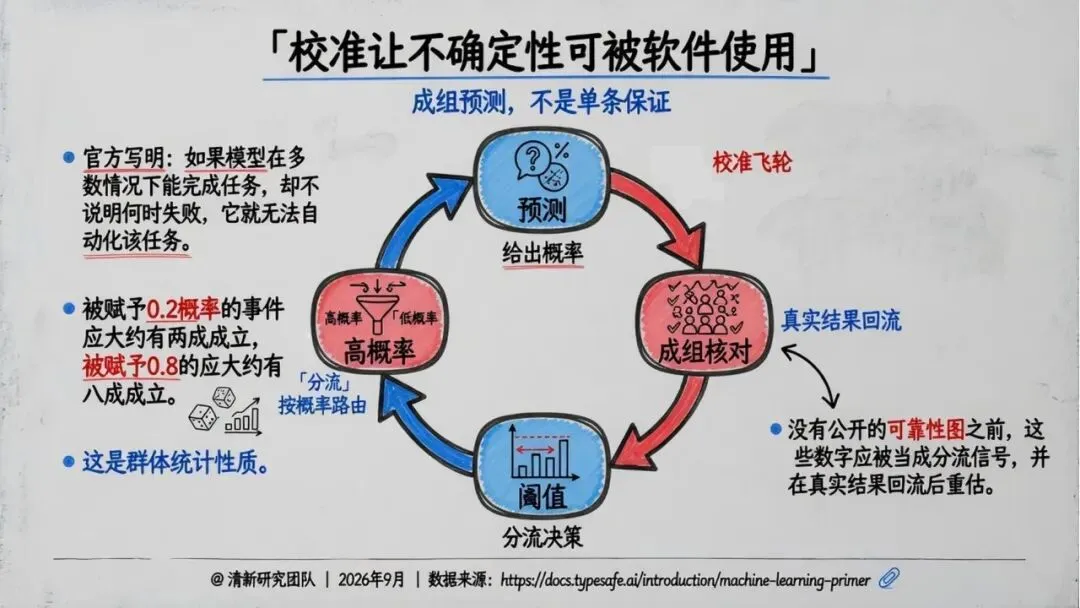
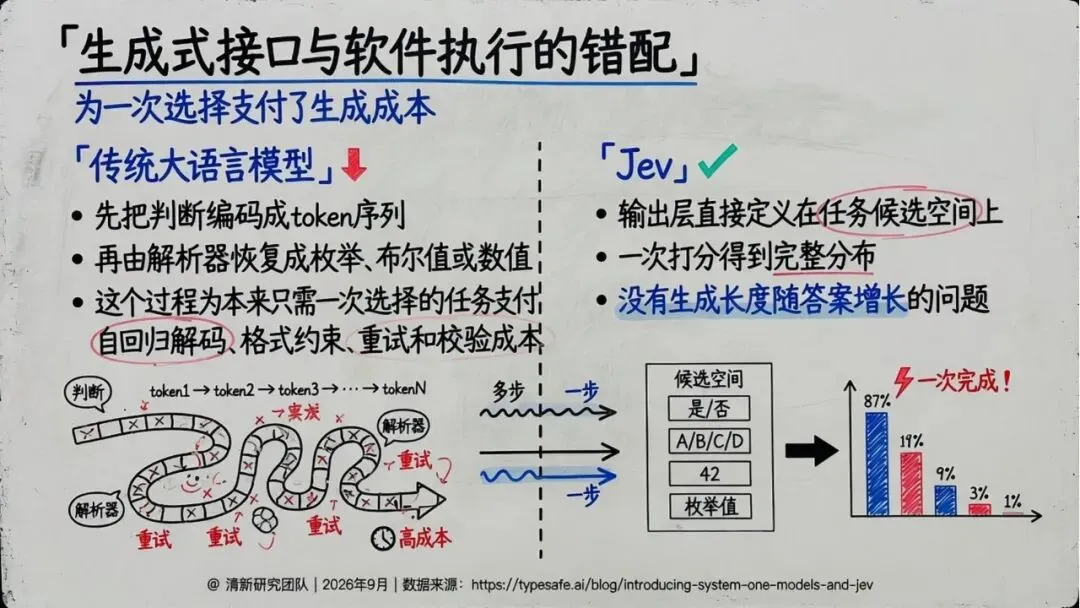
官方的定义非常硬核:“条件决策算子”。当你把自然语言和候选选项输入进去,它不会跟你客套,而是直接输出一个概率分布。
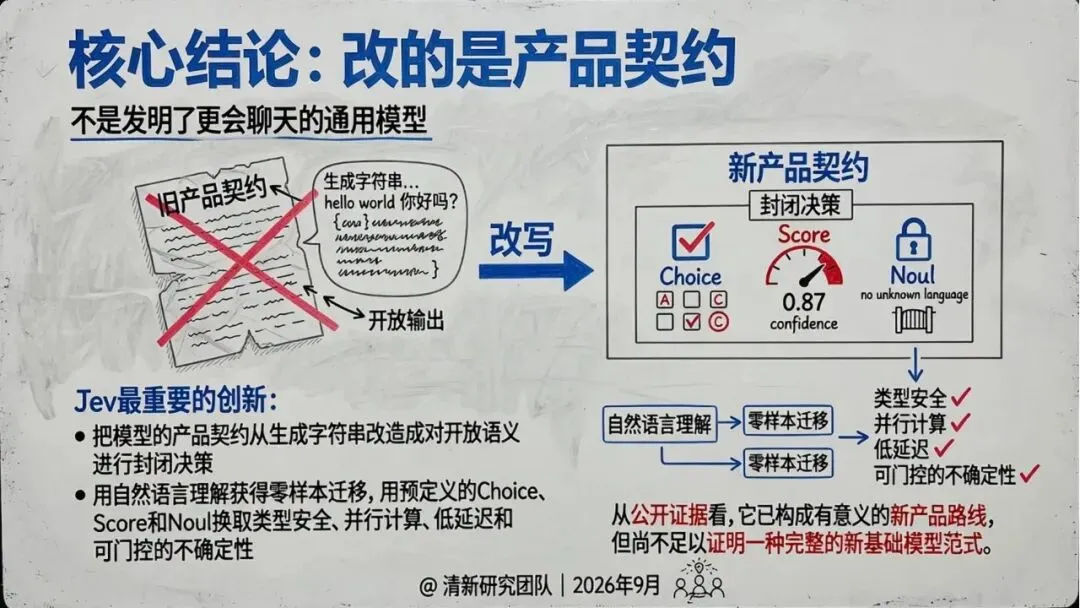
报告将其提炼为三个原语:
Choice:从预定义候选中选一个(最多255个选项),返回全分布。
Score:在有序等级上评分(最多十级),返回加权期望。
Noul:判断命题是否成立,直接返回0到1的“真概率”。
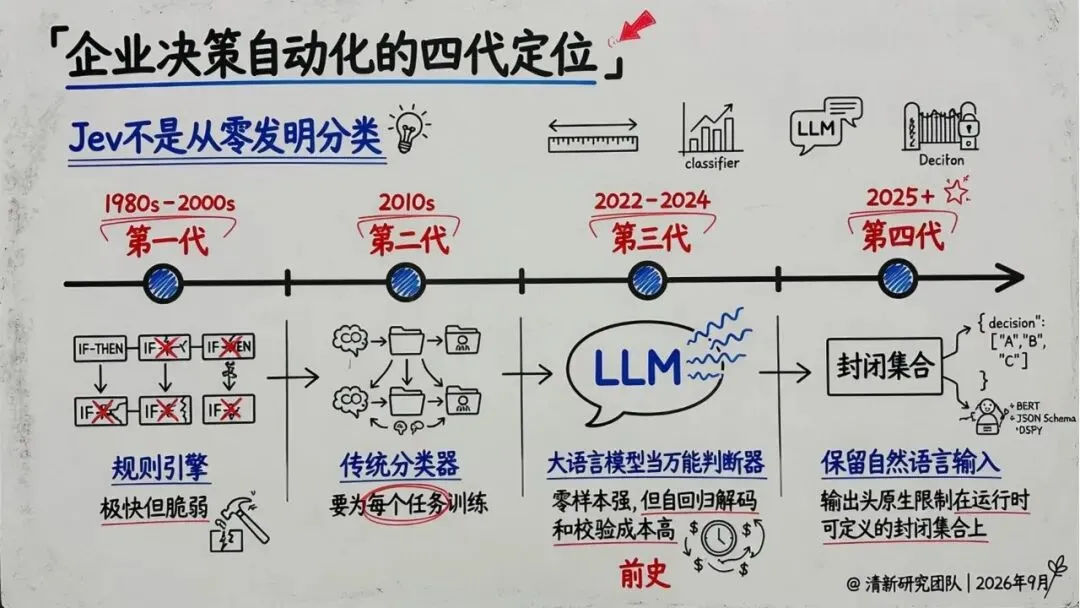
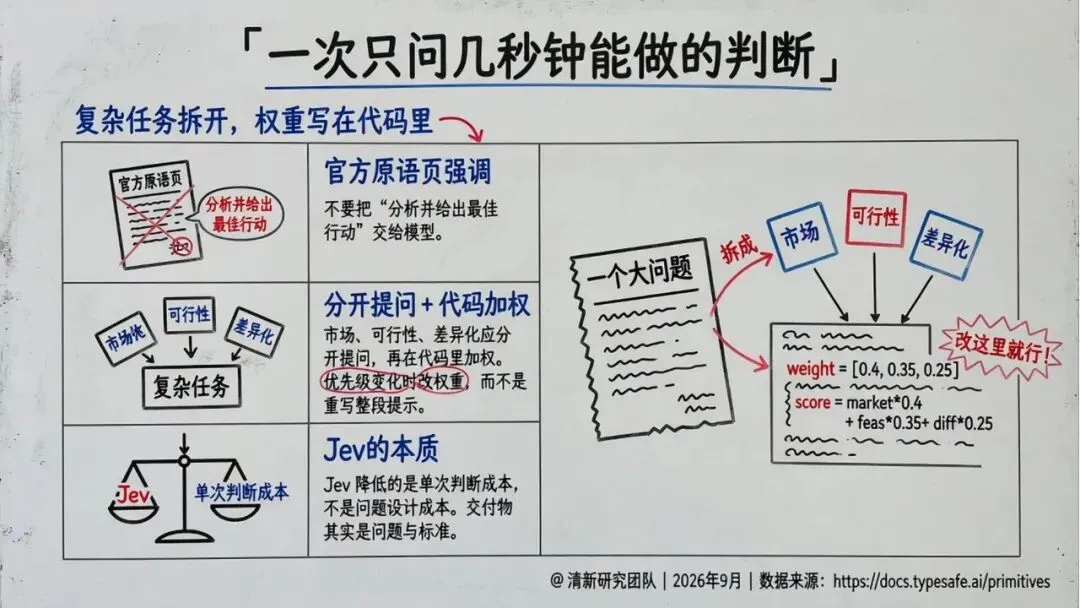
过去,我们用Prompt让模型生成JSON,然后写代码去解析、校验、重试。这个过程为本来只需一次选择的任务,支付了高昂的自回归生成成本。Jev通过封闭输出空间,在接口层面结构性消除了类型错误。
二、 降本增效的底层逻辑:一次读取,并行评估
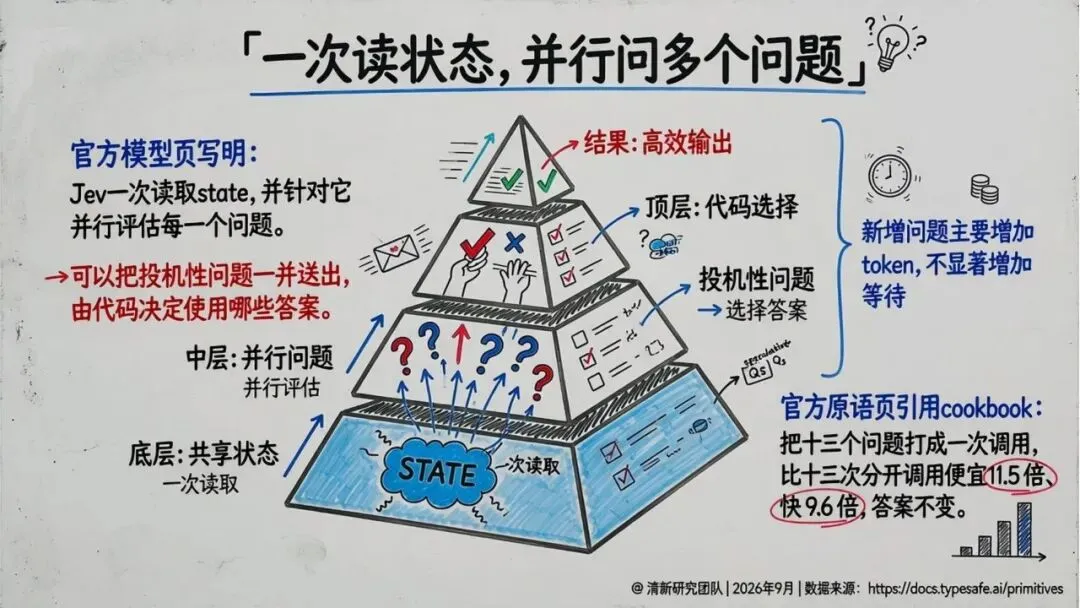
除了输出端的变革,Jev在输入端也做出了极为务实的创新:共享状态(State)+ 并行问题。
想象一个场景:同一张客服工单,你需要判断它是否涉及退款、是否需要转人工、情绪是否激烈。传统LLM需要把工单喂进去3次,生成3次回答。而Jev一次性读取state,并行评估所有问题。
官方数据非常诱人:把13个问题打成一次调用,比13次分开调用便宜11.5倍,快9.6倍,且答案不变。这不仅把“概率”变成了可执行的API接口,也让AI真正有了软件级的响应速度。
三、 冷静的边界感:零非法输出,不是零幻觉
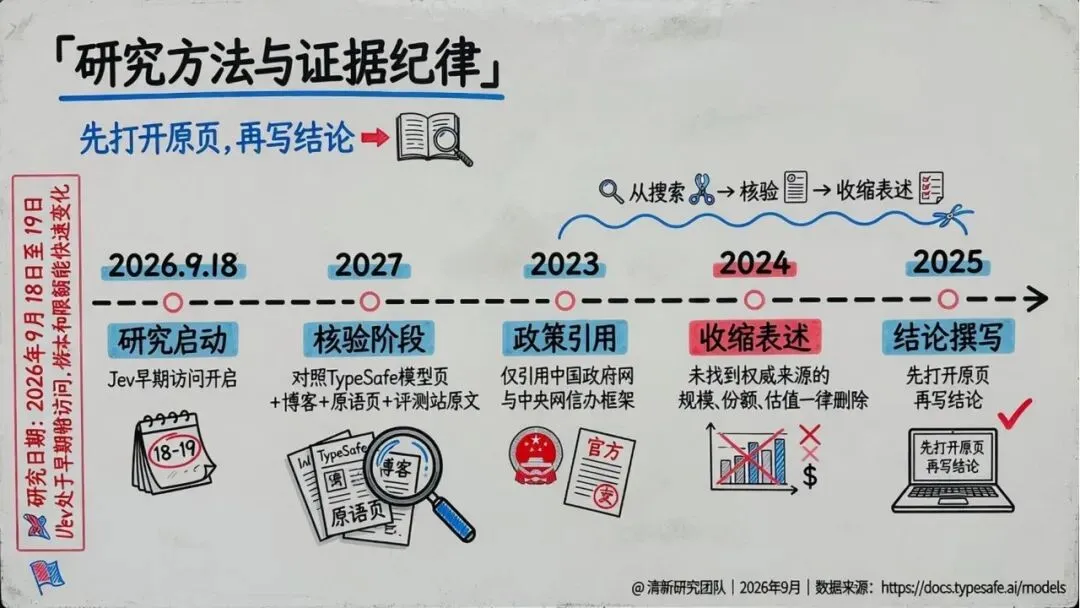
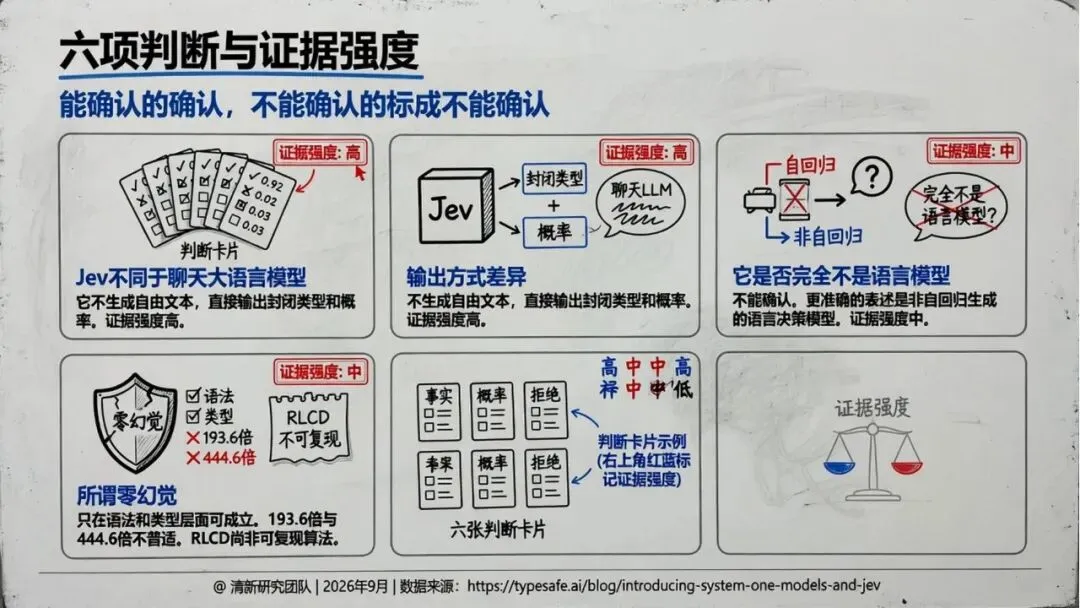
这份报告最让人赞赏的,是它的“证据纪律”。
官方明确承认:零非法输出 ≠ 零幻觉。 它虽然不能返回无法解析的字段、非法枚举或格式乱码,但它依然可能“以极高的概率支持错误的合法判断”。
文档甚至坦然地列出了九类失败模式,包括长状态干扰、多跳推理、数学计数、日期比较等。官方直言:遇到数学和日期,不要指望Jev,交给代码去算。
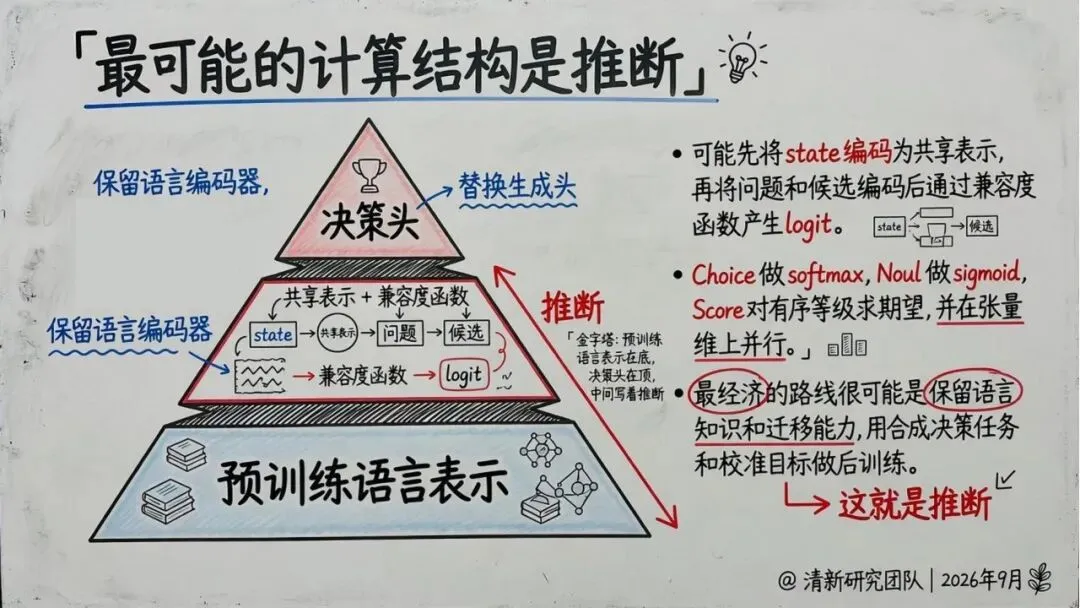
Jev的定位非常清晰:它是一个“神经条件分支”,而不是一个完整的大脑。 它可以成为自进化系统里的“高速反射层”,但不能替代强模型去做规划、写作和复杂推理。
四、 未来的四层计算栈
报告在最后提出了一个值得所有AI架构师深思的“四层计算栈”:
发现层:强生成模型提出新问题和新流程。
判断层:Jev等决策模型做高频语义判断(高速反射)。
执行层:程序做算术、约束和动作。
验证层:真实结果测量残差并回流。
在这个架构里,我们不再追求用一个庞大的LLM解决所有问题,而是按信息形态分配模型,把稳定的能力编译到更便宜的执行层。
结语
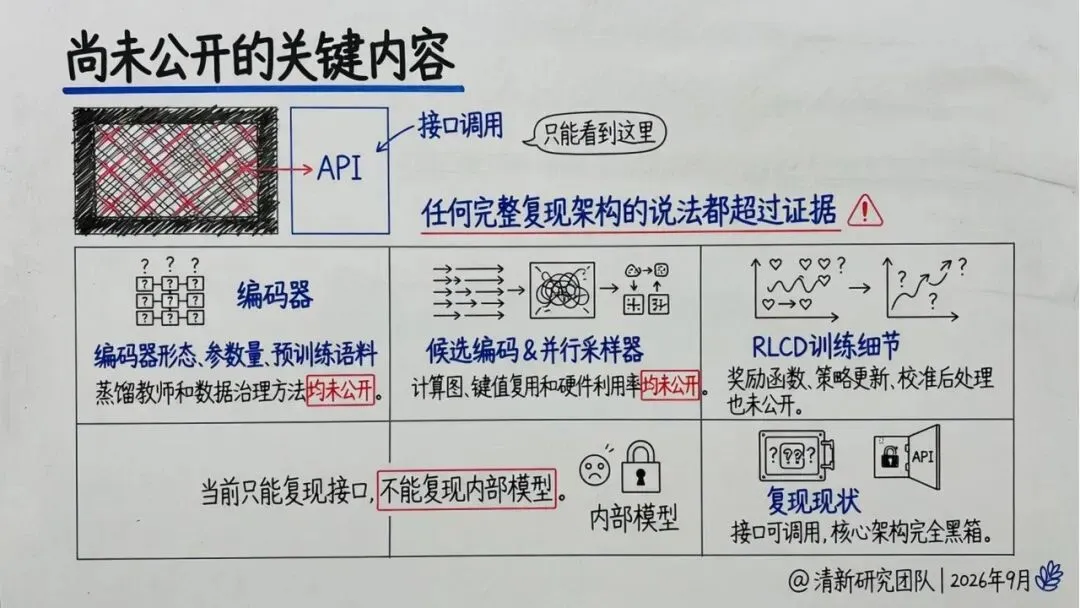
Jev 1.13目前仍处于早期阶段,核心架构完全黑箱,RLCD训练细节尚未公开。但它的出现提供了一个极具价值的新范式:把不确定的语义判断,转化为确定性代码可调用的概率。
承认接口革命,拒绝盲目崇拜。或许,企业真正需要的,从来就不是一个更会聊天的AI,而是一个能在几毫秒内给出精确概率分布、让软件自己去做决定的“决策引擎”。

发表评论
发表评论: