
 研报速递
方 法 研 究 报 告 · 2026
同一份财务数据,1968 年算出一条判别函数;今天同一件事可以用一行 SQL 完成。这中间变的到底是数学,还是算得动的边界?
出品 QIAN数据 · AI工具实验室
日期 2026年9月
证据口径 论文原文 / 官方文件 / 软件官方史料(1930s—2026)
读完这篇你应该拿走三条判断
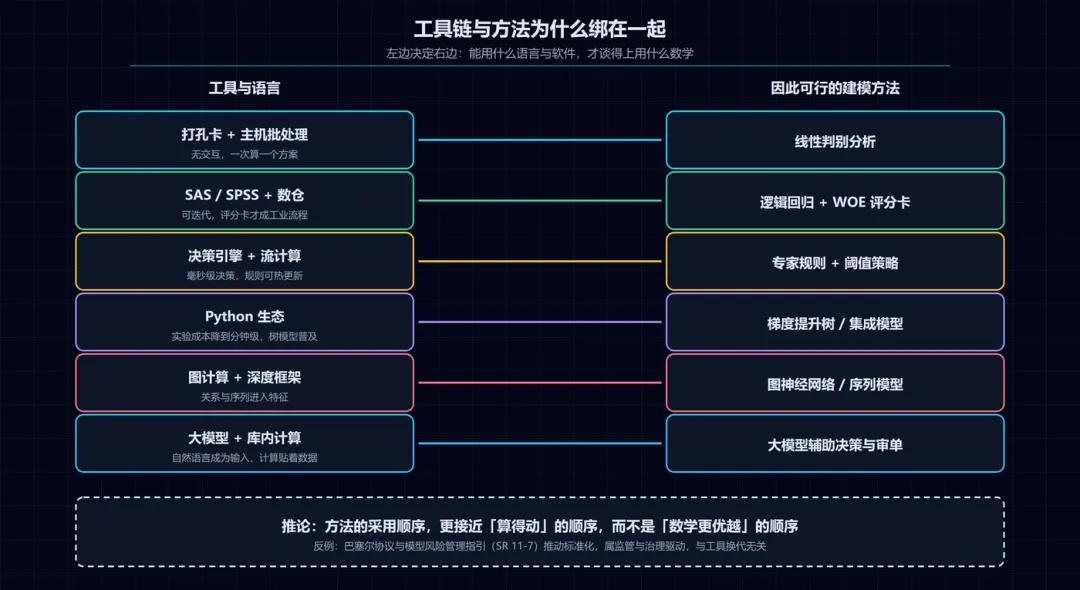
- 方法的换代顺序,更接近"算得动"的顺序。
1968 年多变量判别分析就已经把破产预测准确率做到 95%(样本内,63/66),可作者在论文里自己写明:银行家与信贷经理通常没有机会使用这类计算机程序——于是他把模型降级成两个临界值(1.81 与 2.99)供人手工查表。方法没落后,是工具没到位。 - 每一次新方法被大规模采用,前面都先有一次工具链换代。
统计软件(SAS 1976 起对外授权)让评分卡变成可迭代的工业流程;决策引擎(Drools 2001 创立、PMML 1997 提出)让模型与代码解耦;Python 生态(scikit-learn 2011 发表)把实验成本压到分钟级——梯度提升树才从竞赛走向生产。 - 工具不是唯一驱动力,这条要单独记住。
巴塞尔新资本协议(2004 年 6 月)让银行自建 PD/LGD/EAD 模型合法化,美联储与 OCC 的 SR 11-7(2011 年 4 月 4 日)把"有效挑战"写进治理要求——这两次推动来自监管与治理,与工具换代无关。把方法史全部归因于技术,会看错一半。
怎么读这篇报告
风控数据分析方法的历史,常见的写法是编年体:某年出了什么方法,某年又出了什么方法。这种写法读起来顺,但读完记不住——因为看不出规律。
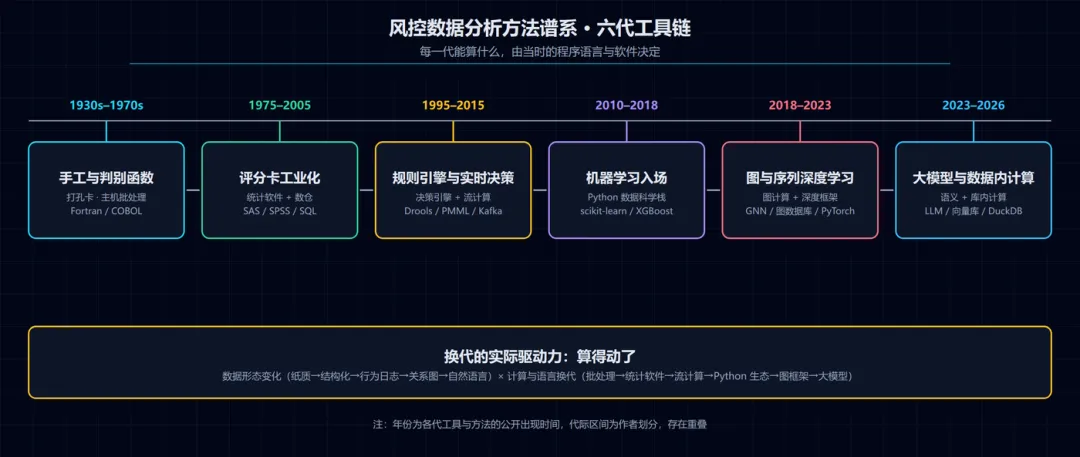
本篇换一种组织方式,用两条轴交叉来看。
纵轴是六个时代,每个时代都统一回答同样四个问题:当时手里有什么数据、用什么程序语言与软件在算、数学内核是什么、这一代解决不了什么。四栏对齐摆开,代际差异一眼可见。
横轴是风控的四个核心动作:选变量、定阈值、看监控、做解释。这四个动作在任何时代都存在,但做法一直在变。把四个动作放进六个时代,就得到一张"动作 × 代际"的演进矩阵——这张表才是本报告的信息密度所在。
一句话说明本报告主张什么、不主张什么
主张:工具链的可及性,长期决定了一个方法能不能真正落地,以及它以什么形态落地。
不主张:工具是唯一因素。监管要求(巴塞尔新资本协议)、治理规范(SR 11-7)、业务成本结构同样在推动方法变化,文中会在对应位置单独标注。
第一代 · 手工与判别函数(1930s–1970s)
第 一 代
手工与判别函数时代
工具标签:打孔卡 · 主机批处理 · Fortran / COBOL · 机械计算器
①数据形态
纸质账本与年报。研究者要手工从年报里抄财务比率,样本规模受限于能不能抄得完。
②工具链
统计计算靠机械计算器与手算;程序语言层面,银行核心业务用 COBOL,科研计算用 Fortran,运行方式是主机批处理——提交一次任务,等结果出来。1968 年 SPSS 首个版本发布(作者 Norman H. Nie 等),此后统计计算才逐步从"会编程的人才能做"变成"研究者也能做"。
③数学内核:多变量判别分析
1968 年,Edward Altman 在《金融杂志》发表论文,用多变量判别分析(MDA)把五个财务比率加权成一个分数,用来预测企业破产。原始样本是 1:1 配对的 66 家公司(破产组与非破产组各 33 家)。
数据来源:Altman, E. I. Financial Ratios, Discriminant Analysis and the Prediction of Corporate Bankruptcy, The Journal of Finance 23(4): 589–609, 1968。上述准确率为样本内结果(系数与分组由该样本导出);原文另设二次样本做检验,其中 14 家误判企业的 Z 值有 10 家落在 1.81 至 2.67 之间。同期 Beaver(1966)用单变量比率做破产预测,论文载于《会计研究杂志》4: 71–111:样本为 79 家失败企业(其中 59 家破产)配 79 家同行业、规模相近的对照企业,共 158 家,年份区间 1954–1964;从 30 个财务比率中筛出 6 个表现最好的,其中现金流/总负债比率在失败前 1 年可正确分类 87%~90%、前 5 年约 78%。(Beaver 原始数据、Altman 原文二次样本、Beaver 准确率均转引自 Collins 1992 年弗吉尼亚理工硕士论文《EVALUATION OF A FINANCIAL DISTRESS MODEL FOR DEPARTMENT OF DEFENSE HARDWARE CONTRACTORS》第 15–26 页,该论文逐项复核了这两个经典研究。)
这一代最有价值的一条原始证据
Altman 在论文里专门写了一段话,解释为什么要给出 1.81 与 2.99 这两个固定值:"银行家、信贷经理、高管与投资者通常没有机会使用这类计算机程序……因此下面描述的方法可用来选定一个临界值,使预测无需计算机支持。"
判别分析在数学上是可行的,但当时使用者的手上没有可用的计算工具。方法被折成一张可以手工查表的临界值表——这就是"工具的边界决定了方法的落地形态"最早的一次清楚记录。
④这一代解决不了什么
样本量受制于手工抄录;变量选择靠人工判断;判别分析对变量分布有假设,遇到分类变量与非线性关系就不好处理;而且模型本身不能给出各变量影响的方向强度,只能给出一个总分。这些问题把方法推向第二代。
第二代 · 统计建模与评分卡工业化(1975–2005)
第 二 代
统计建模与评分卡工业化时代
工具标签:SAS / SPSS · SQL 与数据仓库 · 批处理跑分
①数据形态
从纸质账本转向结构化数据库。评分卡需要的不是几份年报,而是几十万条账户级的还款表现记录——这类数据只有在数据库里才存在。
②工具链:统计软件与数仓
1960 年代末,美国南部八所大学联合开发了一套用于农业数据分析的统计软件;1976 年 3 月,北卡州立大学授权 SAS 研究所对外销售,这套工具从此进入商业机构。数据库侧,1979 年成立的 Teradata 在 1984 年向富国银行交付了首台数据库计算机——银行开始有了能装下全量账户数据的机器。
这两个变化合起来,让"反复迭代一版评分卡"第一次成为日常工作:统计软件负责建模,数仓负责供数,两者都是可以反复调用的。
③数学内核:逻辑回归 + WOE 分箱
逻辑回归的原始论文出自 Cox(1958,*Journal of the Royal Statistical Society* 系列 B 21(2)),它相对判别分析的优势在于输出是概率、系数方向可读。行业内的通行说法是它在 1980 年代成为信用评分的主流方法——需要说明:这一时间点来自研究综述的转述,本次未核到某一篇文献明确宣布"某年起主流换为逻辑回归",因此本报告不把年份当作定论。
配套的特征处理方式叫 WOE(证据权重)与 IV(信息值)。把变量分箱后计算每箱的 WOE,再用 WOE 值替换原始值进入模型,好处是兼顾非线性与单调性,同时天然处理缺失值。
关于 WOE / IV 的一条诚实说明
业内流传的 IV 分档阈值(例如低于 0.02 视为几乎无区分度、0.1 以上为中等、0.3 以上为强、0.5 以上需警惕过拟合)本次未查到学术原始出处。它可以被当作行业经验值使用,但不宜引用为"某文献规定"。WOE 与 IV 的数学形式可追溯到信息论中的证据权重概念,其在信用评分中的标准化用法,同样未见单一创始文献。
数据来源:国际清算银行(bis.org)巴塞尔委员会公开文件;美联储官网 SR 11-7 原文(2011 年 4 月 4 日,全文核)。
④这一代解决不了什么
评分卡擅长排序,不擅长即时响应。银行需要的是审批当下就给出结论、策略调整要当天生效、名单和规则要能随时投放——这些都是批处理跑分的形态给不了的。于是注意力转向决策系统。
第三代 · 规则引擎与实时决策(1995–2015)
第 三 代
规则引擎与实时决策时代
工具标签:决策引擎 · PMML · 流计算(Kafka / Spark / Flink)· SQL
①数据形态
从"账户的历史表现"扩展到"当前正在发生的动作":一笔交易、一次登录、一个申请请求。数据开始要求秒级甚至毫秒级可用。
②工具链:把策略从代码里拆出来
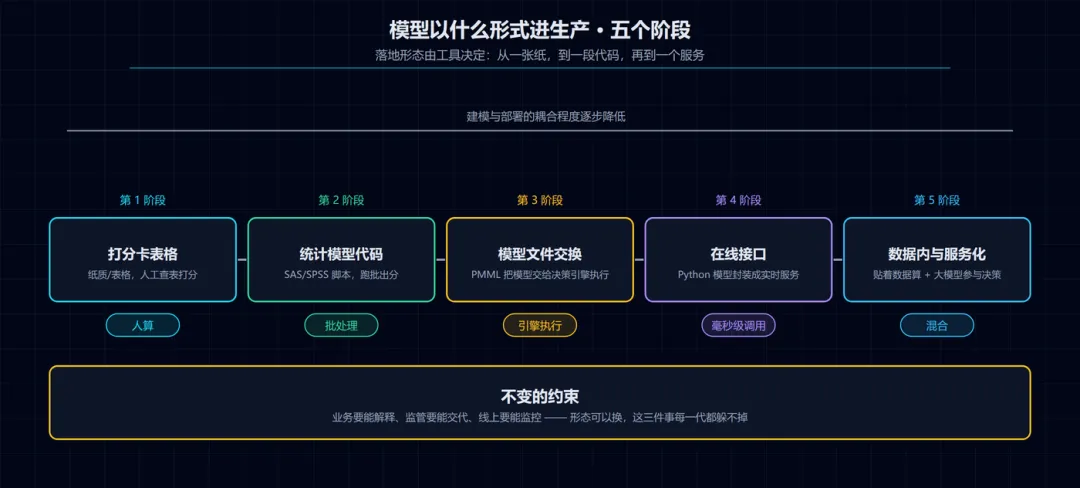
这一代最重要的工具变化不是算力,而是关注点分离。过去改一条风控规则要改代码、要走发布流程;决策引擎把策略变成可配置的规则文件,改策略不再等于改程序。
数据来源:DMG 官网 PMML 文档;KIE 社区(Red Hat)官方博客;USENIX HotCloud 2010 论文;LinkedIn 工程博客开源公告;Apache 孵化器官方项目页。PMML 部署耗时的 4~6 个月为 TMDB/TDWI 刊载的行业表述。
③数学内核:规则 + 阈值 + 模型分
这一代的方法论特征是分工:模型负责把复杂关系压成一个分数,规则负责把分数与业务约束组合成决策。常见形态是"模型分 + 规则条件 + 名单"三件套,例如模型分低于某档且命中某类名单则拒绝。
策略上线普遍采用冠军挑战者机制:新策略与现行策略并行跑,用真实表现对比,确认优于现行策略才切换。这套做法把"策略迭代"变成了一件可以持续做、且风险可控的日常工程。
④这一代解决不了什么
规则的增长会带来维护压力:规则越多、互相重叠与冲突的概率越高,一条规则改动影响哪个人群越来越难判断。规则能表达"如果 A 且 B 则拒绝",但表达不了"这个人整体看起来像不像风险"这类隐含在高维特征组合里的判断。于是开始有人把梯度提升树这类模型引入生产。
第四代 · 机器学习入场(2010–2018)
第 四 代
机器学习入场时代
工具标签:Python 生态 · scikit-learn / XGBoost / LightGBM · 可解释性工具
①数据形态
从"若干张表"变成"很多张表"。以公开的消费信贷数据集为例,主申请表已有 30 万余条记录、122 个字段;而同一份数据配套的历史申请、征信查询、分期还款等辅表加在一起,能构造出上百个特征维度。
②工具链:实验成本降到分钟级
这一代真正的门槛降低发生在工具层。2011 年 scikit-learn 论文发表于《机器学习研究杂志》,其定位写得很直白:把机器学习带给非专家。这句话是理解这一代的关键——在这之前,试一个模型需要相当多的工程准备;在这之后,一次实验的成本降到以分钟计。
数据来源:JMLR 官网论文页;arXiv 与 KDD/NeurIPS 论文原文摘要;Databricks 官方博客。
一个真实赛事作为这一代的横截面
2018 年的公开信贷违约预测竞赛有 7,198 支队伍参赛,冠军方案的核心是大量特征工程加梯度提升树的集成交叉验证;一位单人参赛者的私榜 AUC 为 0.80265(第 17 名,为单人最高)。这个数字本身说明一件事:在真实信贷数据上,AUC 的绝对水平是有天花板的,模型换代的收益并没有想象中那么戏剧化——真正的差距更多来自特征与数据,算法名字本身给不了多少。
③数学内核:集成树 + 正则化
梯度提升树的思路是"一串弱模型叠加,每一棵新树去拟合前面残留下的误差"。它天然处理非线性与特征交互,对缺失值和量纲也不敏感——这正是不需要人工分箱就能获得好效果的原因,也是它取代 WOE + 逻辑回归流水线成为竞赛首选的原因。
④这一代解决不了什么
三个问题在这一代充分暴露。
第一是可解释性:树模型能给出特征重要性,但给不出"这个人为什么被拒"这样的单条理由,而业务与监管都要这个答案,SHAP 与 LIME 是为补这个缺口出现的。
第二是稳定性:模型上线后的表现会随着客群与政策变化漂移,需要监控手段。
第三是特征本身的表达力:树模型处理的是行与列,处理不了"这个人跟那批人是什么关系"这类信息。
第五代 · 图与序列(2018–2023)
第 五 代
图与序列深度学习时代
工具标签:图神经网络 · 图数据库 · 深度学习框架
①数据形态
数据不再只是一张表,而是网络与序列。同一台设备多用、同一批联系人互相担保、资金在几个账户之间来回流转——这类风险信号只存在于关系里,落在单行记录上是看不见的。
②工具链:从表格到图结构
建模工具随之扩展:图神经网络框架、图数据库、以及深度学习框架进入风控技术栈。这一代与前几代最大的不同是,数据组织方式本身成了建模的一部分——要建模先要建图,而建图需要新的存储与查询工具。
③数学内核:邻域聚合
图神经网络的核心操作是让每个节点聚合邻居的信息,从而让"孤立点"获得位置感。一个申请人的风险评分,不只取决于他自己的特征,还取决于他周围节点的特征。
但这一代也很快暴露了自身的问题。2020 年的一篇研究指出,欺诈者存在特征伪装与关系伪装行为:他们会刻意让自己的特征看起来正常,也会刻意与高风险节点保持距离,这使得标准的邻域聚合方法在欺诈检测上表现不佳。该研究提出的改进模型正是针对这两类伪装设计的。
④这一代解决不了什么
图方法的工程成本高(要维护图、要做关系特征、算力开销大),解释起来比树模型更难;更关键的是,它把可解释性的难度又提高了一层——当结论来自邻居的聚合,单条理由就很难讲清楚。同时,序列与深度模型对数据的量与时效要求都很高,很多机构的数据条件并不满足。
第六代 · 大模型与库内计算(2023–2026)
第 六 代
大模型与数据内计算时代
工具标签:大模型 · 向量表示 · 嵌入式分析数据库(DuckDB 等)
①数据形态
出现了一类过去无法直接计算的数据:自然语言。合同文本、尽调报告、客服记录、投诉工单——这些材料一直都在,但因为无法结构化,长期以来只能靠人读。
②工具链:两个方向同时变化
第一个方向是计算贴着数据走。2019 年 SIGMOD 会议上发表的嵌入式分析数据库(CWI 阿姆斯特丹)明确采用了向量化解释执行引擎而非即时编译,理由是便携性——即时编译依赖大型编译器库与传递依赖。这类工具的实践含义很直接:分析不再需要先把数据搬到另一个系统,一台笔记本上就能对千万行数据做交互查询。
第二个方向是语义进入模型。文本不再必须先变成结构化字段才能参与判断,可以用语义表示直接进入流程。
③数学内核:表示学习与概率校准
这一代的数学重心从"构造特征"转向"学习表示",同时带来一个老问题的新形式:大模型的输出是生成式的,它的判断需要被校准成可比较的概率,才能和阈值、成本矩阵这些传统工具对接。这一步没做,模型就无法与既有决策体系接轨。
④这一代解决不了什么
三个问题目前都还没有公认的答案。
可靠性:生成式模型存在输出不一致与事实性错误的风险,而风控决策要求可重复。
可解释性:深度模型的解释仍是事后近似,把这类模型用在高风险决策上,如何满足既有的模型验证要求尚无成熟范式。
合规框架:欧盟人工智能法案于 2024 年 8 月生效并分阶段适用,其中附件三把信用评估列入高风险系统,相关义务自 2026 年 8 月 2 日起适用——合规约束正在从原则性要求转向可检查的具体条款。
横向看:四个动作在六代里怎么变
纵向六个时代看下来,容易觉得"技术在进步"。横向把四个动作单独拎出来看,会看到一些不那么线性的东西。
① 选变量:从人工经验挑比率(第一代),到 WOE/IV 按统计量筛选(第二代),再到树模型自动完成特征组合(第四代),最后到语义表示让文本直接成为输入(第六代)。趋势是人工介入的位置在不断上移——从"挑哪个变量"上升到"数据里有没有这个信息"。
② 定阈值:第一代是用固定临界值(1.81 / 2.99)手工查表;第二代转向按业务成本与 KS 最大处选点;第三代把阈值写进决策规则与成本矩阵;第四代引入概率校准与代价敏感;到第六代,阈值问题变成了"人机如何分工"。值得注意的是第一代的临界值至今没被淘汰——它简单、可手工执行、无需系统支持,在尽调这类低频场景里仍然够用。老的未必被替代,很多时候只是退到了特定的场景里。
③ 看监控:从人工复盘(第一代)到 PSI、KS 的月度报表(第二代),再到实时流式告警(第三代)、漂移检测工具(第四代)。监控这一项变化的驱动力与其他三项不同:它主要不是被工具推着走的,而是被监管与治理要求推着走的。SR 11-7 把有效验证与治理写进要求之后,监控才从"做得好加分"变成"必须做"。
④ 做解释:这是六代里变化最慢、也最没解决的问题。评分卡天然可读(第一、二代),树模型需要 SHAP 之类的工具来补(第四代),图模型与深度模型的解释至今仍以事后近似为主(第五、六代)。一个反直觉的观察:模型的表达能力越强,可解释性反而越差,而业务与监管对解释的要求这几十年是在变严的。这个矛盾正是当前风控建模最真实的约束。
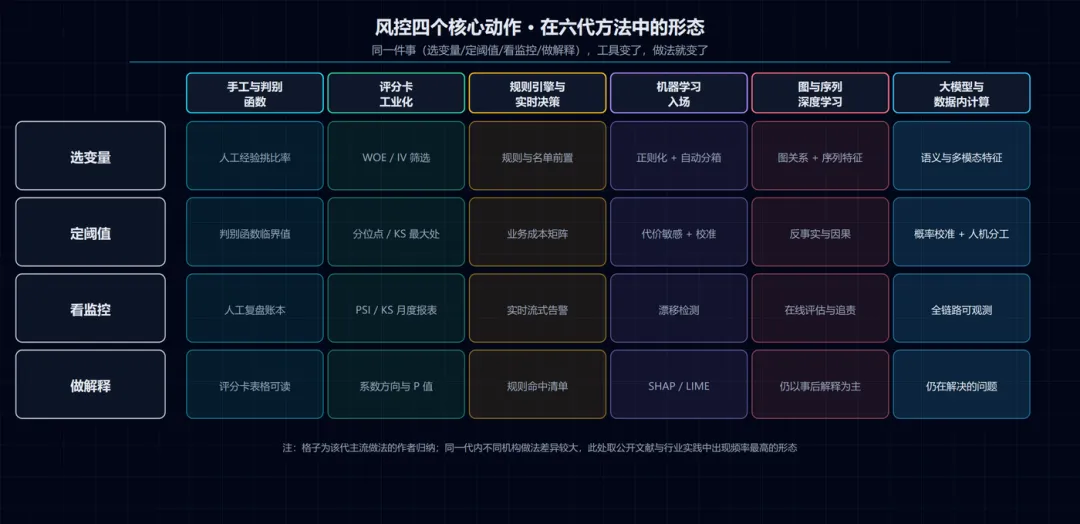
把四栏放在一起,能看出一个规律
选变量与定阈值这两件事,受工具推动最明显——工具换代之后做法立刻变。而看监控与做解释这两件事,受治理要求推动更明显——工具换代了,做法也没马上变,直到有人要求你必须能证明模型有效、必须能解释单条决策。
所以"方法论演进"实际上是两条线在同时走:技术线(能不能算)与治理线(允不允许这么算)。只讲技术线,是讲不完这段历史的。
方法选择的决策表与边界
前面几节讲的是历史。落到今天做什么选择,可以把六个时代压成一张对照表。
本表为本报告基于前述公开文献与工具史料的分析归纳,不构成方法选型建议。具体选择应结合机构的数据条件、监管要求与业务成本结构。
这张表想表达的不是"新方法更好",而是方法的适配取决于约束条件。同一家机构里,申请审批、贷后监控、反欺诈、尽调这几个场景用的方法往往分属不同"代际"——这不是落后,而是各自约束不同导致的合理结果。
给读者的三条可操作判断
1)先问工具与数据,再问模型。如果一次实验的反馈周期是两周,那么再先进的算法也迭代不出结果;如果数据里根本没有关系类信息,图方法无从谈起。判断一个方法在这个环境里有没有可能落地,先看这两件事。
2)把"能不能解释"当成一等的技术约束,别当成上线前补的补丁。六代方法史里,解释这一项几乎是唯一没有变好的指标——它需要在建模阶段就设计进去。
3)区分"技术推动"与"治理推动"的两类变化。前者影响你怎么建模,后者影响你做了什么才被允许上线。只跟进前者,容易在实际评审环节卡住。
结论与边界
本报告的边界
证据口径:本报告的事实层证据来自论文原文(Altman 1968 全文、Cox 1958、XGBoost/LightGBM/CatBoost/LIME/SHAP 原文摘要、DuckDB SIGMOD 2019 论文)、监管与官方文件(巴塞尔委员会公开文件、美联储 SR 11-7 原文全文)、软件与工具的官方史料(SAS、DMG、KIE、Apache 孵化器、LinkedIn 工程博客、Databricks、微软、Evidently 官方博客)。
代际划分为作者归纳:六个时代的年份区间是作者为组织材料所做的划分,彼此存在重叠(例如评分卡工业化与规则引擎在时间上长期并存)。真实行业实践中,多个代际的方法同时在使用,这一点比划分本身更重要。
明确未采用的信息:业内广泛流传的 IV 分档阈值未查到学术原始出处,正文已明确标注为行业经验值;逻辑回归在信用评分中成为主流的具体年份仅见研究综述转述,未核到原始文献,故未作为定论;本报告未引用任何无法回溯原始出处的市场规模、市场份额类数据。
反例已单列:巴塞尔新资本协议与 SR 11-7 对方法的推动来自监管与治理,与工具换代无关,正文在对应位置单独标注,以免把方法史简化为技术决定论。
不含建议性质:本报告为公开文献与史料的整理与分析,不构成方法选型建议、投资建议或合规意见。
AI 辅助声明:本报告在文献检索、资料整理、图表绘制与文字组织环节使用了 AI 工具辅助。文中引用的年份、数字与条款表述均来自论文原文、官方文件与软件官方史料,并已逐项回原文核对;凡未能回溯原始出处的数据,正文已标注或未予采用。分析框架与判断由人工确定。如有事实性错误,欢迎指出,将据实更正。






发表评论
发表评论: